Data Structure - 王道
第一章 绪论
1.1数据结构的基本概念
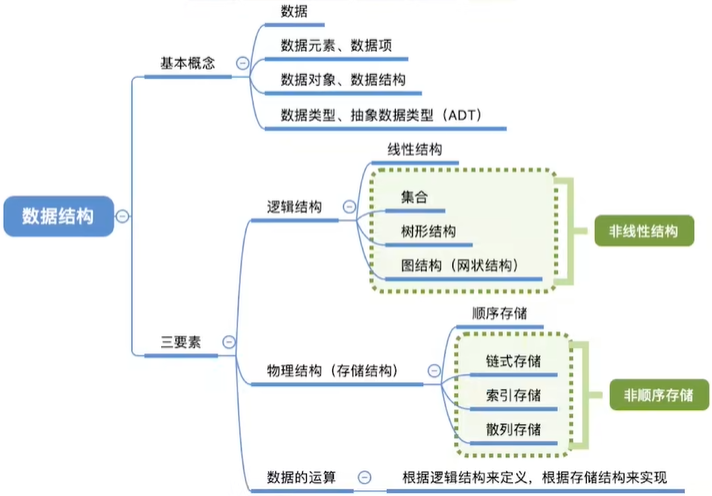
在探讨一种数据结构时:
①定义逻辑结构(数据元素之间的关系)
②定义数据的运算(针对现实需求,应该对这种逻辑结构进行什么样的运算)
③确定某种存储结构,实现数据结构,并实现一些对数据结构的基本运算
1.2算法和算法评论
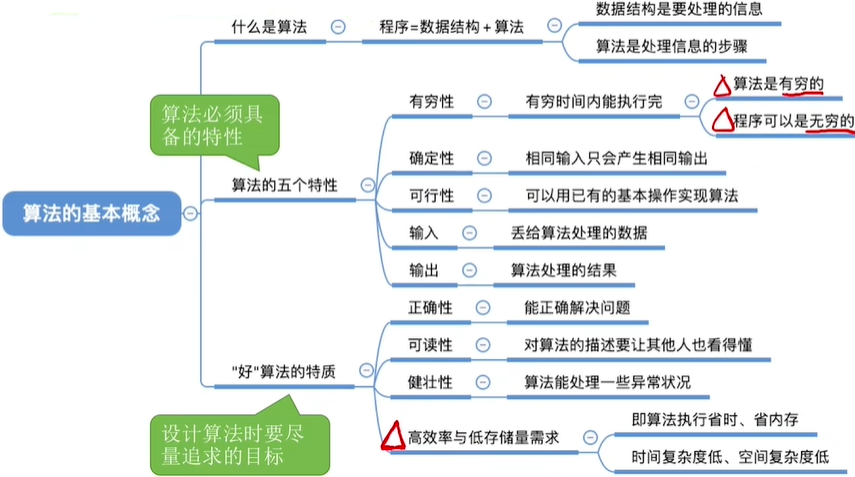
1.2.1算法的基本概论
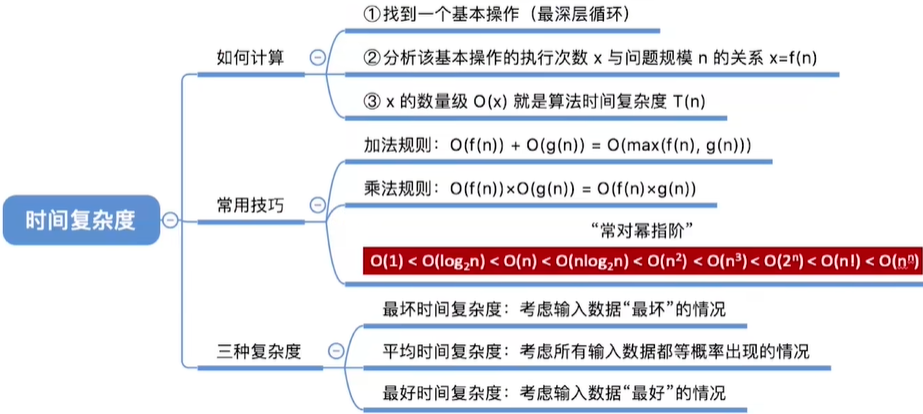
1.2.2算法的时间复杂度
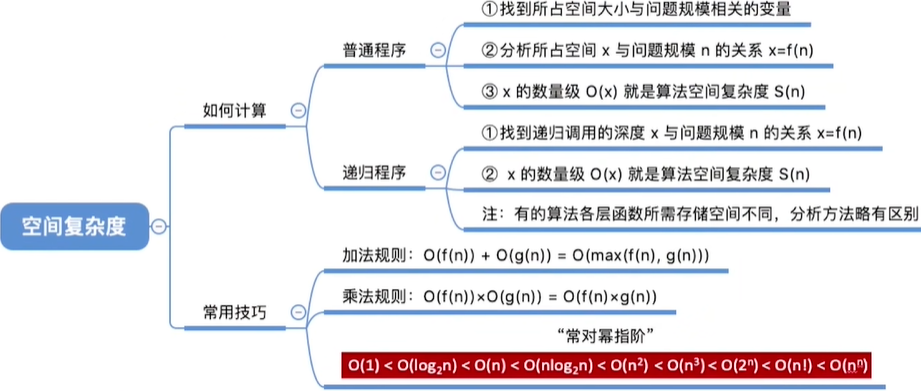
1.2.3算法的空间复杂度
第二章 线性表
2.1线性表的定义和基本操作
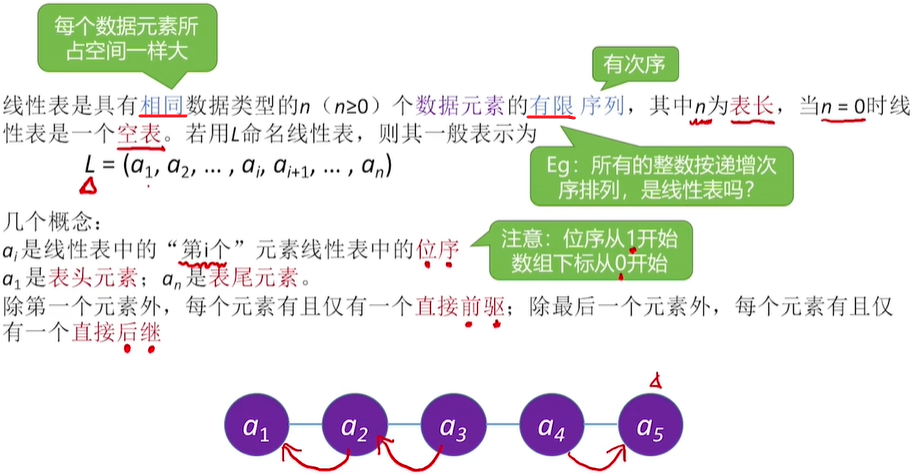
2.1.1线性表的定义
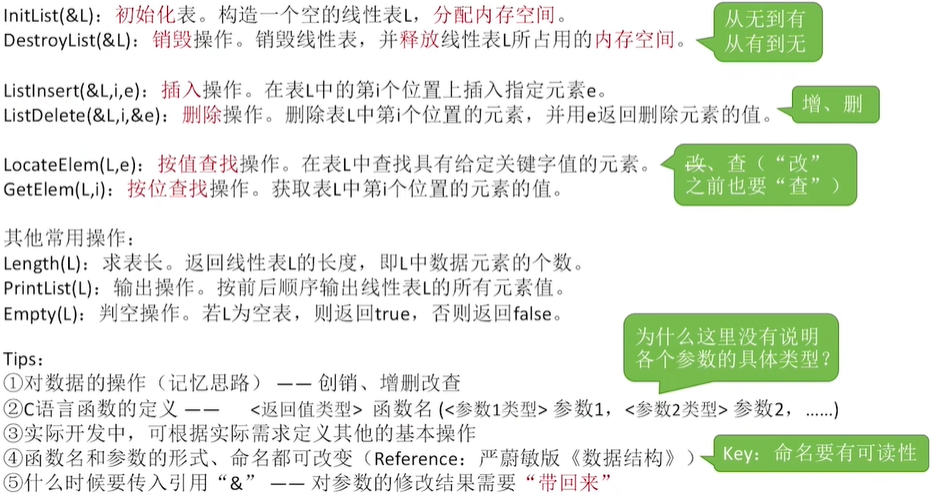
2.1.2线性表的基本操作
2.2线性表的顺序表示
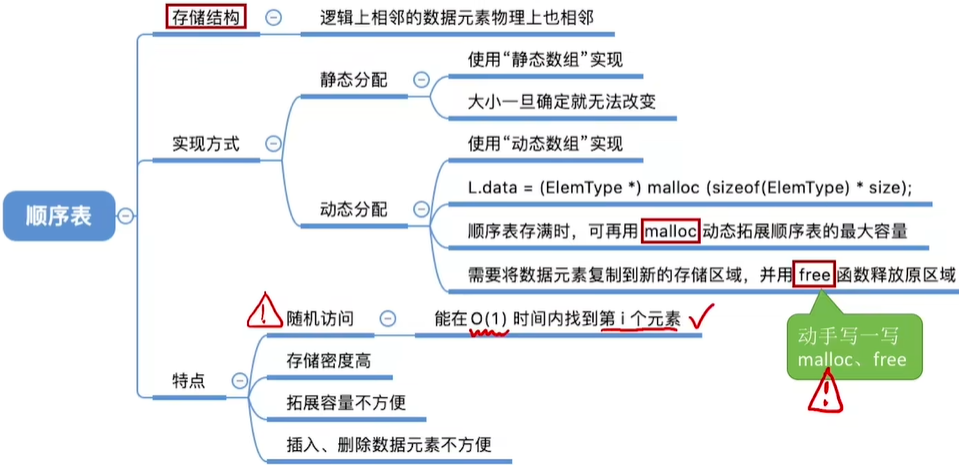
2.2.1顺序表的定义
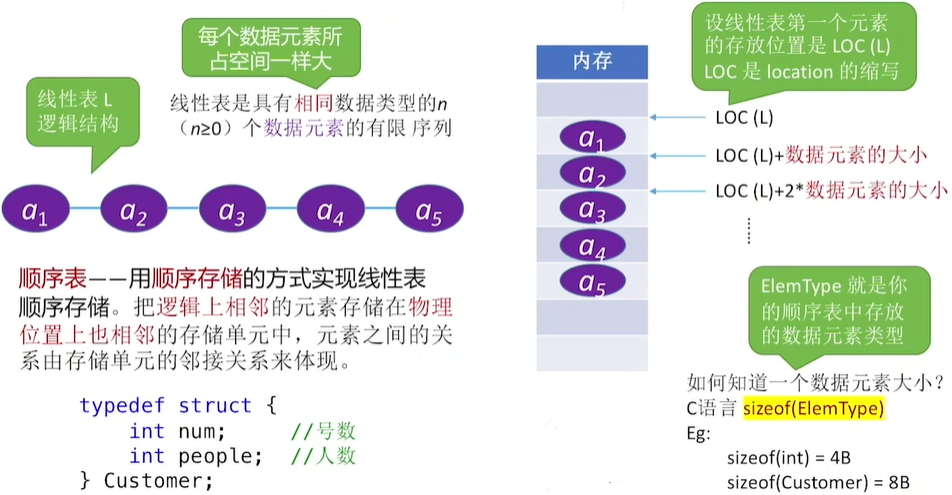
1、静态分配
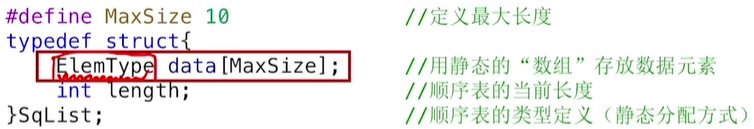
表长无法改变
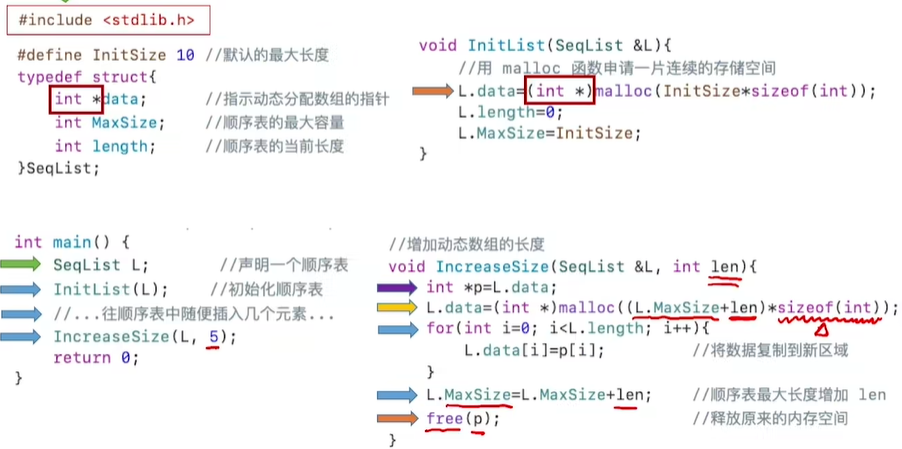
2、动态分配
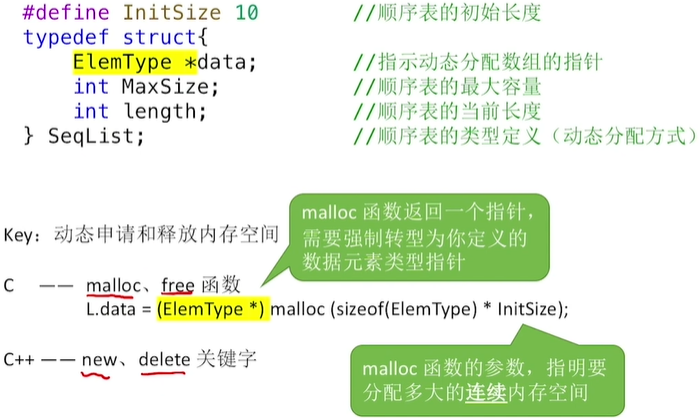
动态分配表长扩展
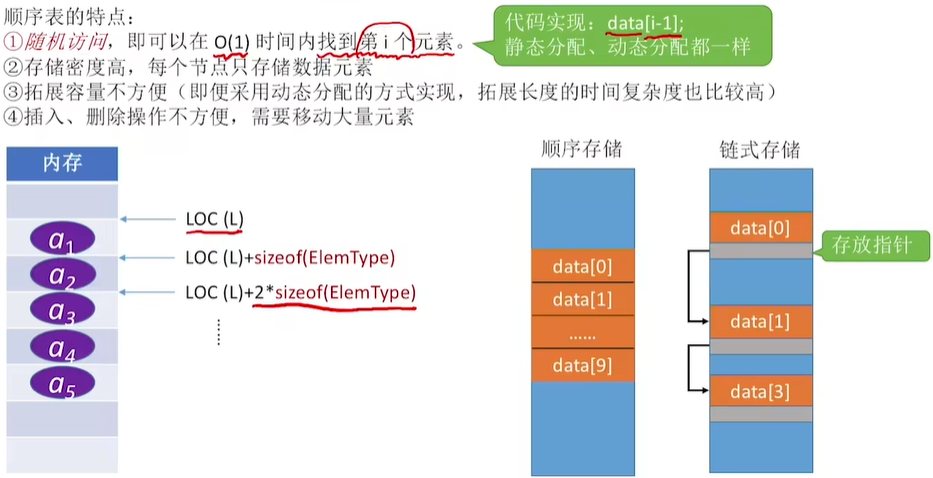
顺序表的特点
总结
2.2.2顺序表上基本操作的实现
1、插入
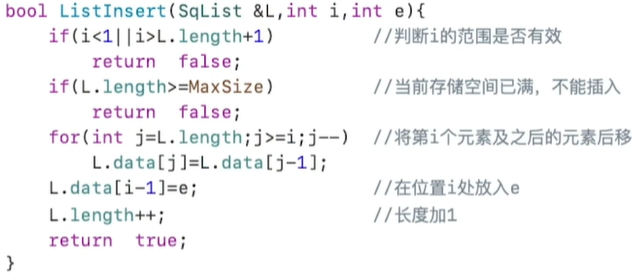
时间复杂度O(n)
2、删除
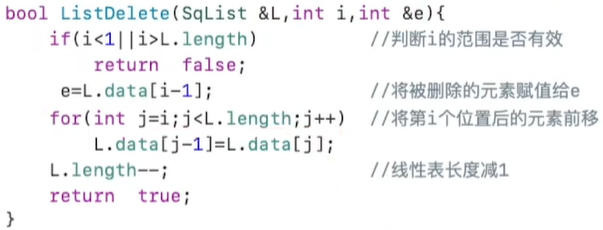
时间复杂度O(n)
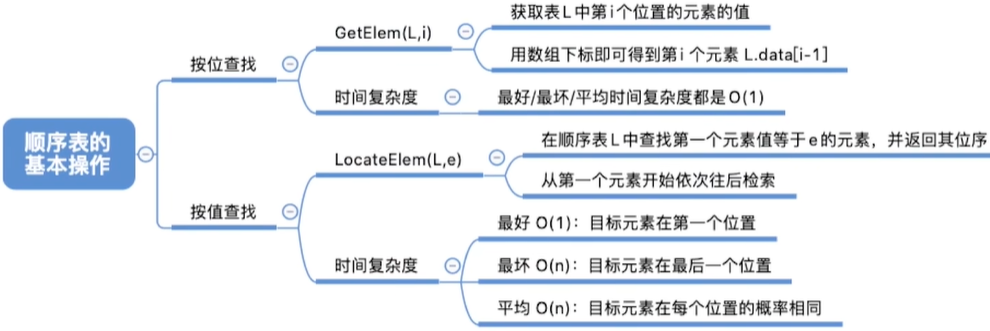
3、查找
3.1、按位查找
GetElem(L, i):按位查找。获取表L中第i个位置的元素的值。
1 | ElemType GetElem(SqList L, int i){ |
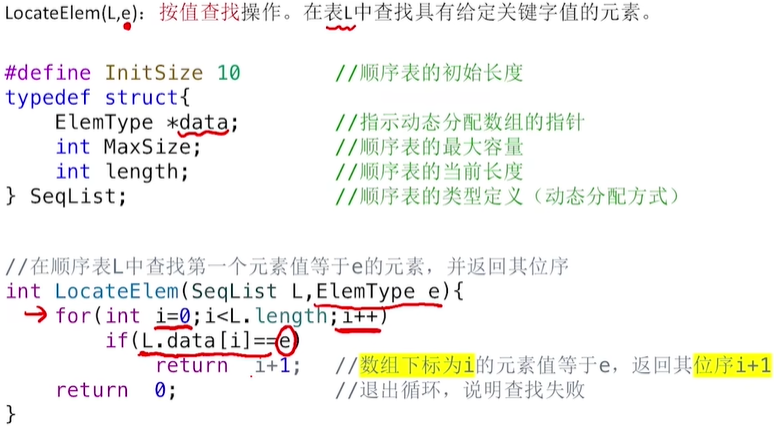
3.2、按值查找
总结
2.3线性表的链式表示
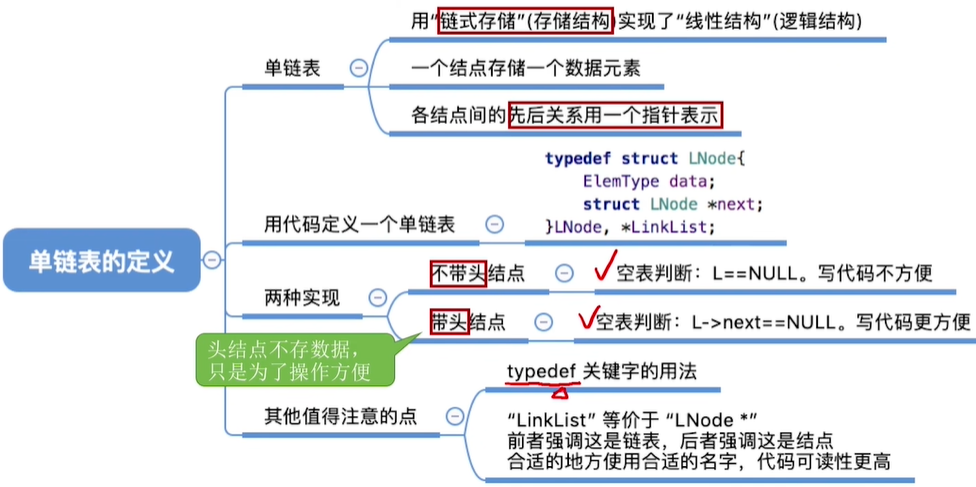
2.3.1单链表的定义
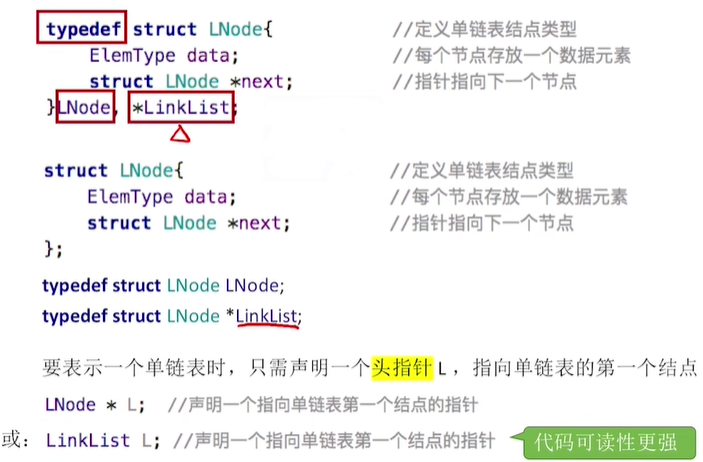
强调这是一个单链表:使用LinkList
强调这是一个结点:使用LNode *
总结
2.3.2单链表上基本操作的实现
1、插入
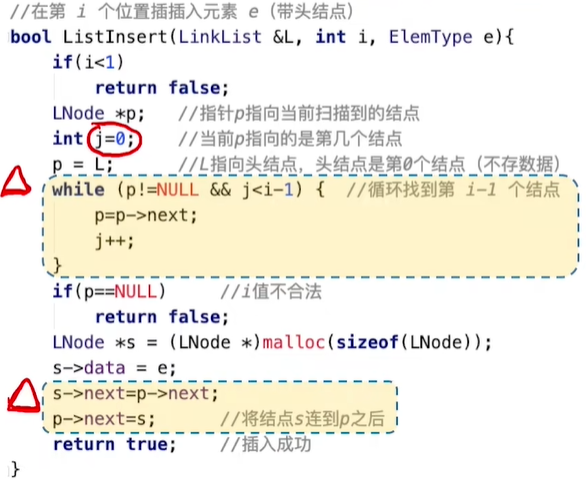
时间复杂度O(n)
前插操作
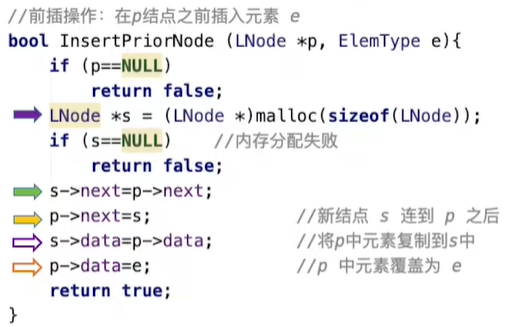
时间复杂度O(1)
后插操作
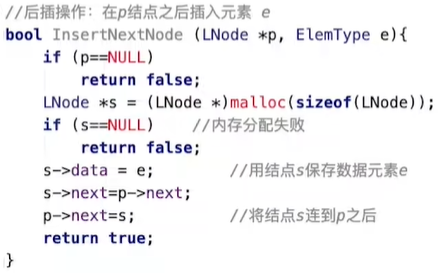
时间复杂度O(1)
2、删除
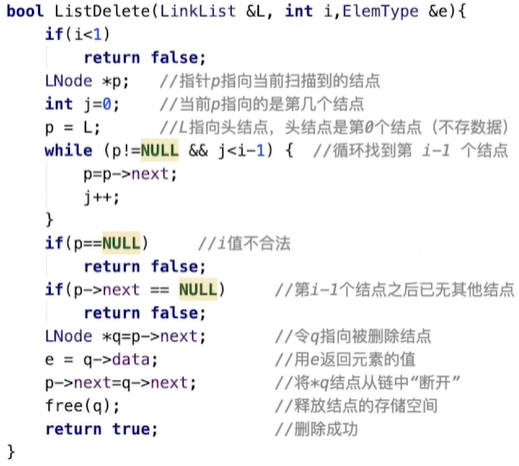
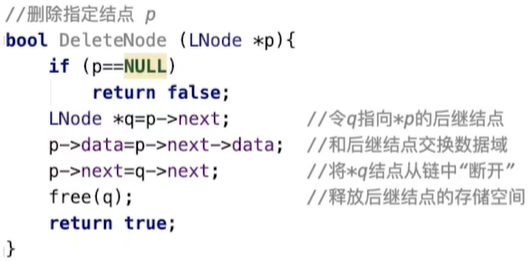
当p为最后一个结点时会出错
3、查找
3.1、按位查找
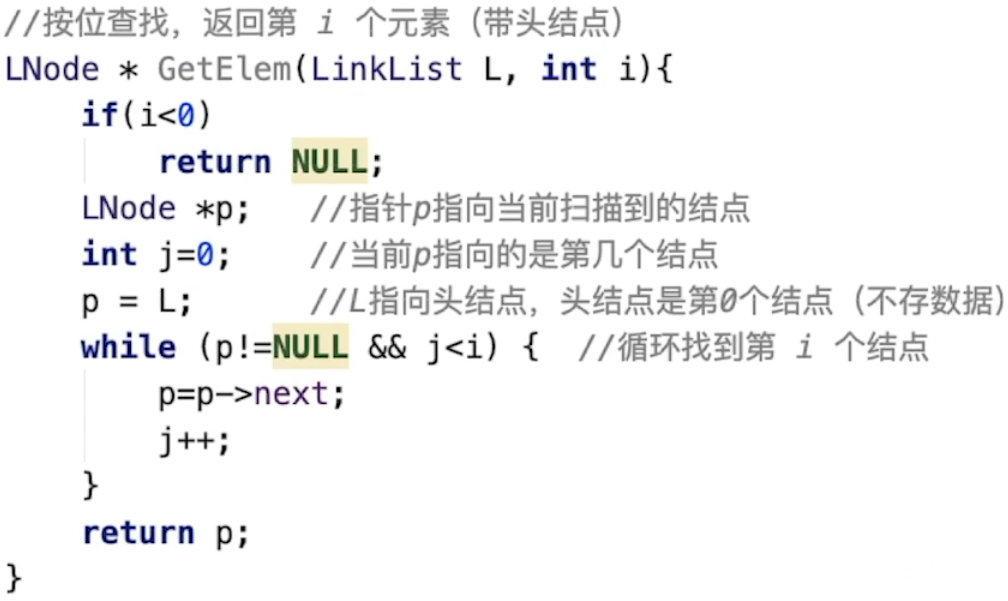
3.2、按值查找
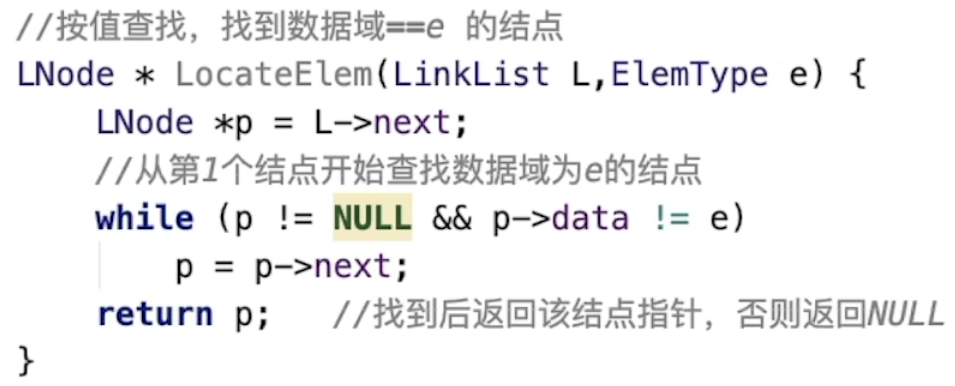
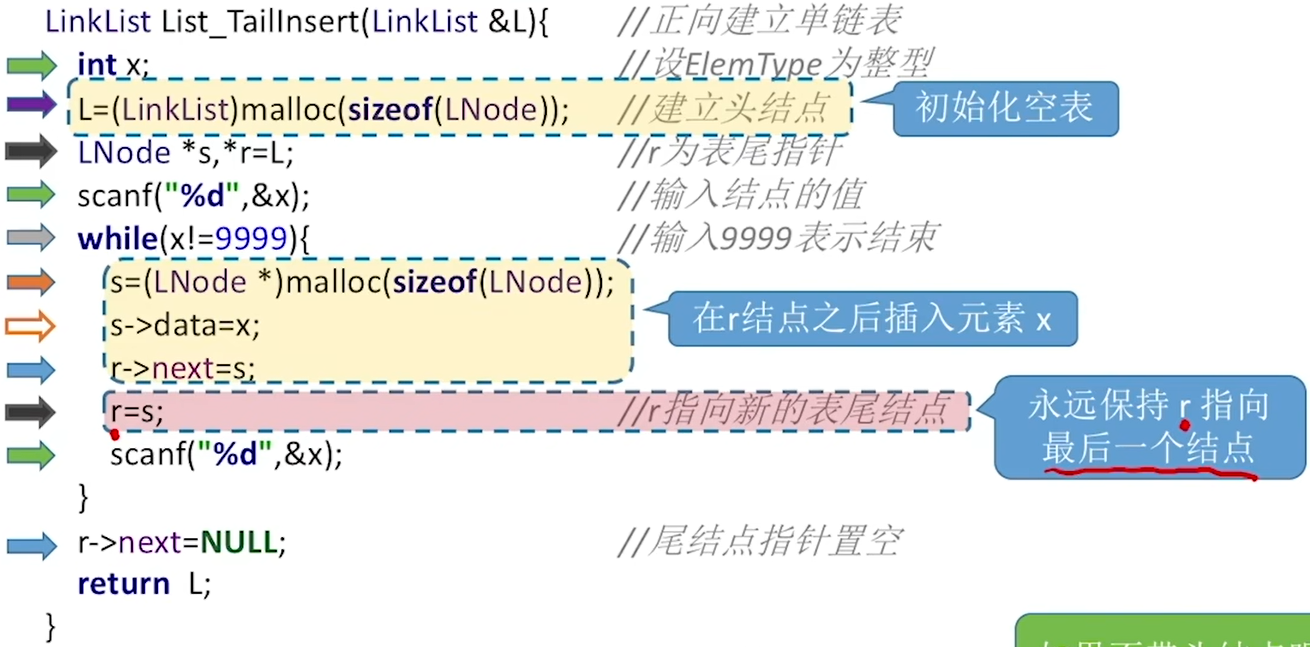
4、建立
4.1、尾插法
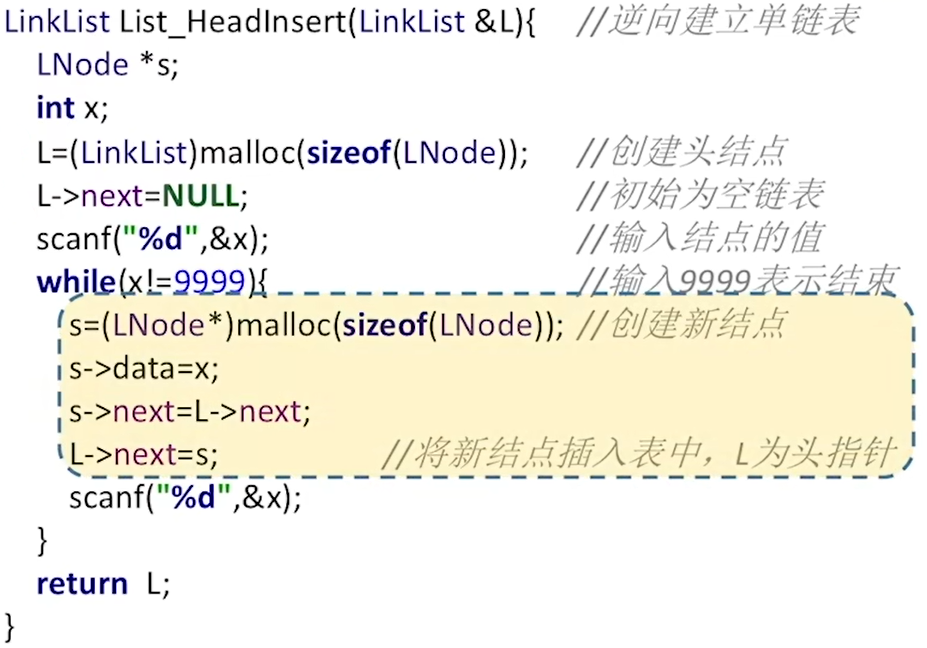
4.2、头插法
2.3.3双链表
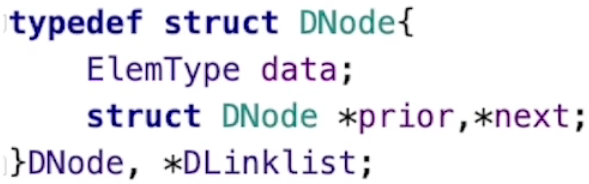
1、定义
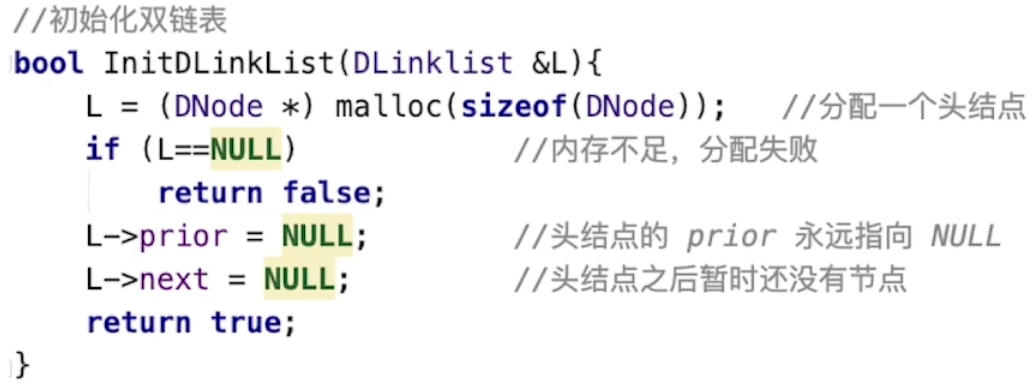
2、初始化
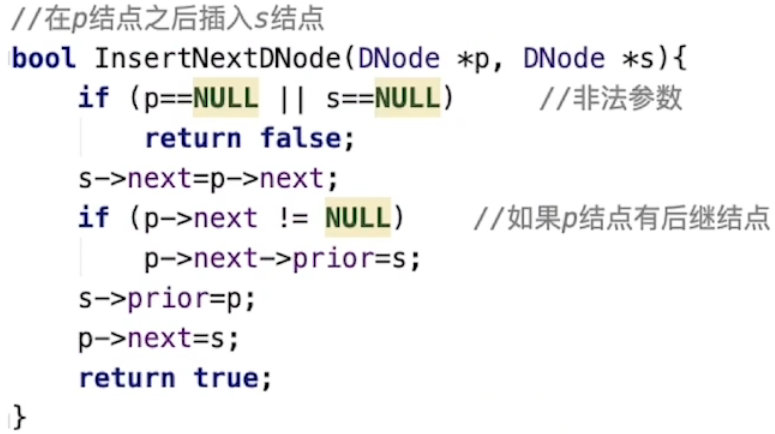
3、插入
4、删除

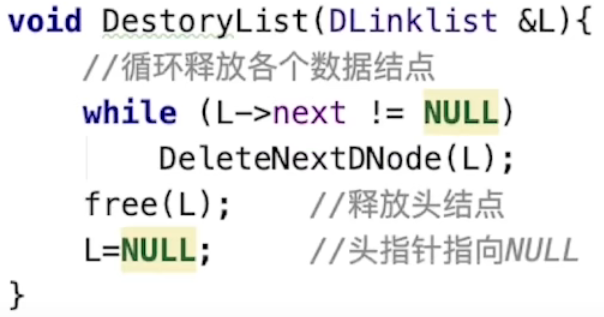
5、销毁
2.3.4循环链表
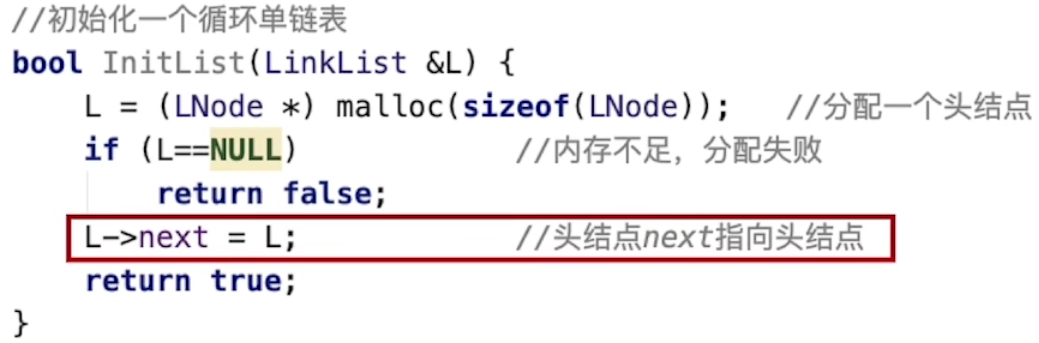
1、循环单链表
1.1、初始化
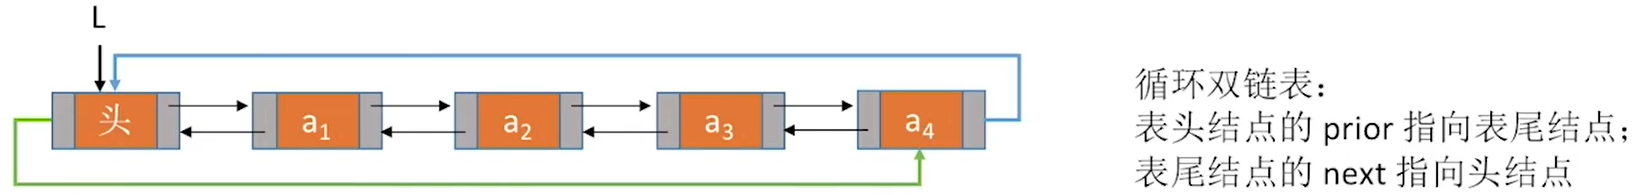
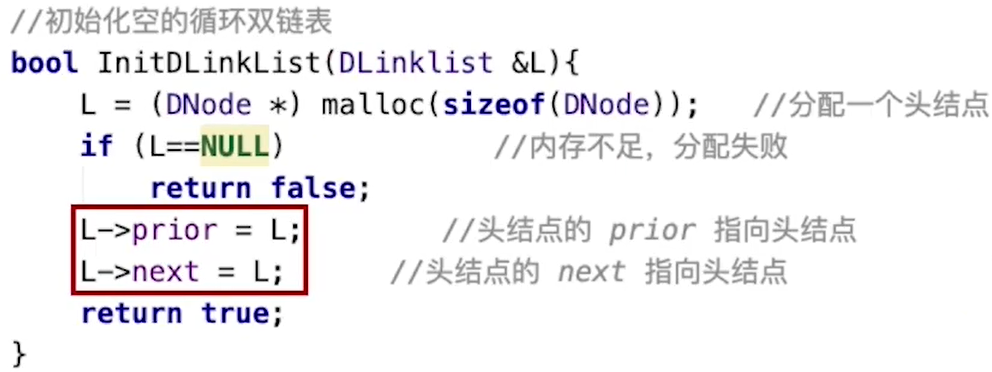
2、循环双链表
2.1、初始化
2.3.5静态链表
静态链表:分配一整片连续的内存空间,各个结点集中安置。用数组的方式实现的链表。
优点:增、删操作不需要大量移动元素
缺点:不能随机存取,只能从头结点开始依次往后查找;容量固定不可变
1、定义
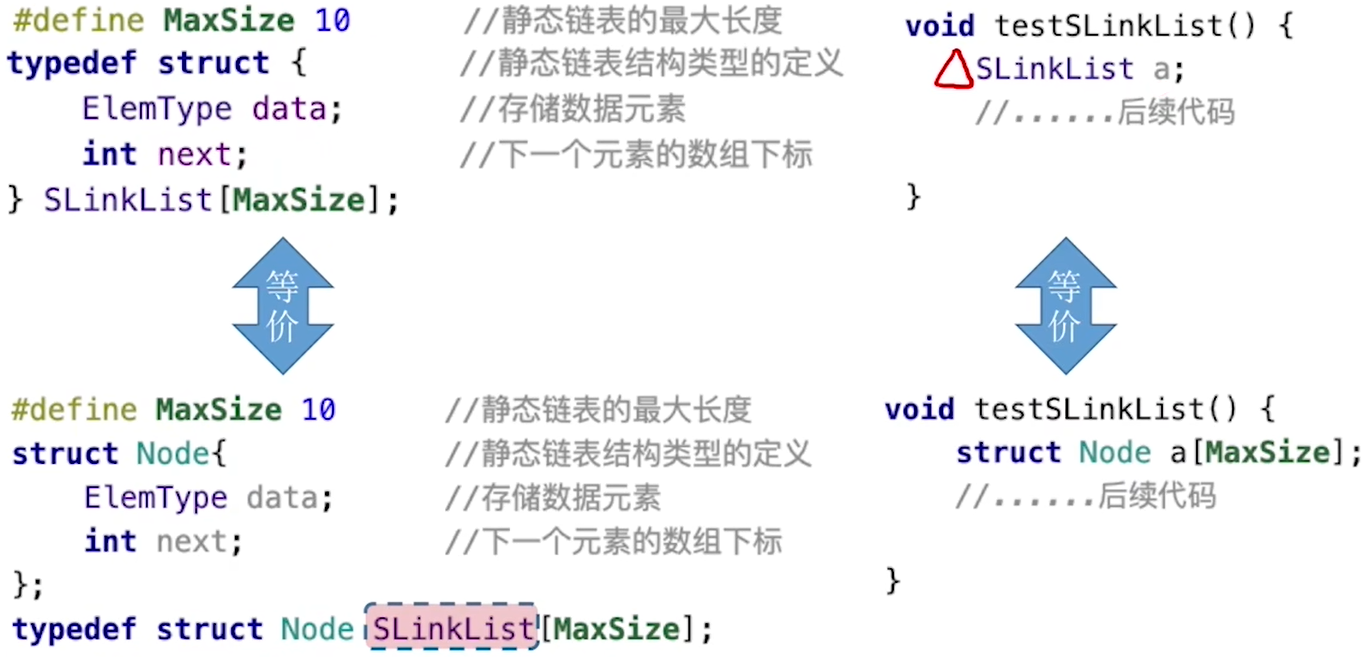
2、初始化静态链表:把a[0]的next设为-1
2.3.6顺序表和链表的比较
1、逻辑结构
都属于线性表,都是线性结构
2、存储结构
顺序表:顺序存储
优点:可随机存取,存储密度高
缺点:要求大片连续空间,改变容量不方便
链表:链式存储
优点:不要求大片连续空间,改变容量方便
缺点:不可随机存取,要耗费一定空间存放指针
3、基本操作
查找、插入和删除操作
按值查找。若顺序表无序时,两者的时间复杂度均为O(n);顺序表有序时可以采取折半查找,此时的时间复杂度为O(logn)。
按序号查找。顺序表支持随机访问,时间复杂度为O(1)。链表的时间复杂度为O(n)。
插入和删除操作。顺序表平均需要移动半个表长的元素,而链表只需要修改相关结点的指针即可。由于链表的每个结点都存有指针域,故存储密度不够大。
第三章 栈、队列和数组
3.1栈
3.1.1栈的基本概念
栈的定义:栈是只允许在一端进行插入或删除操作的线性表
栈顶:允许插入和删除的一端
栈底:不允许插入和删除的一端
特点:后进先出
Last In First Out(LIFO)
合法栈序列:卡特兰数:
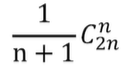
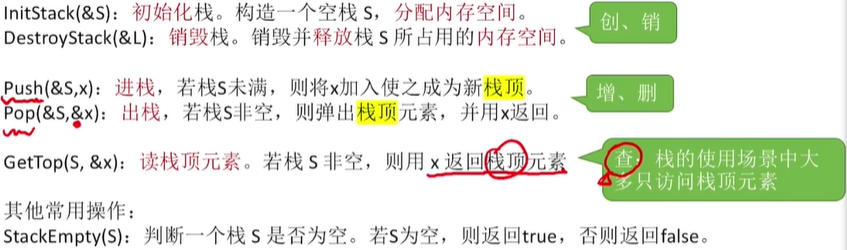
栈的基本操作
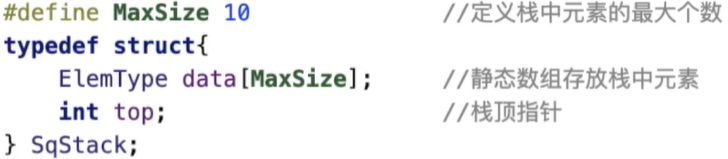
3.1.2栈的顺序存储实现
顺序栈的定义
基本操作
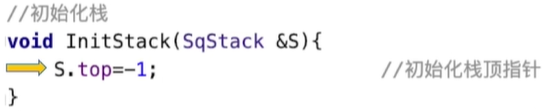
1、初始化栈
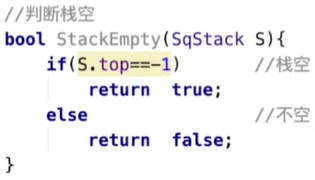
2、判断栈空
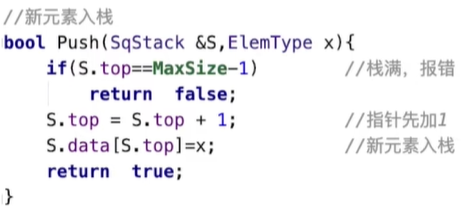
3、进栈
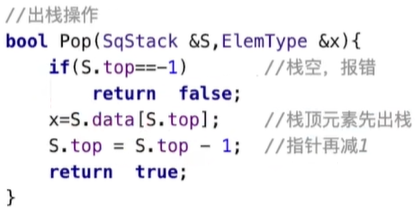
4、出栈
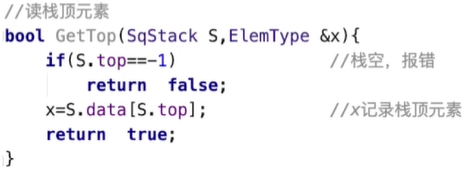
5、读栈顶元素
6、共享栈
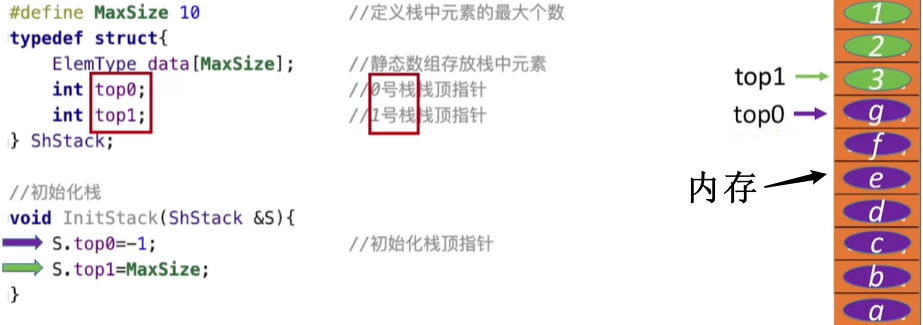
栈满的条件:top0 + 1 == top1
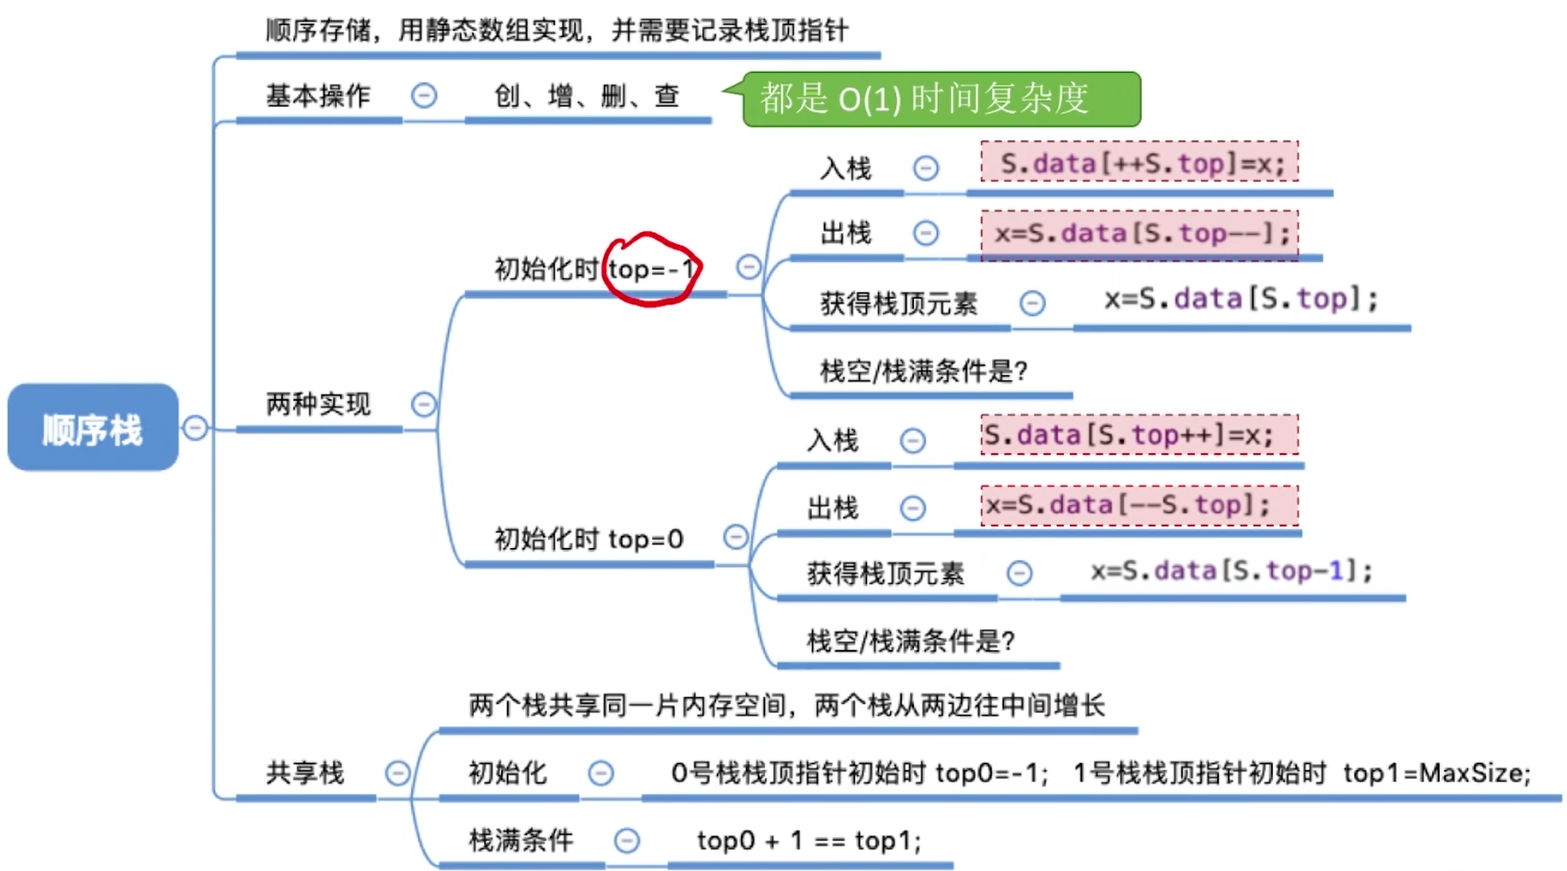
总结:
3.1.3栈的链式存储实现
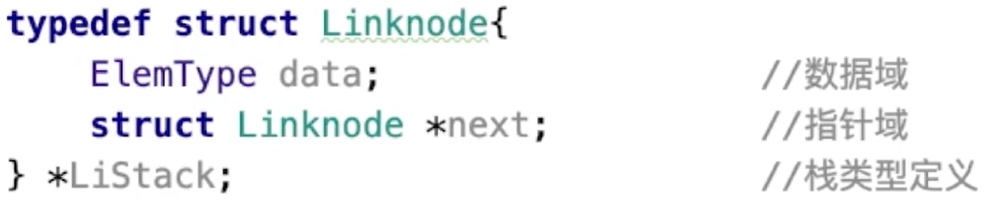
1、链栈的定义
2、初始化
1 | //链栈的初始化 |
3、判栈空
1 | //判栈空 |
4、入栈
1 | //链栈的入栈 |
5、出栈
1 | //链栈的出栈 |
6、取栈顶元素
1 | //取链栈的栈顶元素 |
7、遍历输出
1 | //遍历输出链栈 |
3.2队列
3.2.1队列的基本概念
1、队列的定义:队列是只允许在一端进行插入,在另一端删除的线性表
队头:允许删除的一端
队尾:允许插入的一端
队列的特点:先进先出
First In First Out(FIFO)
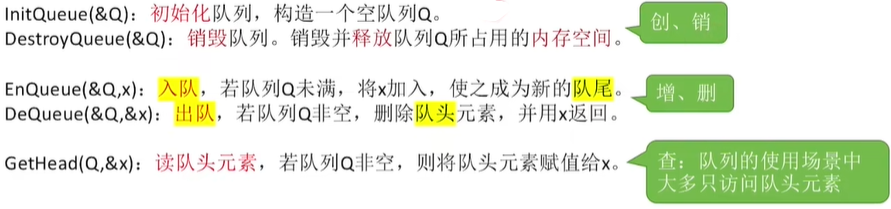
基本操作
3.2.2队列的顺序实现
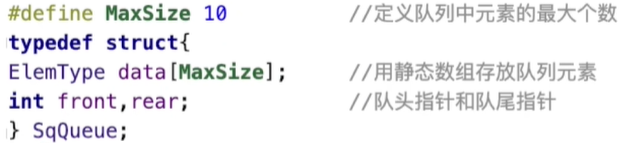
1、定义
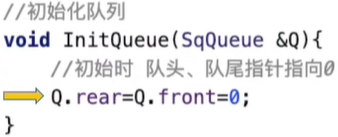
2、初始化
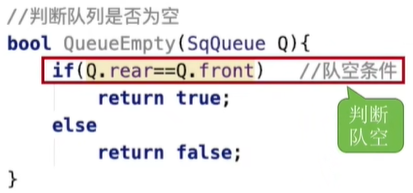
3、判空
4、入队
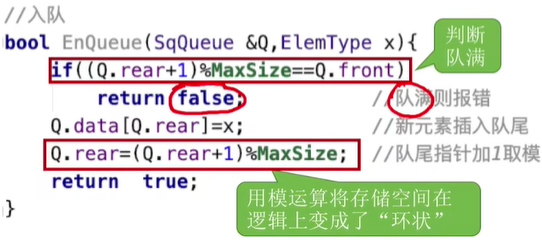
5、出队
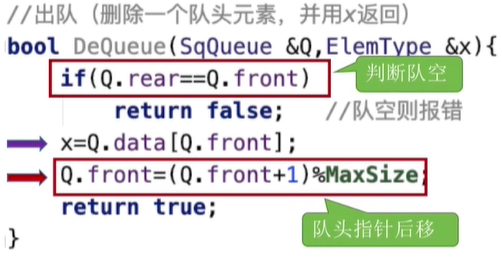
6、取队头元素
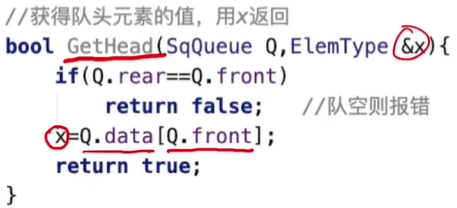
7、队列元素个数:(rear + MaxSize - front) % MaxSize
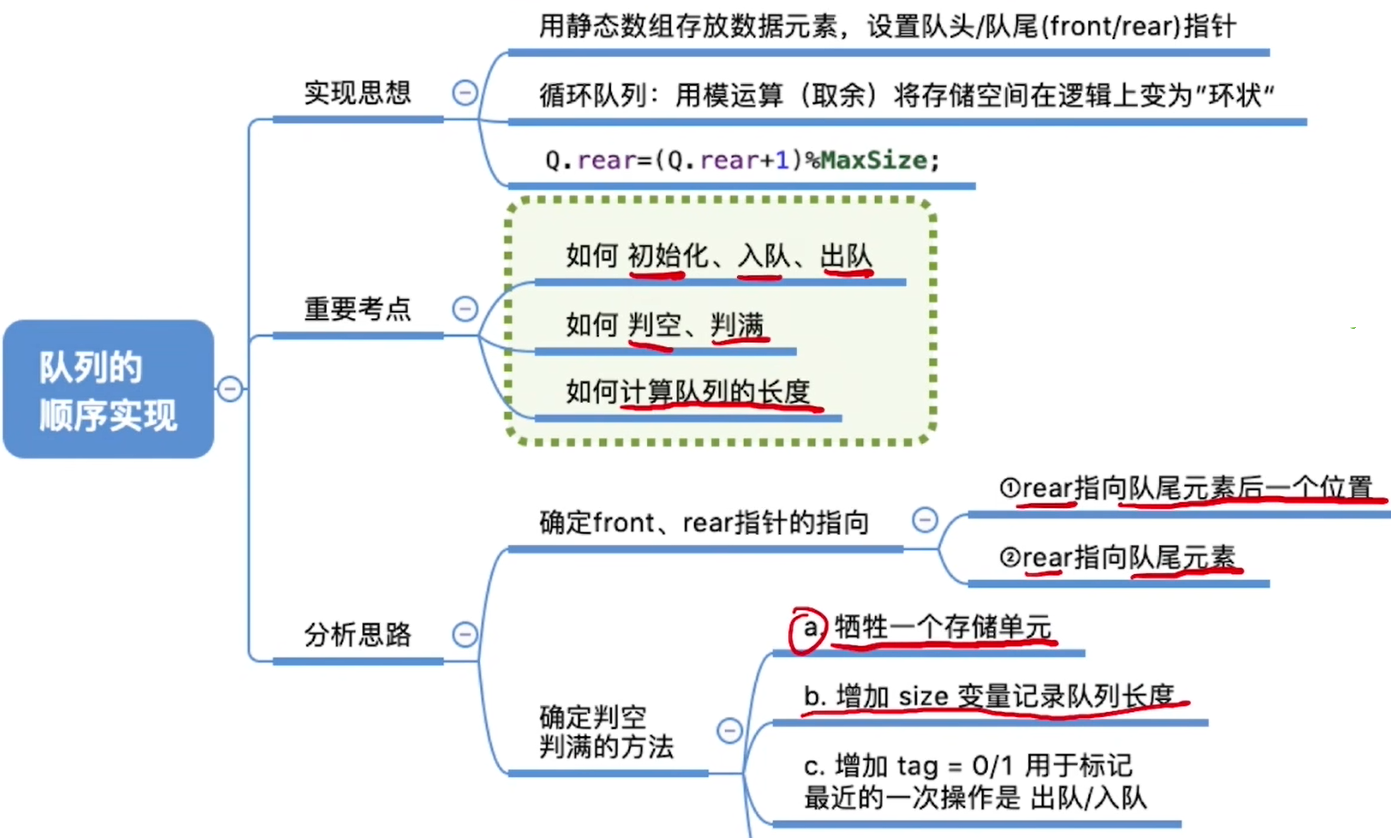
8、队满的三种处理方式
(1)、牺牲一个单元来区分队空和队满
约定以“队头指针在队尾指针的下一个位置作为队满的标志”
(2)、计数count——队列中有效元素个数
队列为空时,count == 0
当有元素入队时,count++,出队,count–
当count和队列的maxsize相等时,代表队列已满
(3)、设置一个标记位
设置初始标记: boolean flag=false
当入队列时,让rear往后移动,让flag=true
当出队列时,让front往后移动,让flag=false
当队列为空时:rear == front && flag==false
当队列为满时:rear == front && flag == true
9、总结
3.2.3队列的链式实现
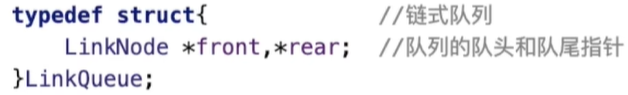
1、定义
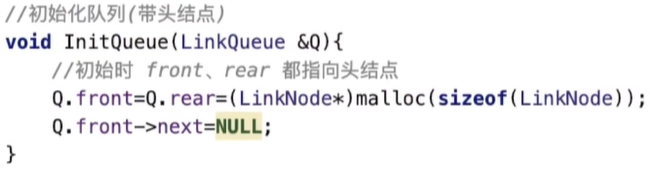
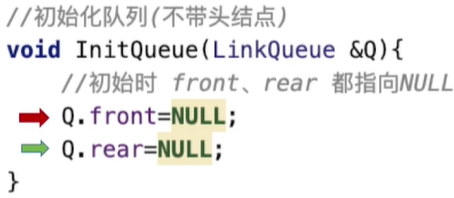
2、初始化
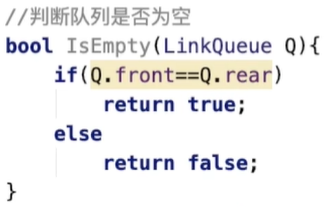
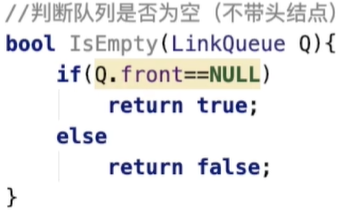
3、判空
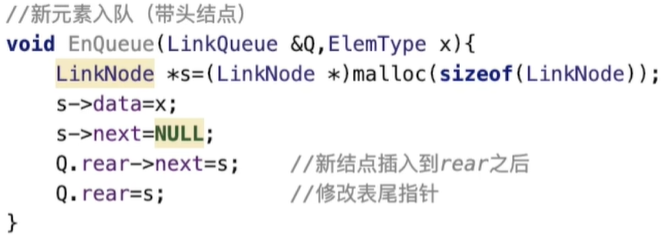
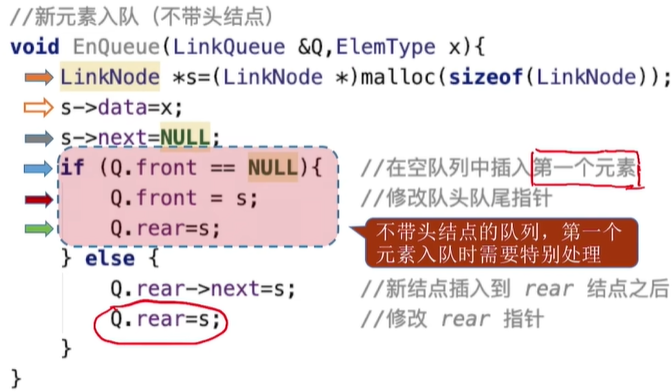
4、入队
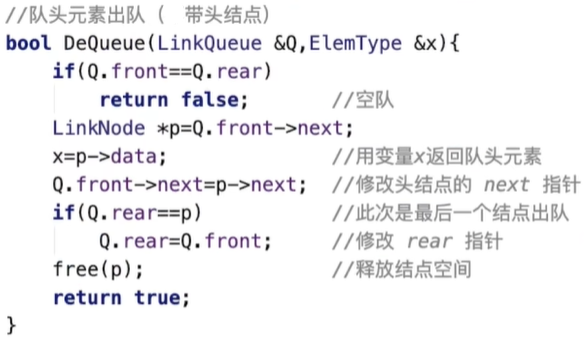
5、出队
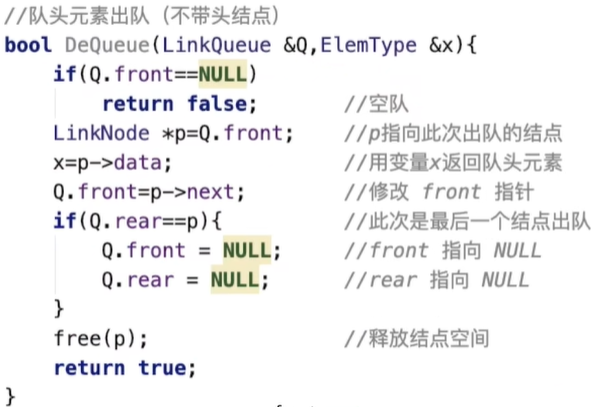
6、队满:链式存储——一般不会队满,除非内存不足
3.2.4双端队列
双端队列:只允许从两端插入、两端删除的线性表
输入受限的双端队列:只允许从两端删除、从一端插入的队列
输出受限的双端队列:只允许从两端插入、从一端删除的队列
考点:对输出序列合法性的判断
3.3栈和队列的应用
3.3.1栈在括号匹配中的应用
1、逻辑图
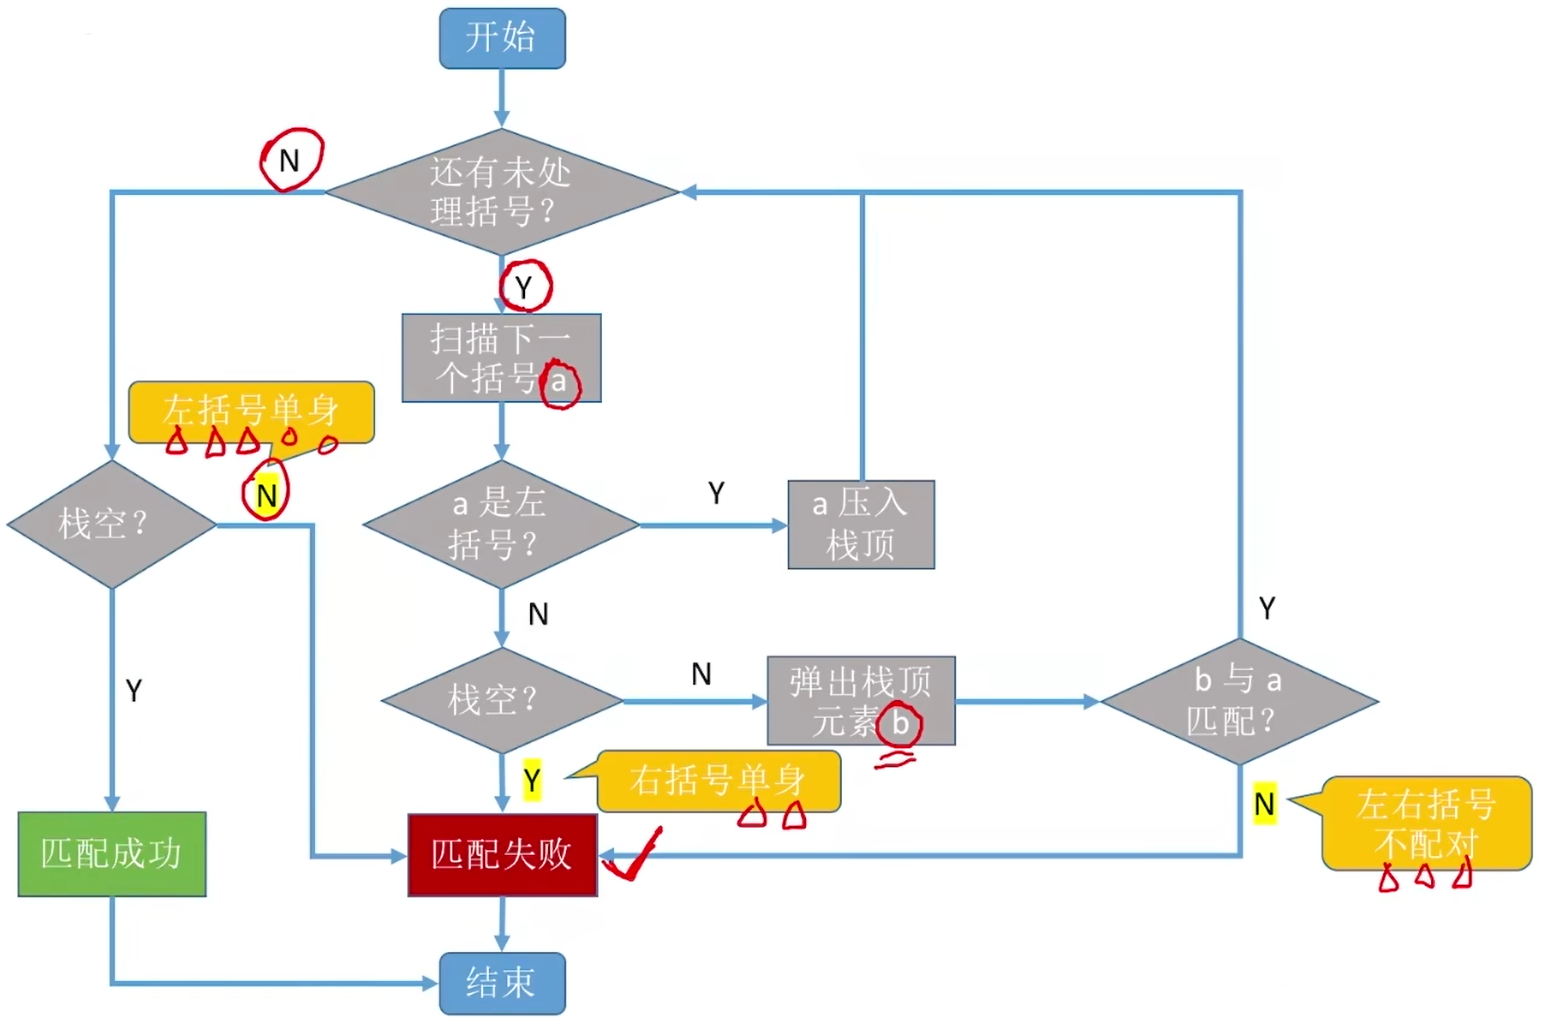
2、算法实现
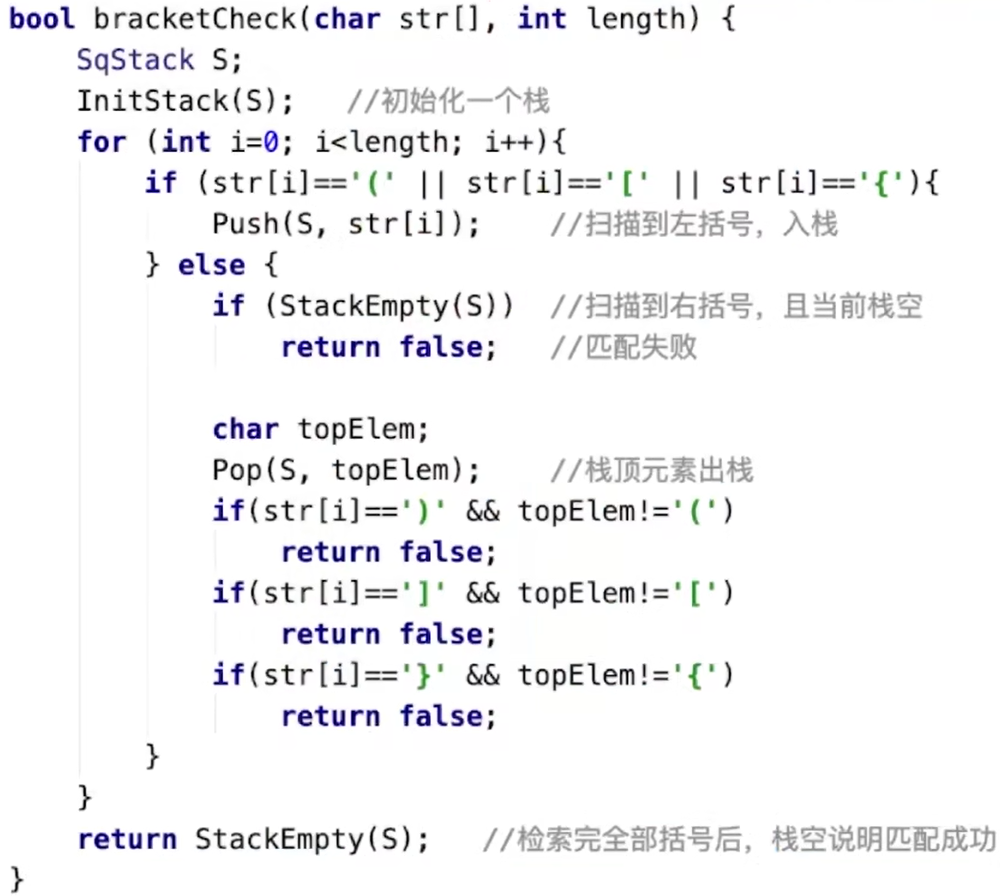
3.3.2栈在表达式求值中的应用
1、中缀表达式:运算符在两个操作数中间
后缀表达式:运算符在两个操作数后间
前缀表达式:运算符在两个操作数前间
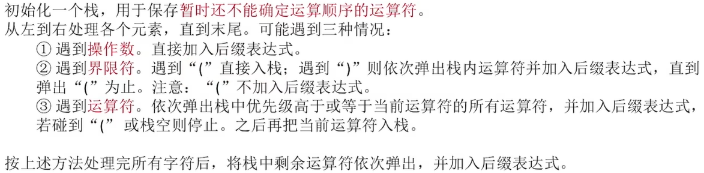
2、中缀表达式转后缀表达式
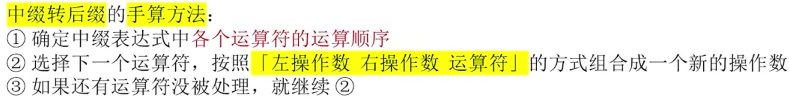
“左优先原则”:只要左边的运算符能先计算,就优先算左边的
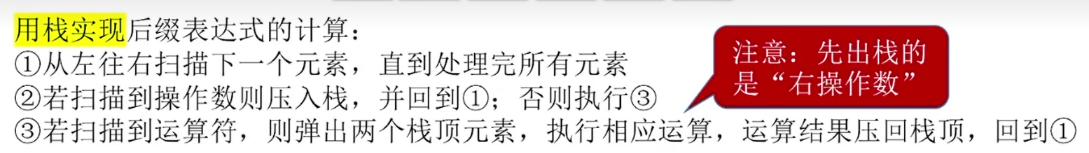
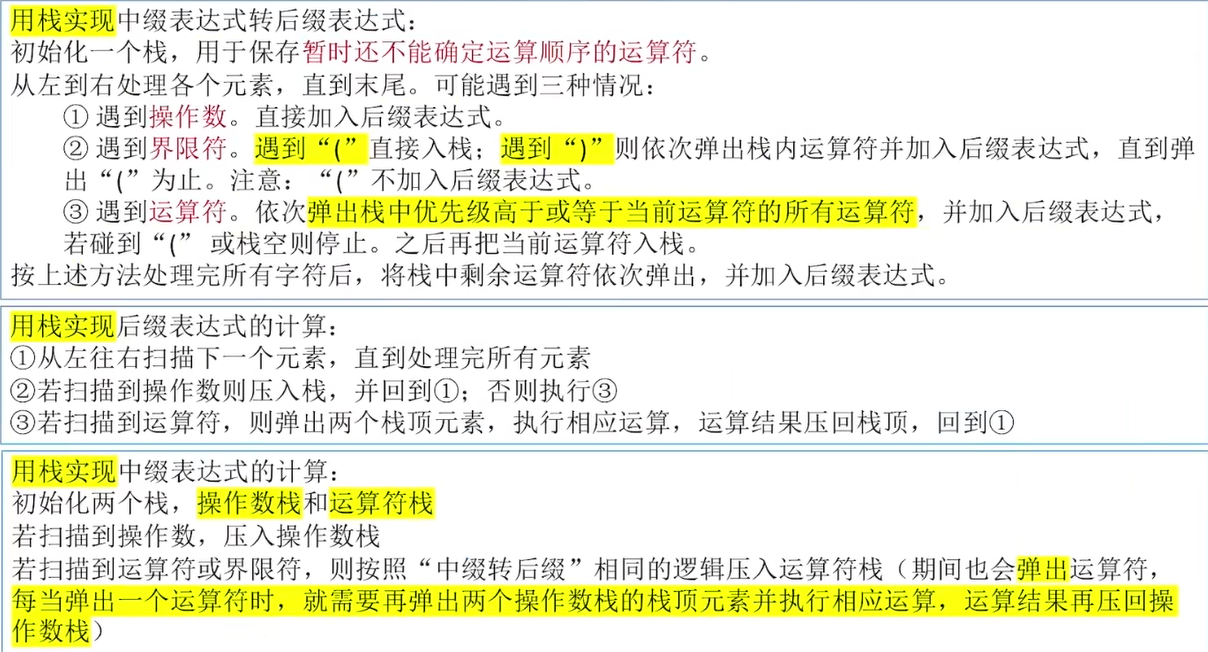
3、用栈实现后缀表达式的计算
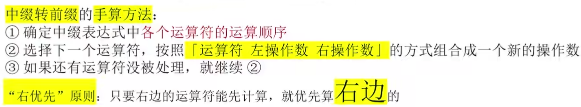
4、中缀表达式转前缀表达式
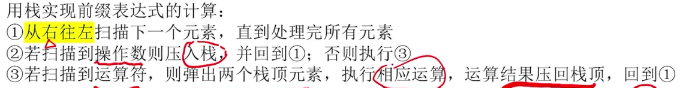
5、用栈实现前缀表达式的计算
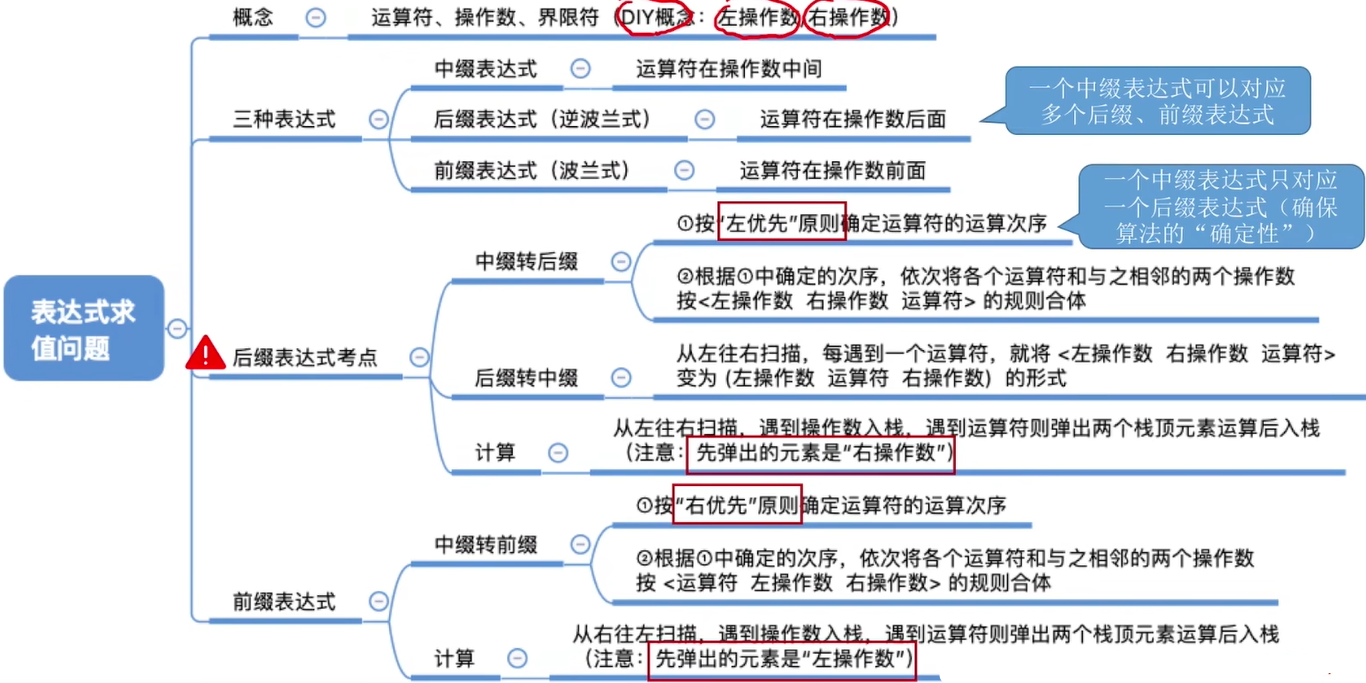
6、总结
1、中缀表达式转后缀表达式(机算)
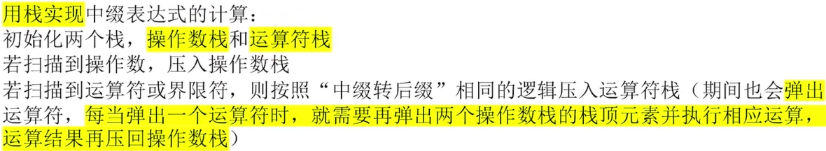
2、用栈实现中缀表达式的计算
3、总结
3.4特殊矩阵的压缩存储
1、一维数组
起始地址:LOC
各数组元素大小相同,且物理上连续存放
数组元素a[i]的存放地址 = LOC + i * sizeof(ElemType)
下标默认从0开始
2、二维数组
M行N列的二维数组b[M][N]中
若按行优先存储,则b[i][j]的存储地址 = LOC + (i * N + j) * sizeof(ElemType)
若按列优先存储,则b[i][j]的存储地址 = LOC + (j * M + i) * sizeof(ElemType)
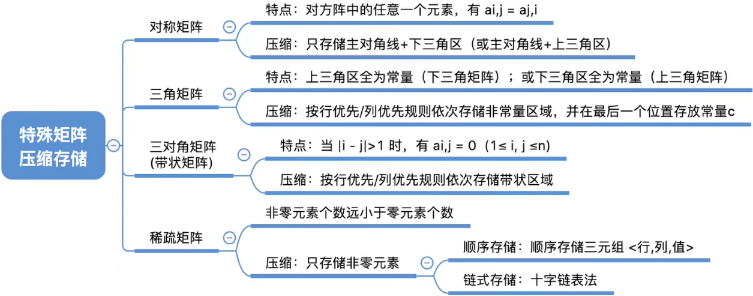
3、对称矩阵
策略:只存储主对角线 + 下三角区
按行优先原则将各元素存入一维数组中B[n(n + 1) / 2 - 1]
ai,j是第i(i - 1) / 2 + j个元素,k=i(i - 1) / 2 + j - 1
4、三对角矩阵,又称带状矩阵
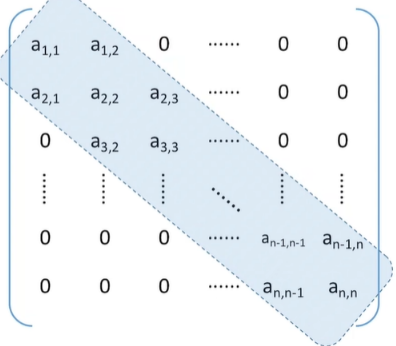
当|i - j| > 1时,有ai,j = 0(1 <= i, j <= n)
压缩存储策略:按行优先(或列优先)原则,只存储带状部分B[3n - 3]
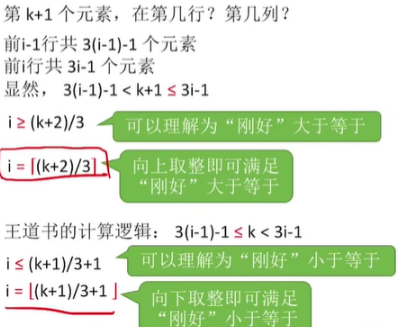
第ai,j是第几个元素?
前i - 1行共3(i - 1) - 1个元素
ai,j是i行第j - i + 2个元素
ai,j是第2i + j - 2个元素,k = 2i + j - 3
5、稀疏矩阵
稀疏矩阵:非零元素远远少于矩阵元素的个数
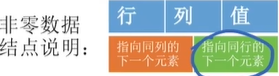
压缩存储策略:顺序存储——三元组<行,列,值>
压缩策略二:链式存储——十字链表法
6、总结
第四章 串
4.1串的定义和实现
4.1.1串的定义和基本操作
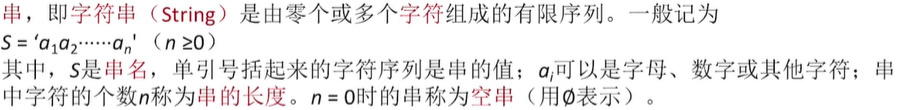
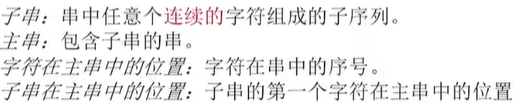
1、串的定义
2、基本操作

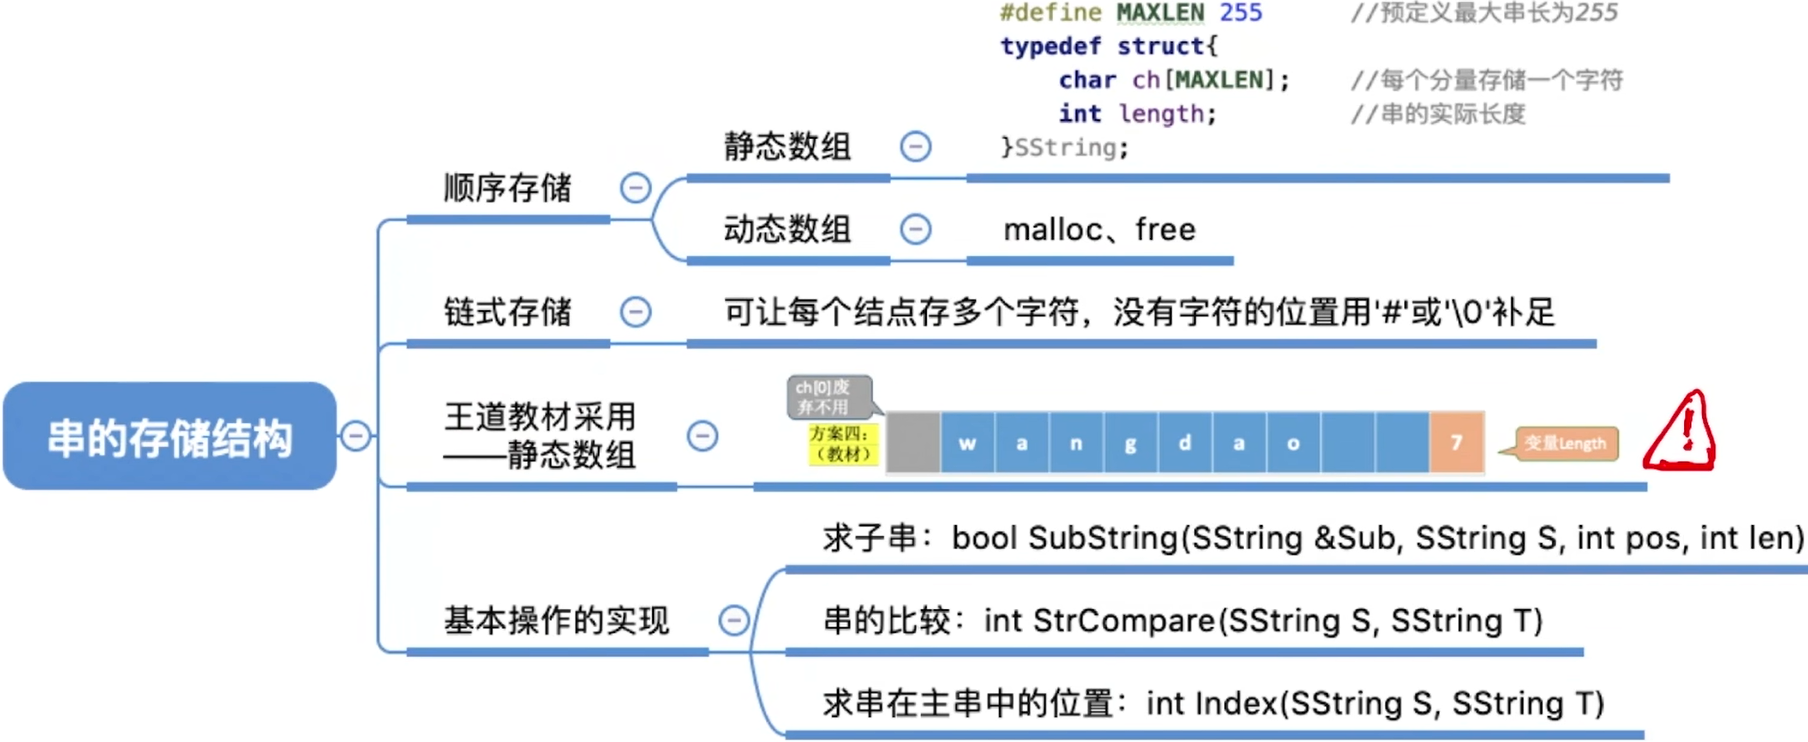
4.1.2串的存储结构
1、顺序存储
1 | //静态存储 |
2、链式结构
1 | typedef struct StringNode{ |
3、基本操作
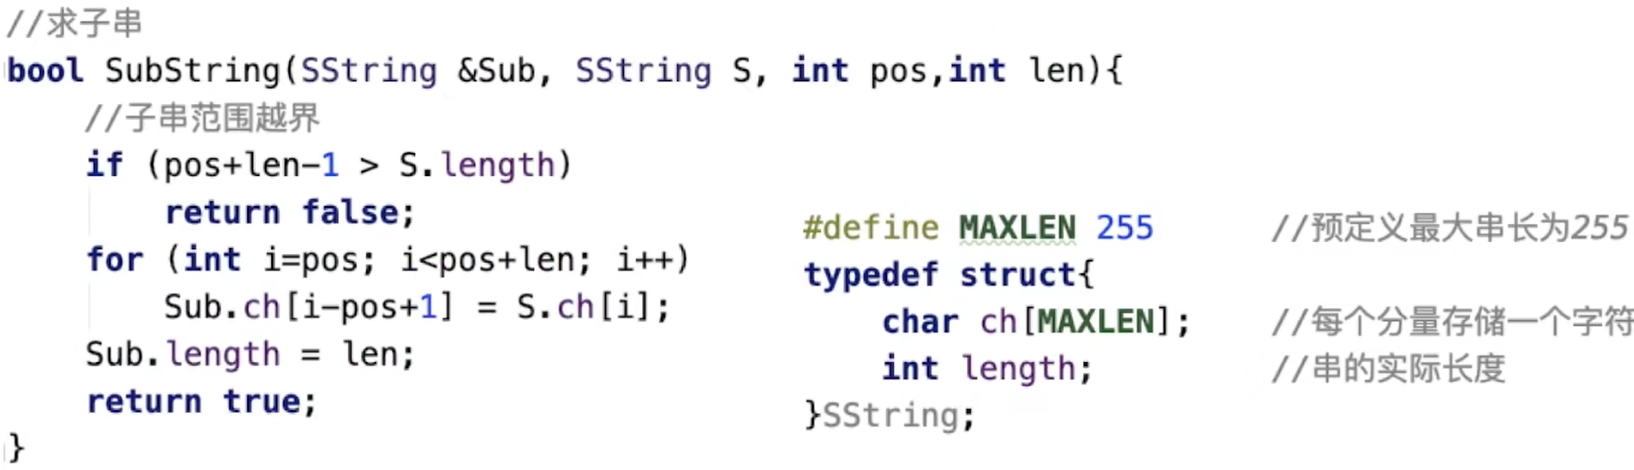
3.1、求子串
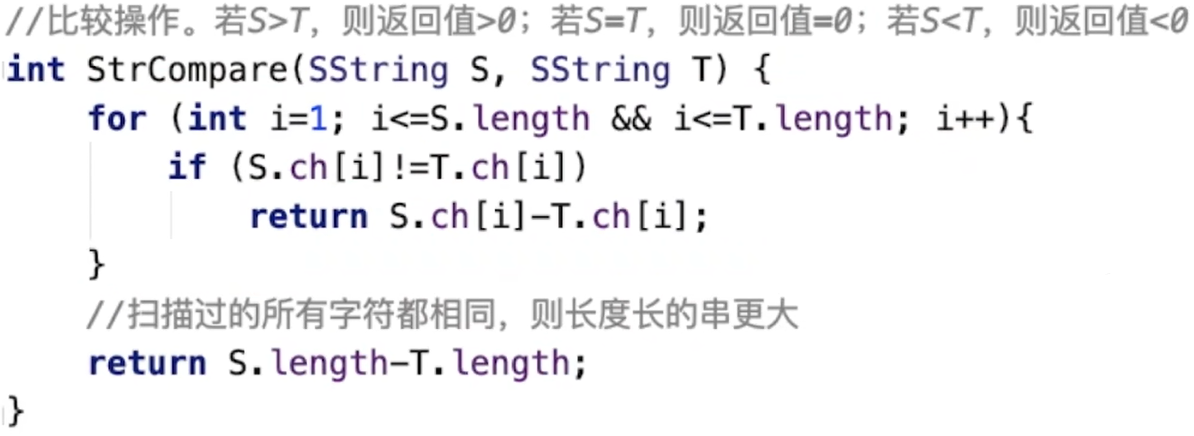
3.2、比较操作
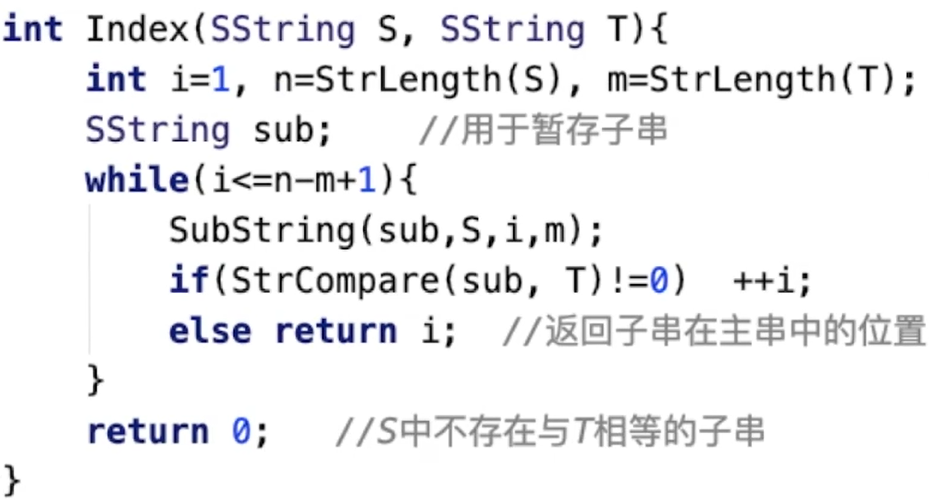
3.3、定位操作
3.4、知识回顾
4.2串的模式匹配
4.2.1串的朴素模式匹配算法
1、串的模式匹配:在主串中找到与模式串相同的子串,并返回其所在位置
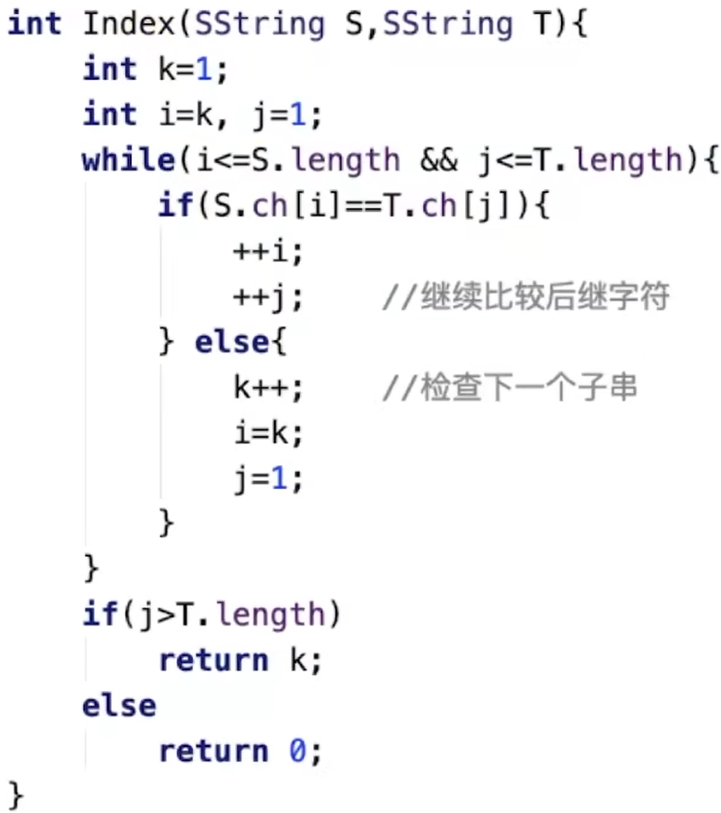
2、算法思想
将主串中与模式串长度相同的子串拿出来依次与模式串对比,当子串与模式串某个对于字符不匹配是,就立即放弃当前子串,转而检索下一个子串
缺点:当某些子串与模式串能部分匹配时,主串的扫描指针i经常回溯,导致时间开销增加
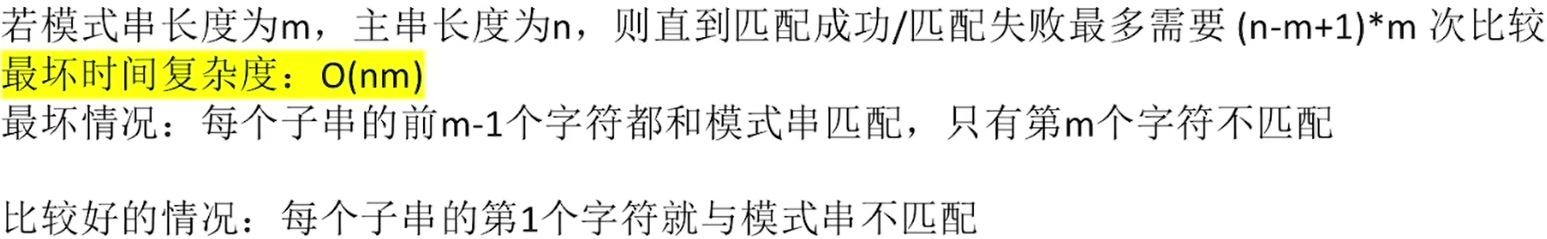
3、算法性能分析
4.2.2KMP算法
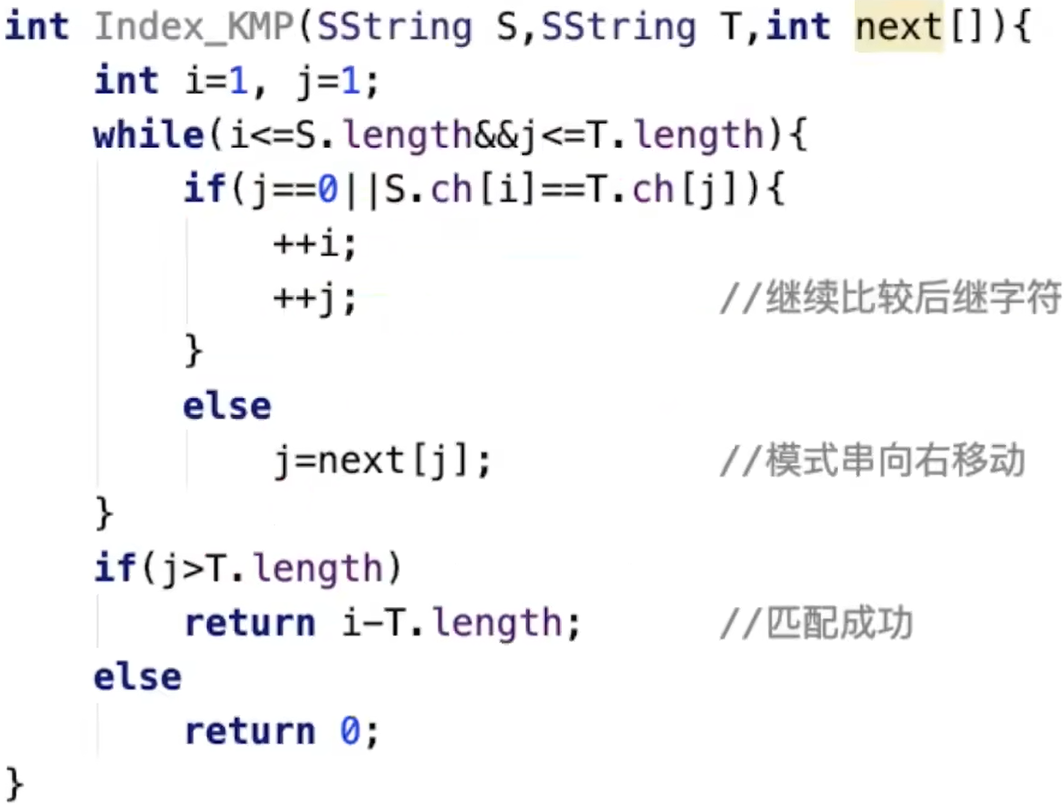
1、算法代码
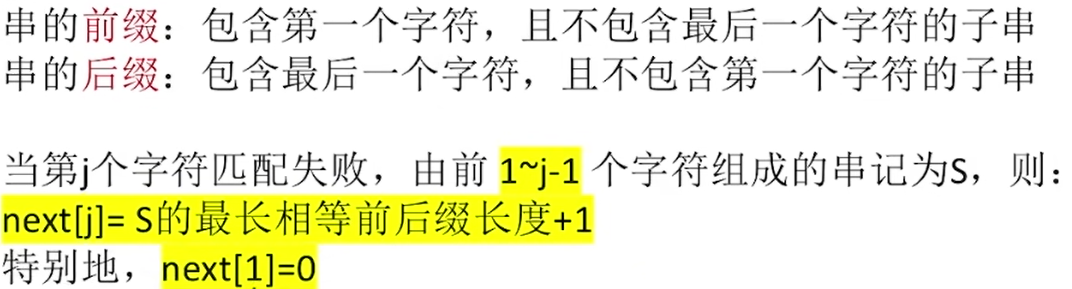
2、手算求next数组
3、KMP算法
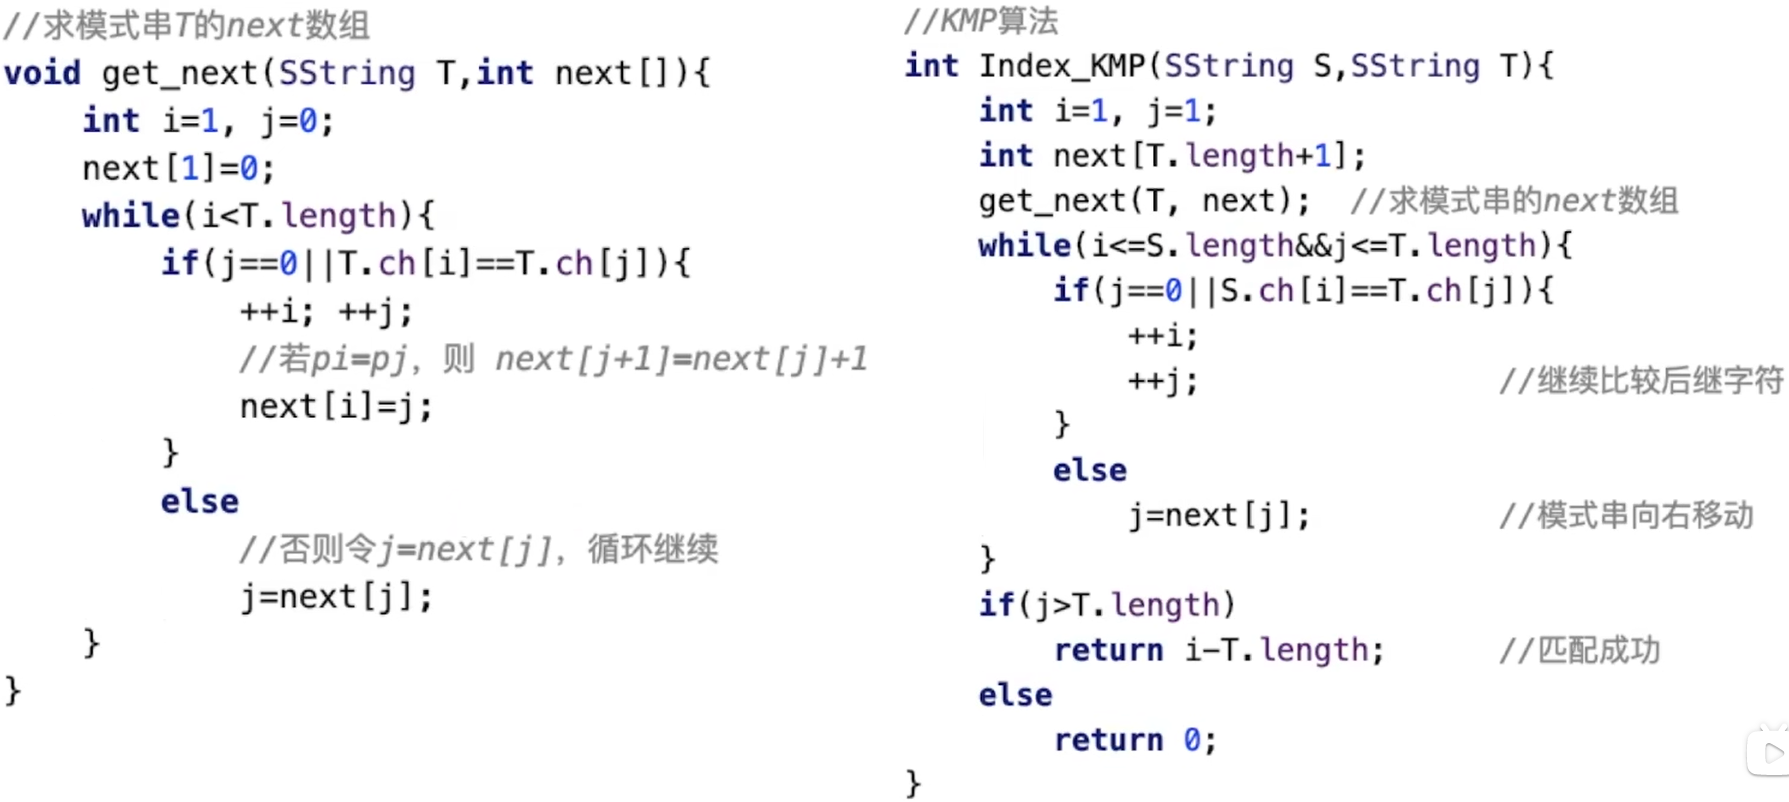
时间复杂度O(m+n)
4.2.3KMP算法的进一步优化
KMP算法优化:当子串和模式串不匹配时j = nextval[ j ];

第五章 树与二叉树
5.1树的基本概念
5.1.1树的定义和基本术语
1、树的基本概念
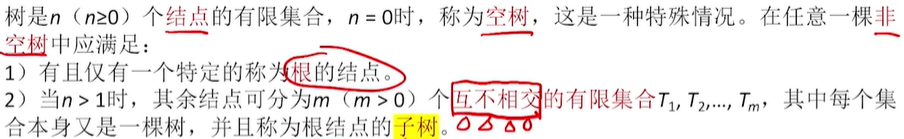
树是一种递归定义的数据结构
2、非空树的特性:
●有且仅有一个根结点
●没有后继的结点称为“叶子结点”(或终端结点)
●有后继的结点称为“分支结点”(或非终端结点)
●除了根结点外,任何一个结点都有且仅有一个前驱
●每个结点可以有0个或多个后继
3、结点的属性
●结点的层次(深度):从上往下数
●结点的高度:从下往上数
●树的高度(深度):总共多少层
●结点的度:有几个分支
●树的度:各结点的度的最大值
4、其他定义
有序树:逻辑上看,树中结点的各子树从左至右是有次序的,不能互换
无序树:逻辑上看,树中结点的各子树从左至右是无次序的,可以互换
森林:森林是m(m ≥ 0)颗互不相交的树的集合
5、知识回顾

5.1.2树的性质
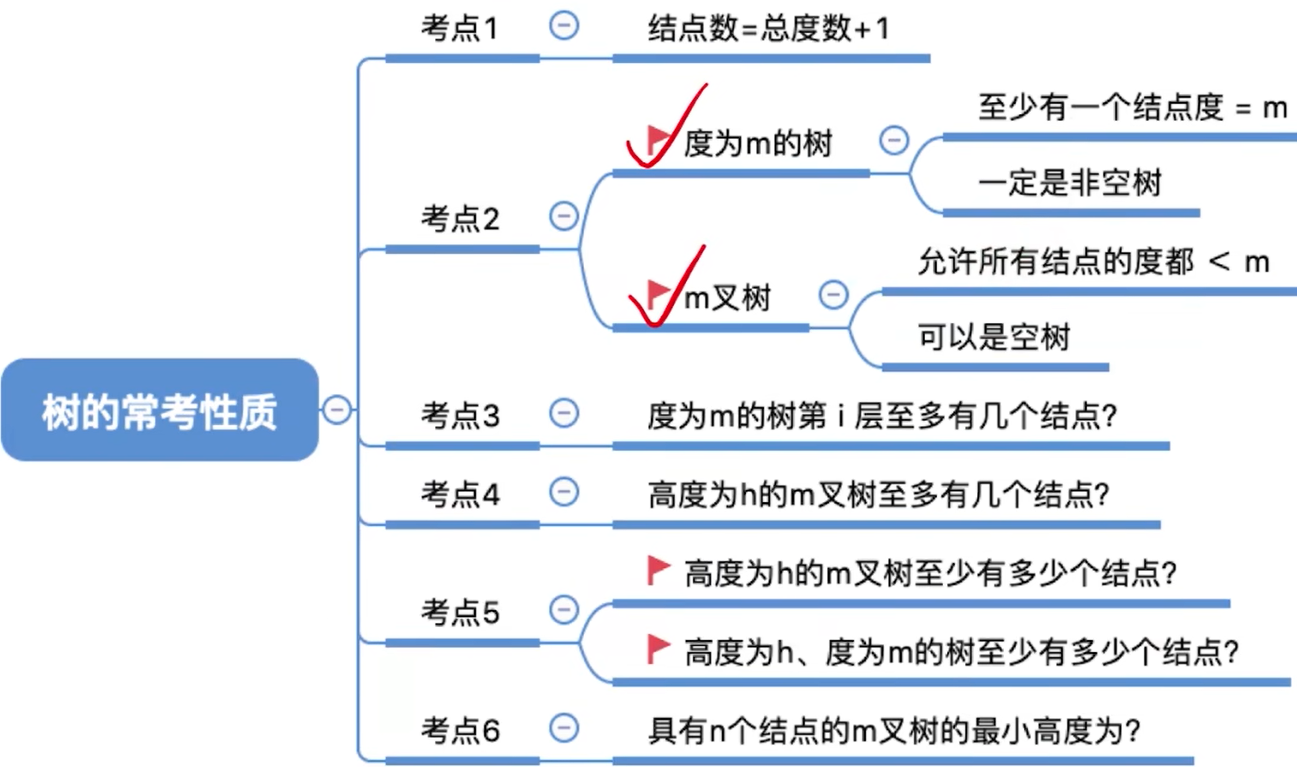
1、树的常考性质
●结点数 = 总度数 + 1
●度为m的树、m叉树的区别
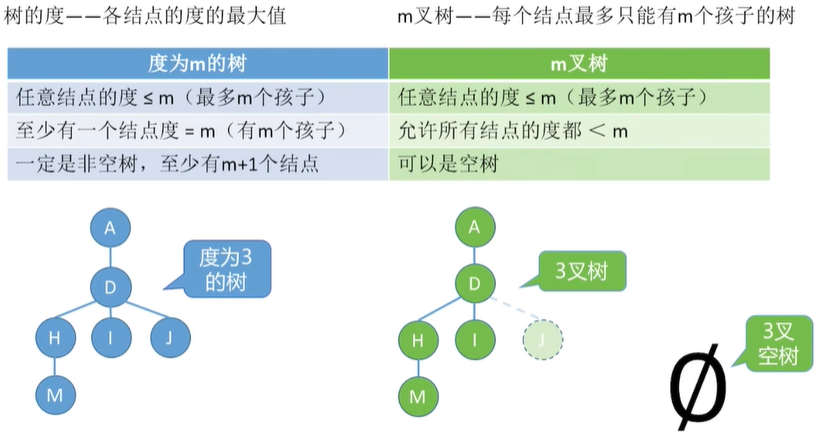
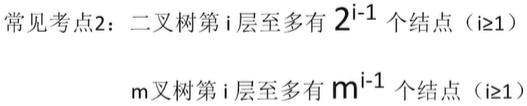
●度为m的树第i层至多有m^(i-1)个结点(i ≥ 1)
●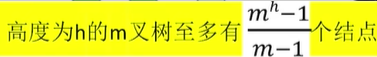
●高度为h的m叉树至少有h个结点;高度为h、度为m的树至少有h+m-1个结点
●
2、知识回顾
5.2二叉树的概念
5.2.1二叉树的定义和基本术语
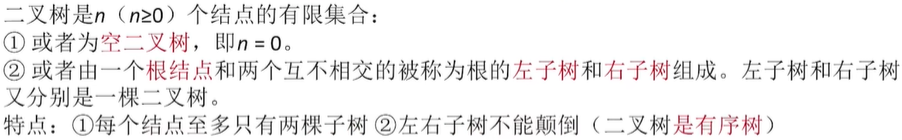
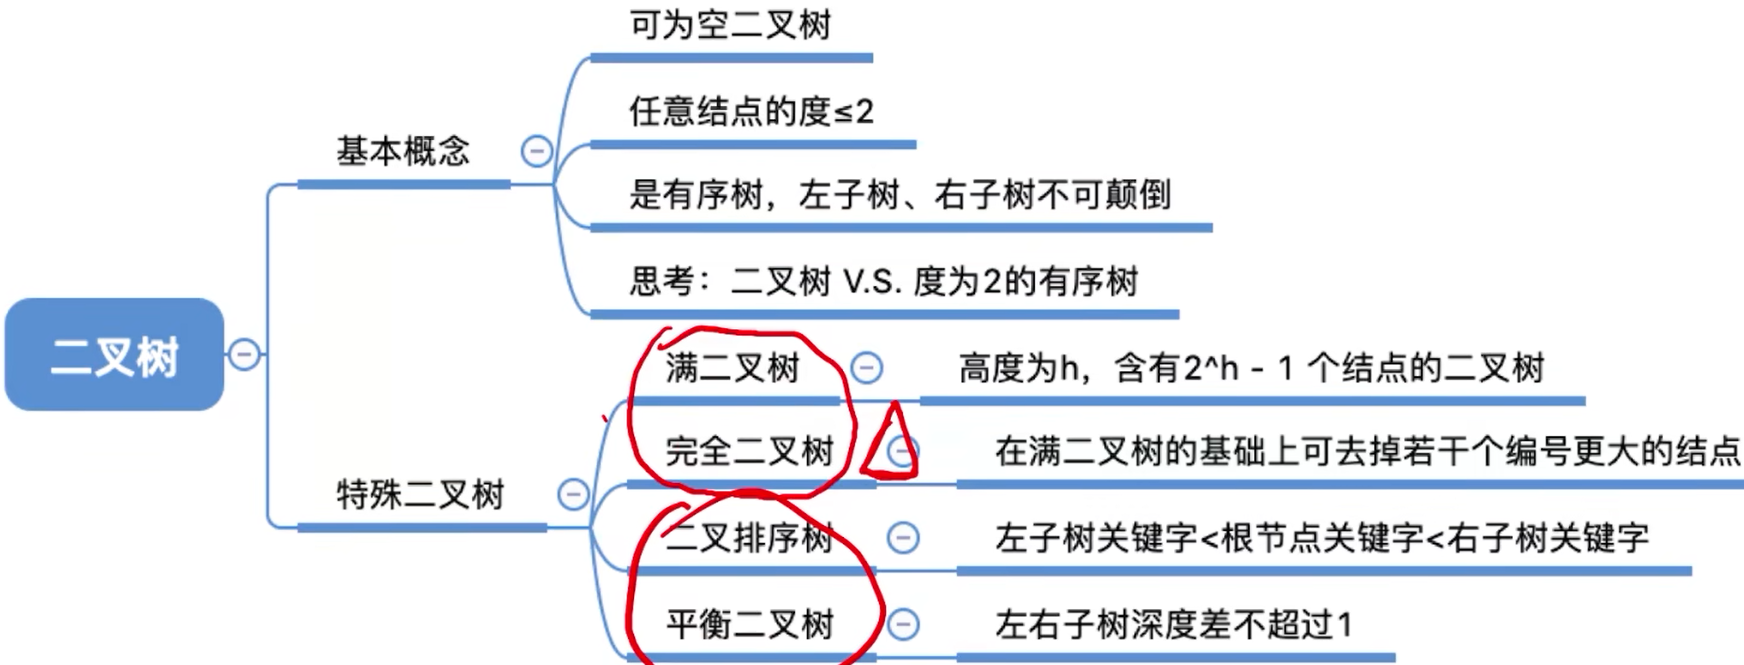
1、二叉树的基本概念
2、几个特殊二叉树
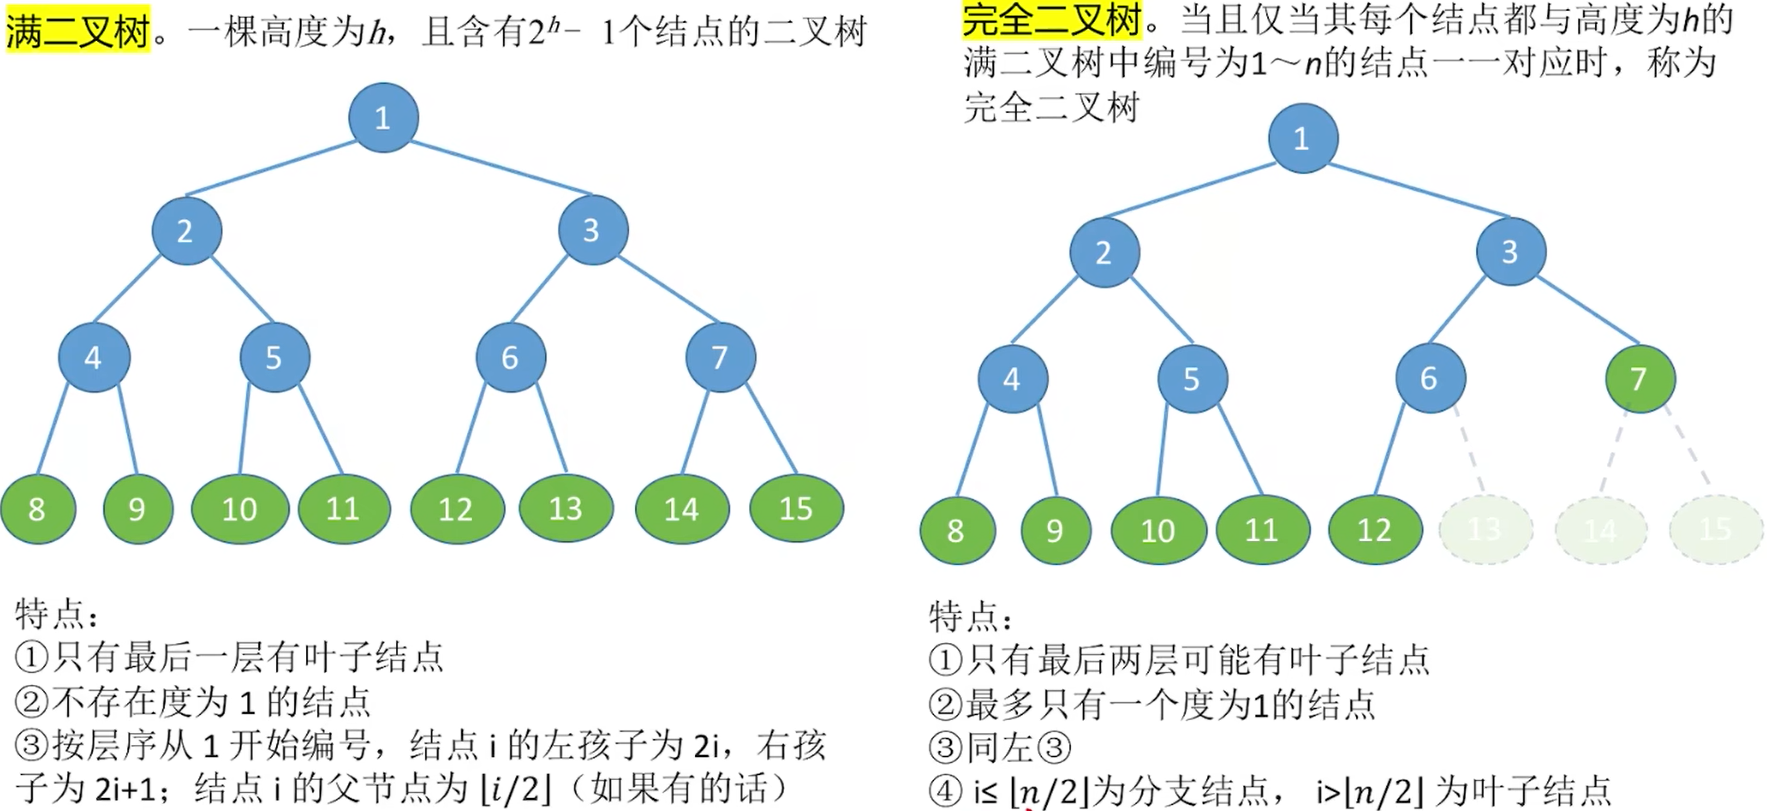
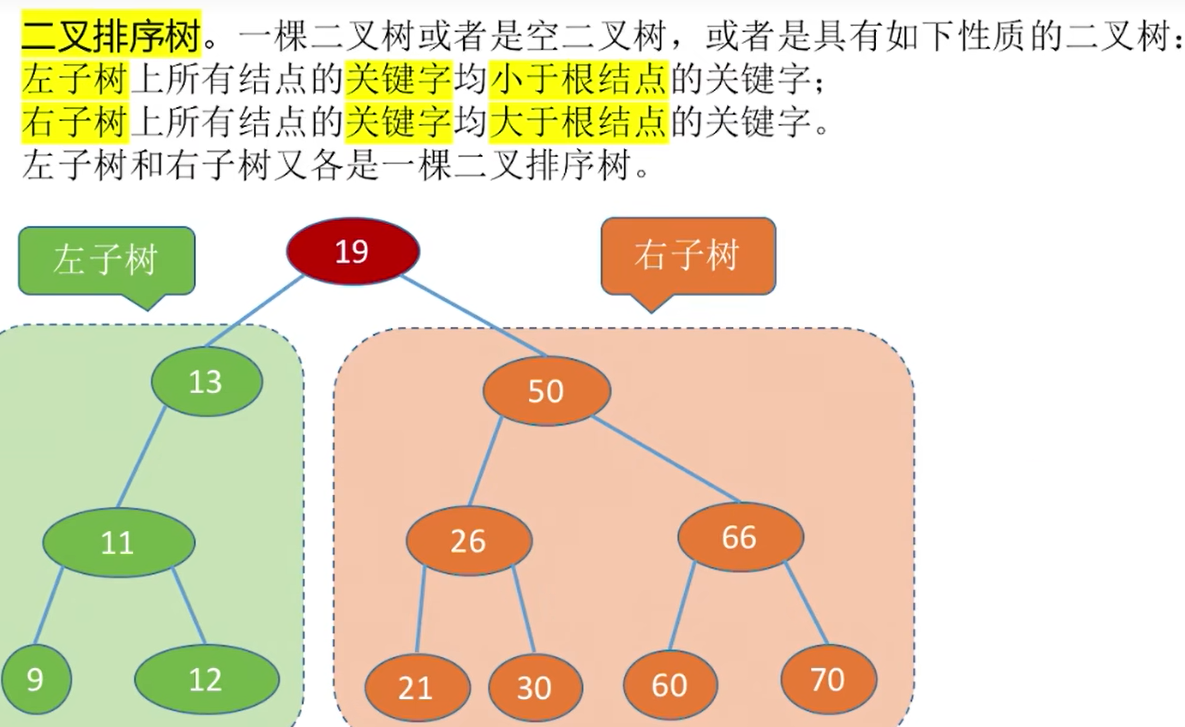
●平衡二叉树:树上任一结点的左子树和右子树的深度只差不超过1,平衡二叉树能有更高的搜索效率
3、知识回顾
5.2.2二叉树的性质
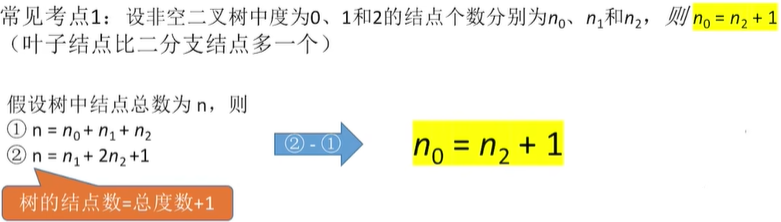
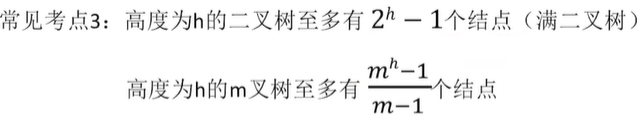
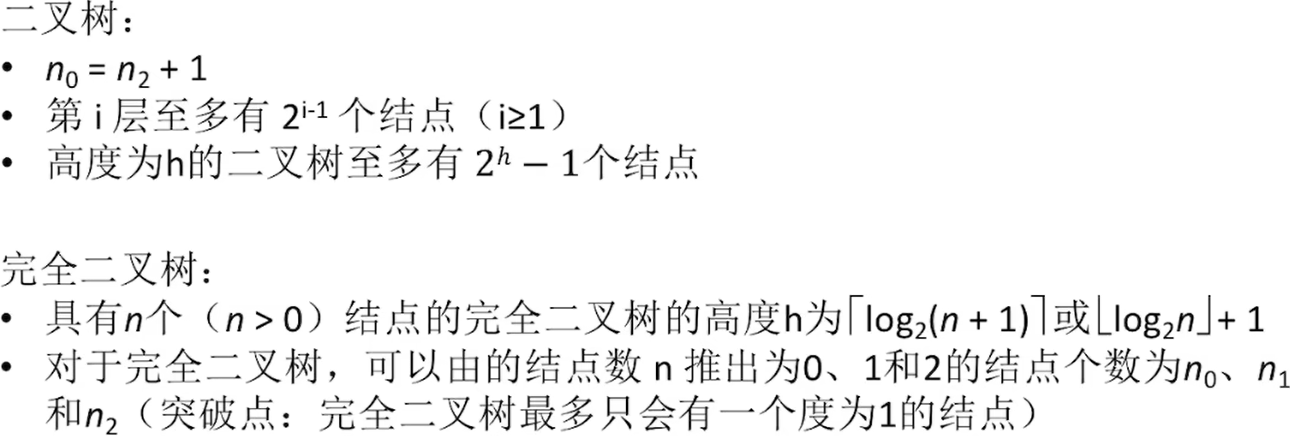
1、二叉树的常考性质
2、完全二叉树的常考性质

有k个结点,n0=k/2向上取整,n1=0/1,n2=k/2向下取整
3、知识回顾
5.2.3二叉树的存储结构
1、顺序存储
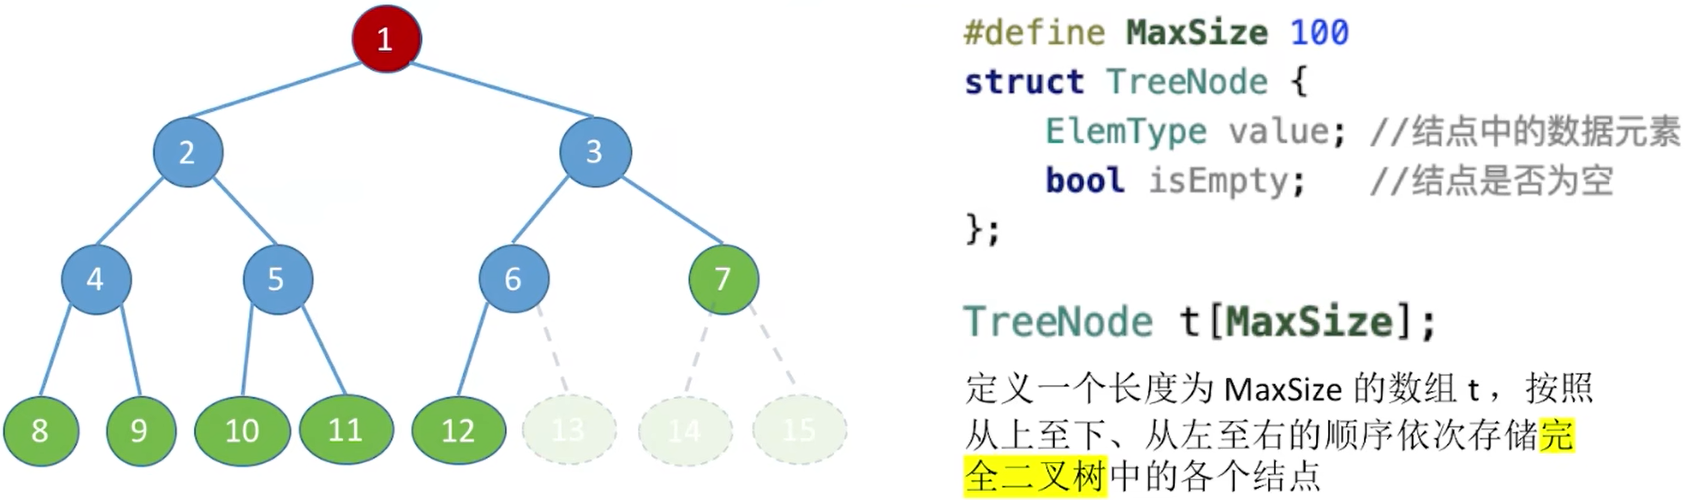
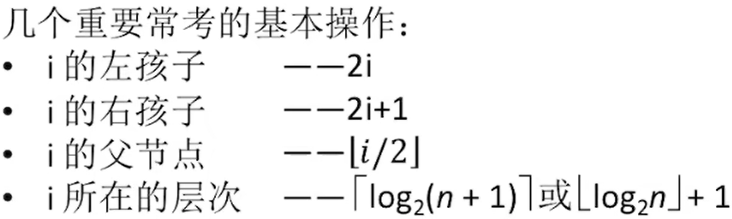
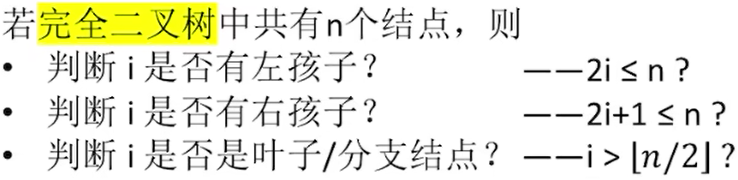
二叉树的顺序存储结构,只适合存储完全二叉树
2、链式存储
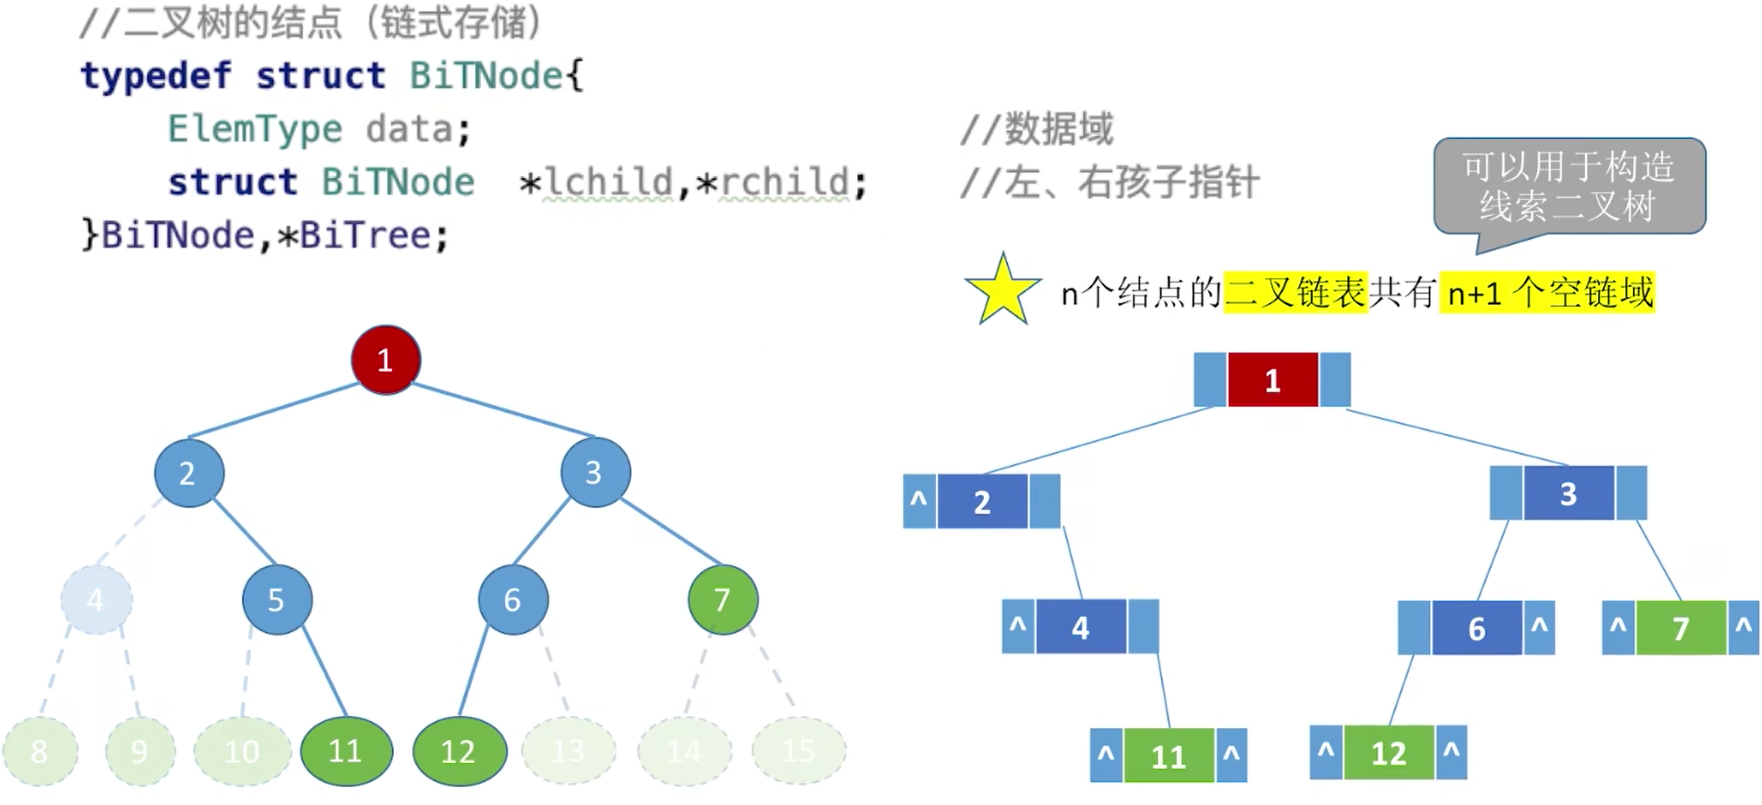
5.3二叉树的遍历和线索二叉树
5.3.1二叉树的先中后序遍历
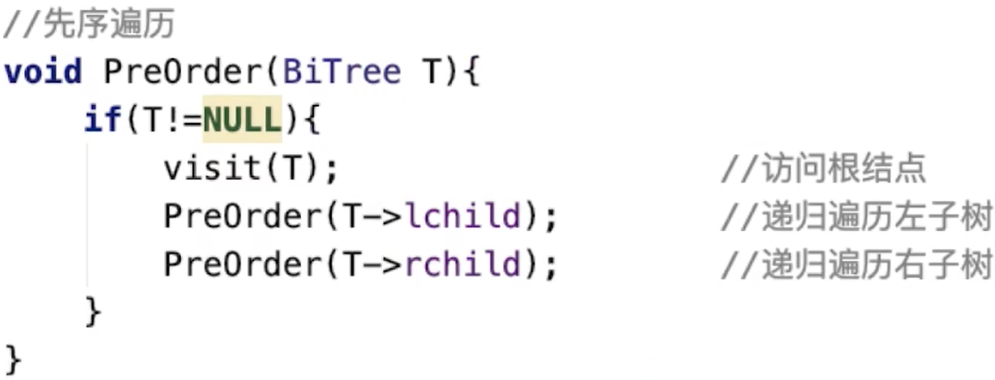
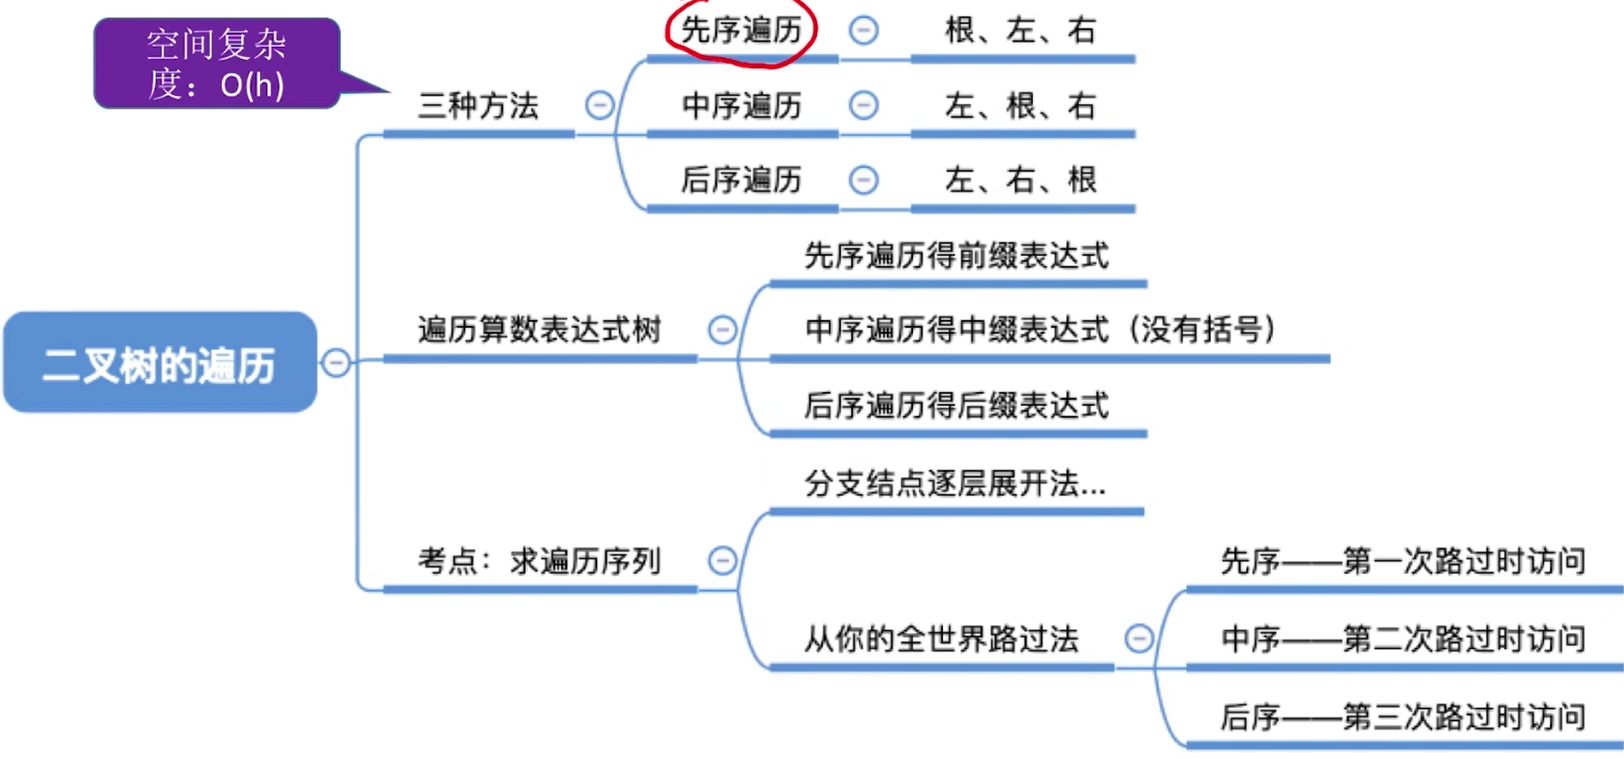
1、先序遍历(中左右)
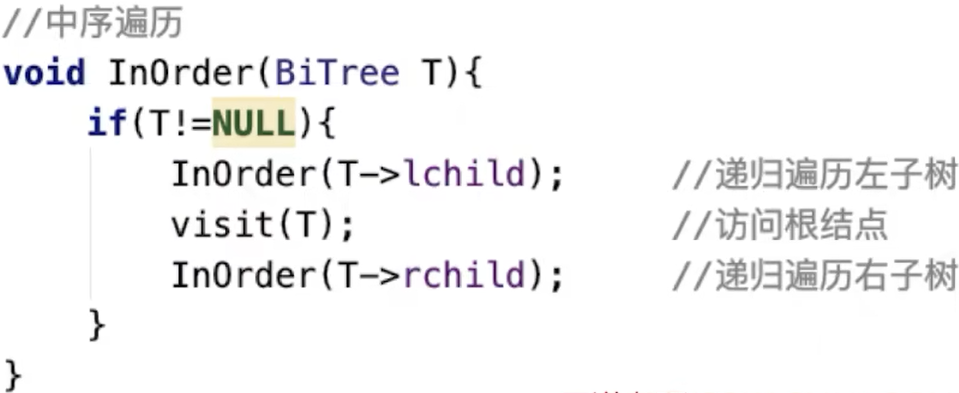
2、中序遍历(左中右)
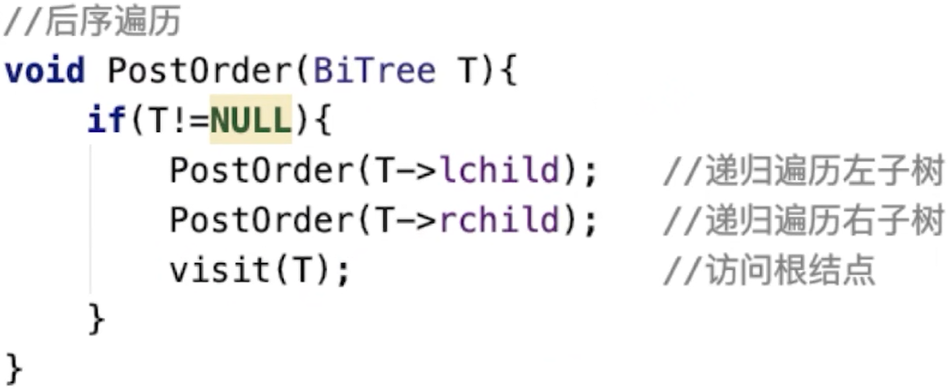
3、后序遍历(左右中)
4、知识回顾
5.3.2二叉树的层次遍历
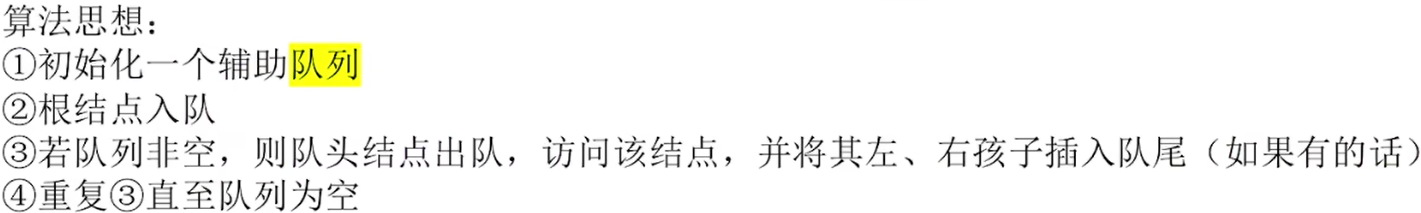
1、算法思想
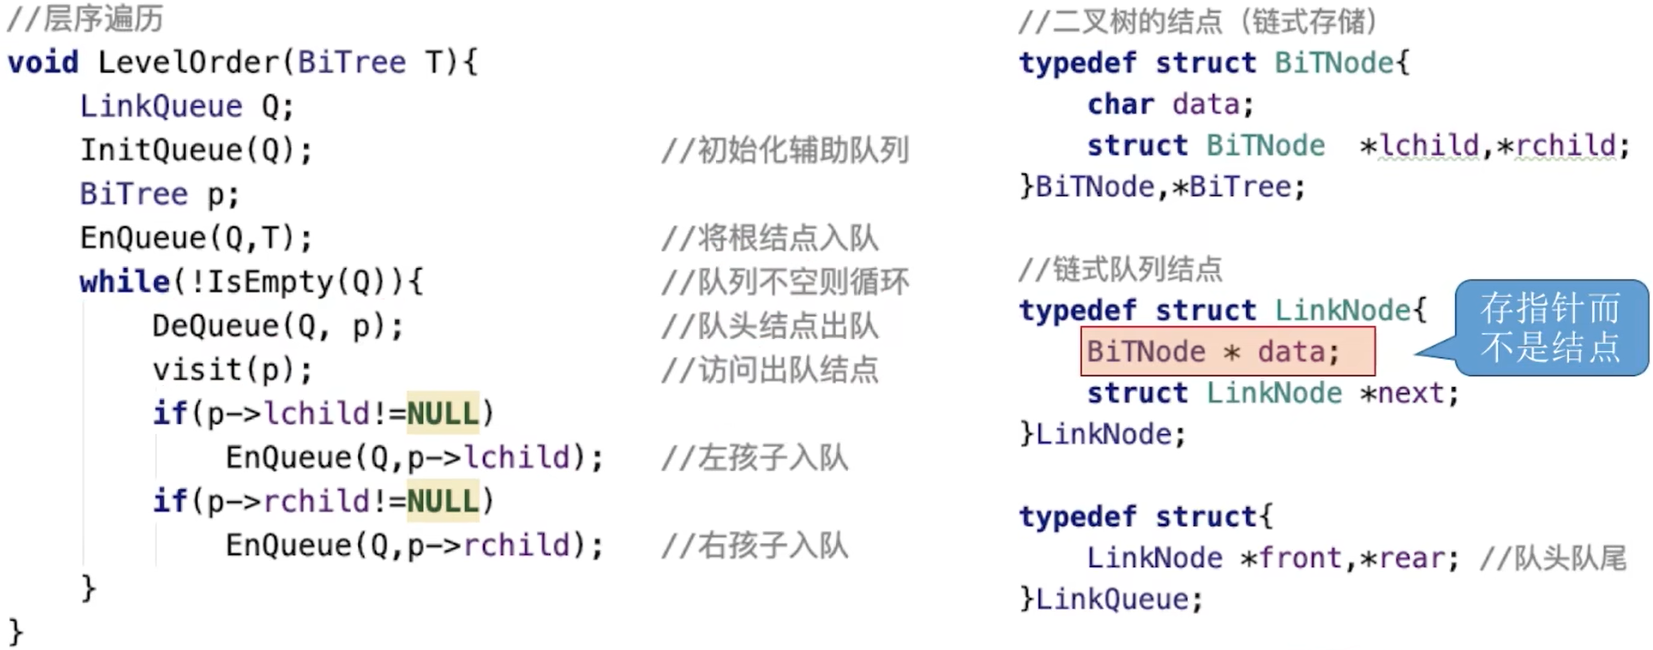
2、代码实现
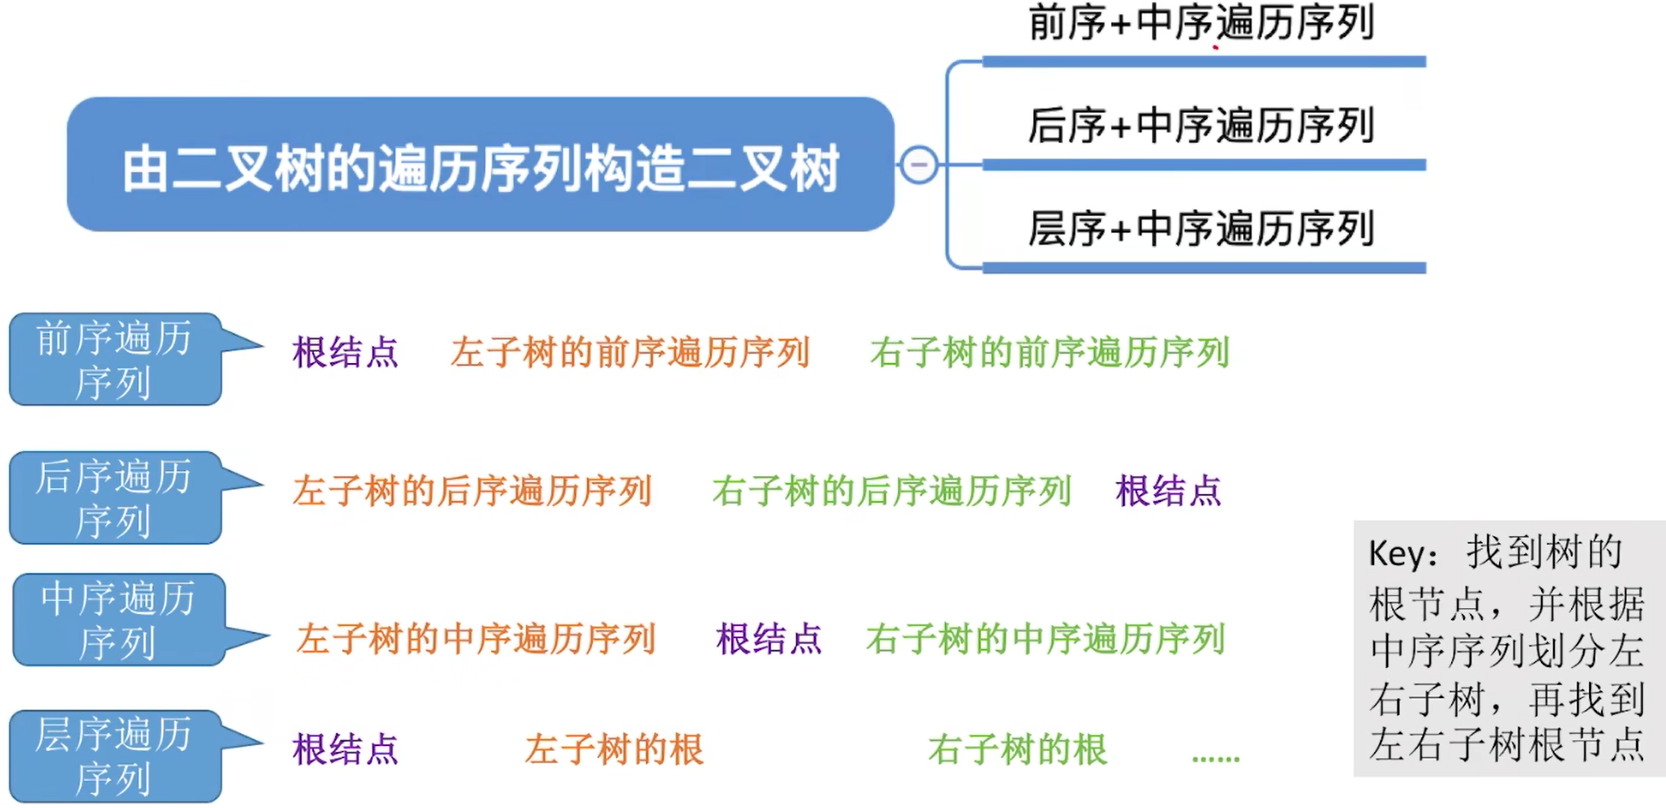
5.3.3由遍历序列构造二叉树
1、知识回顾
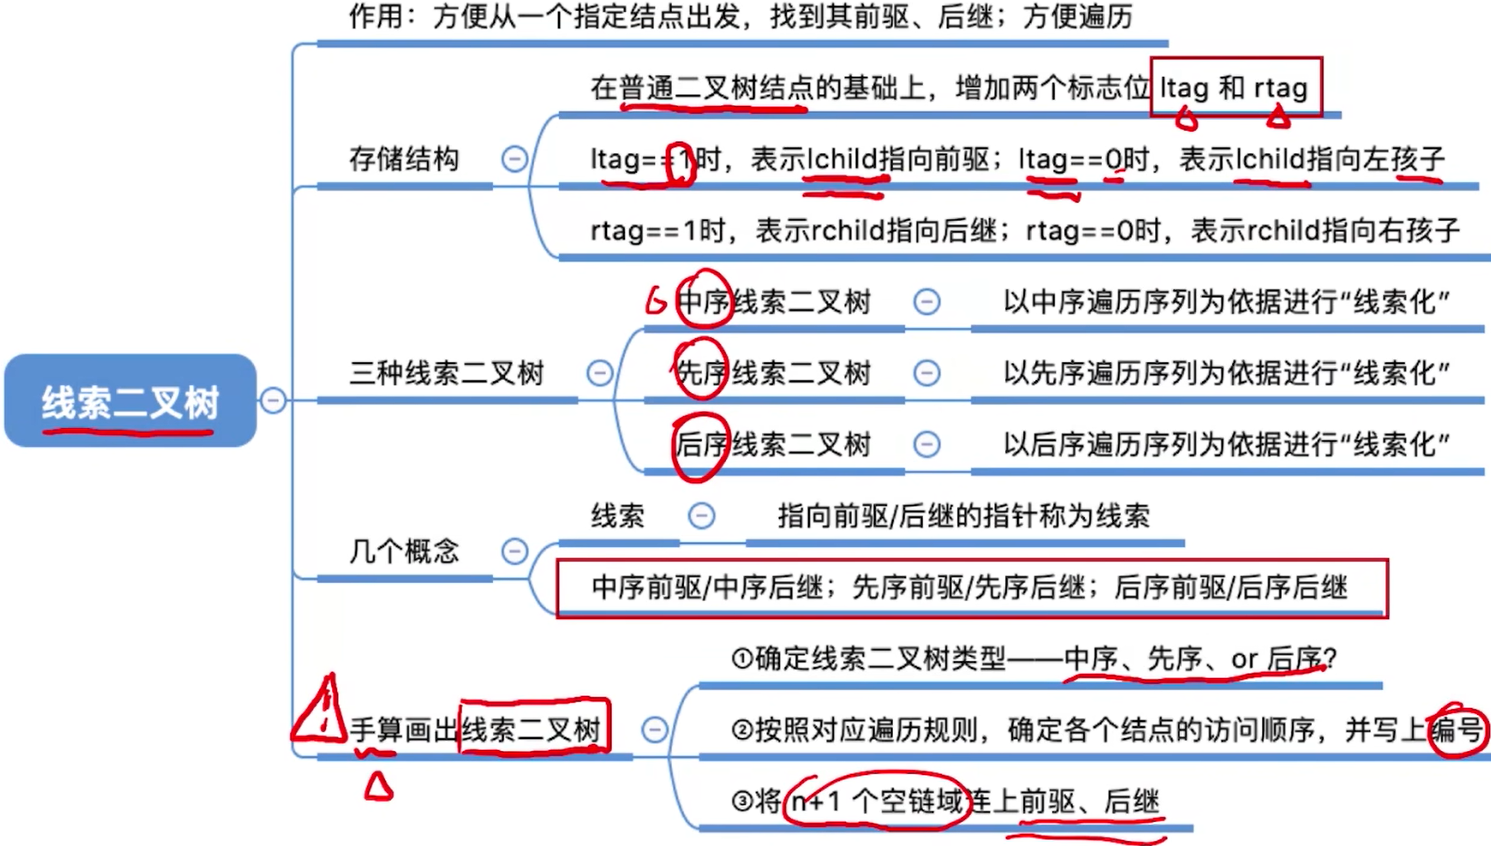
5.3.4线索二叉树的概念
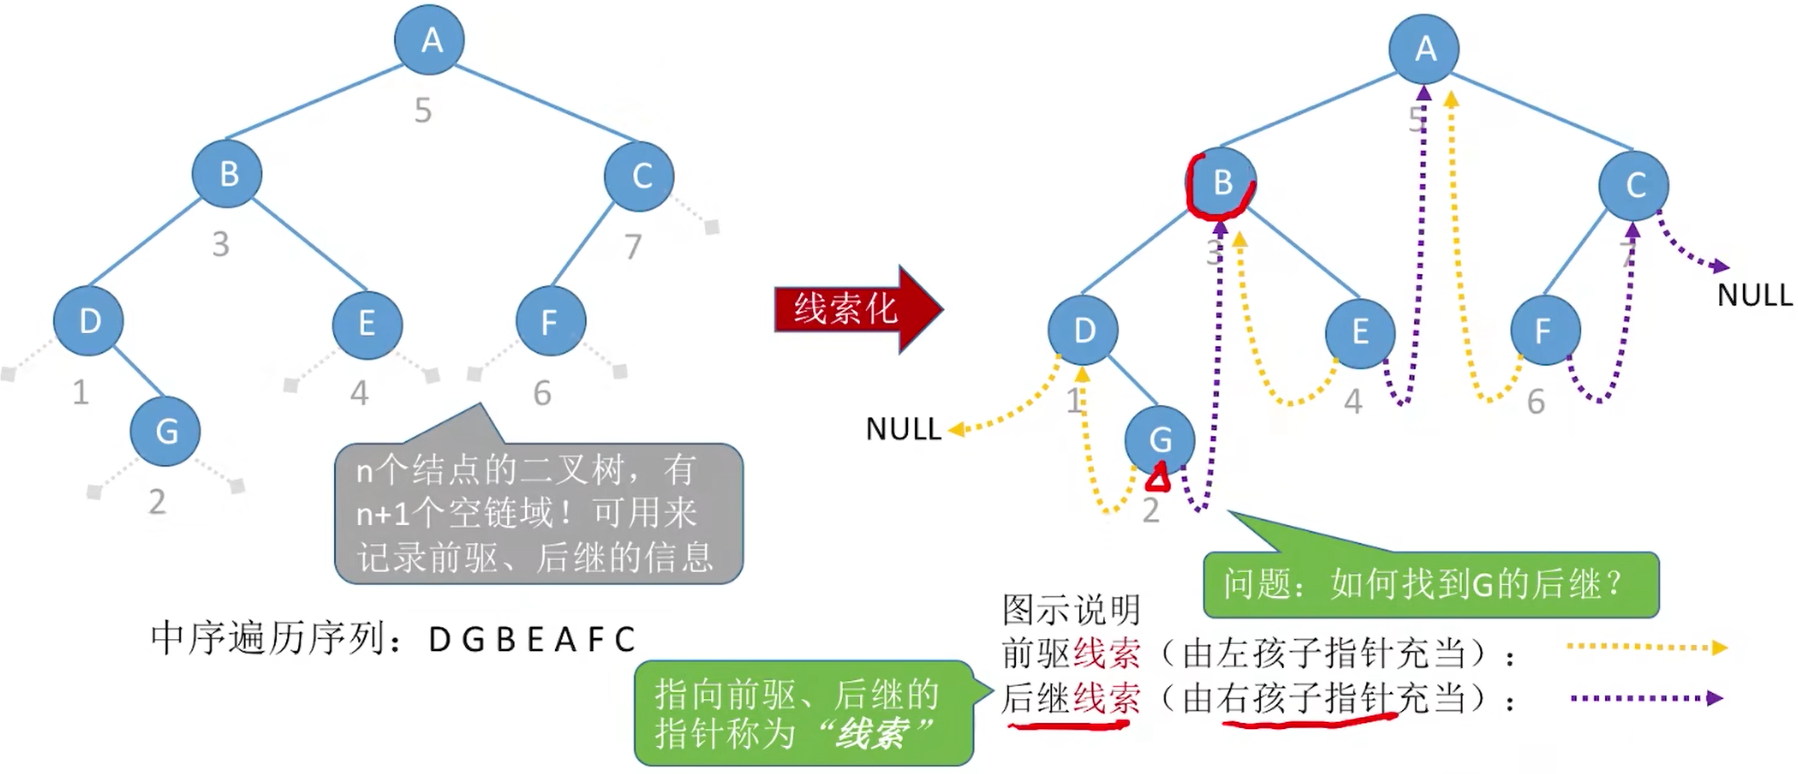
建立线索的意义是为了更方便的找到前驱和后继
1、中序线索二叉树
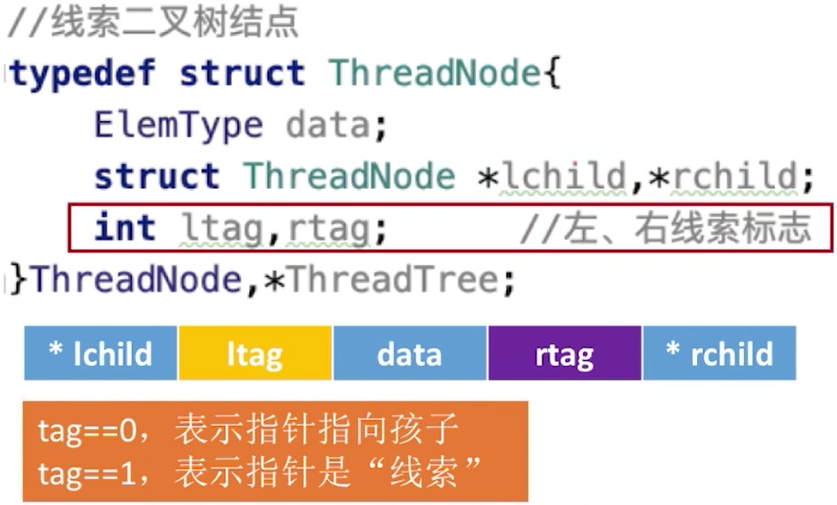
2、线索链表
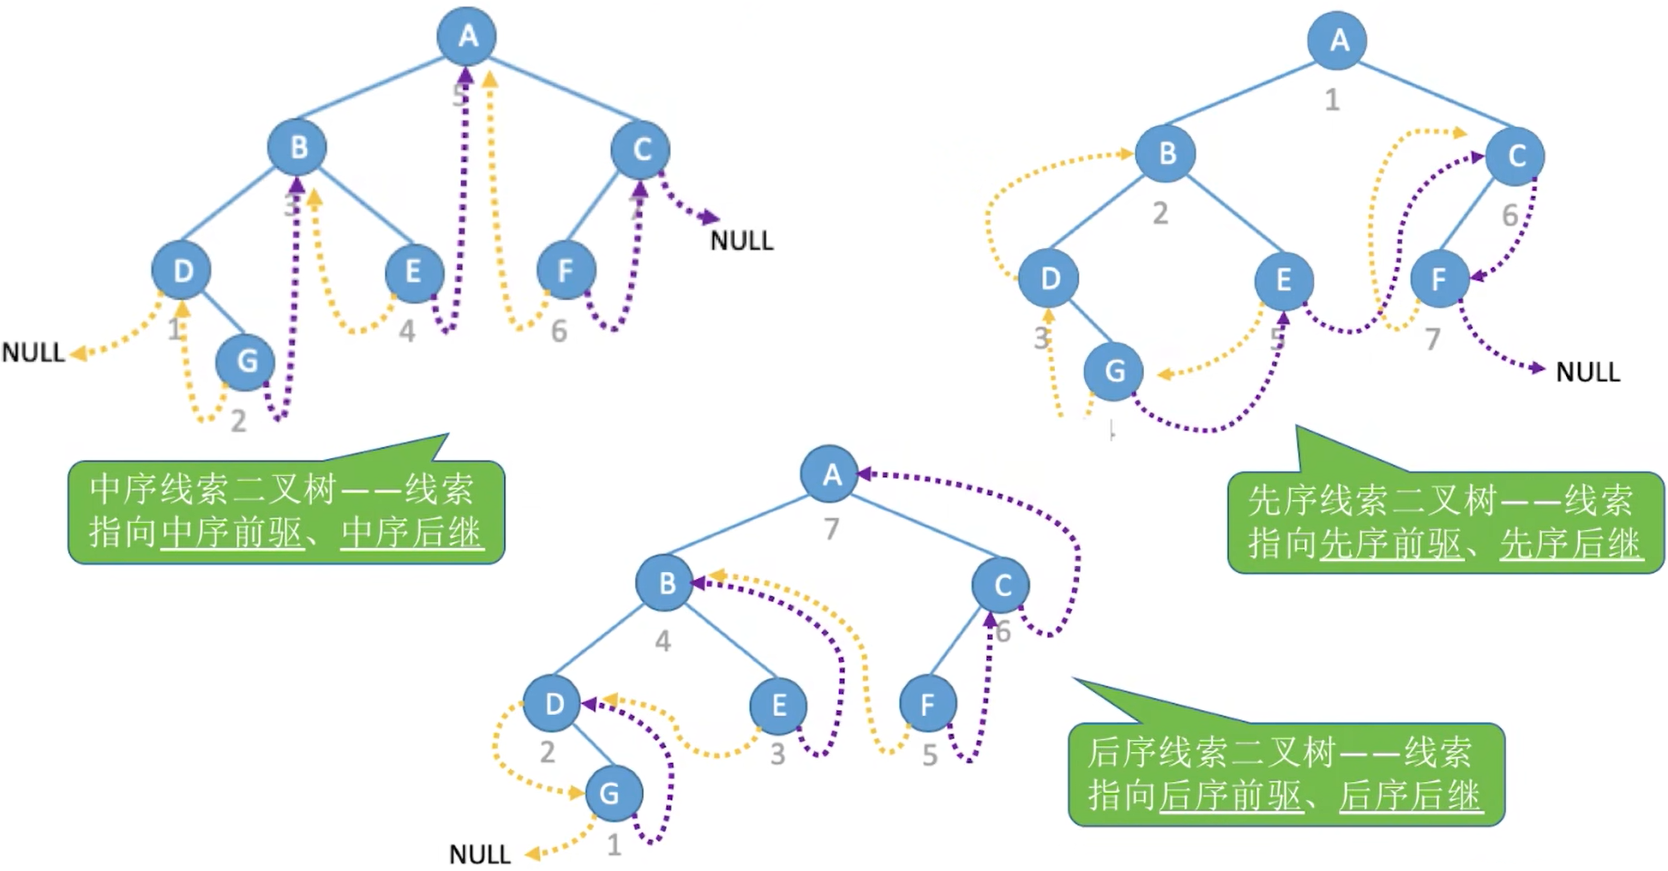
3、三种线索二叉树的对比
4、知识回顾
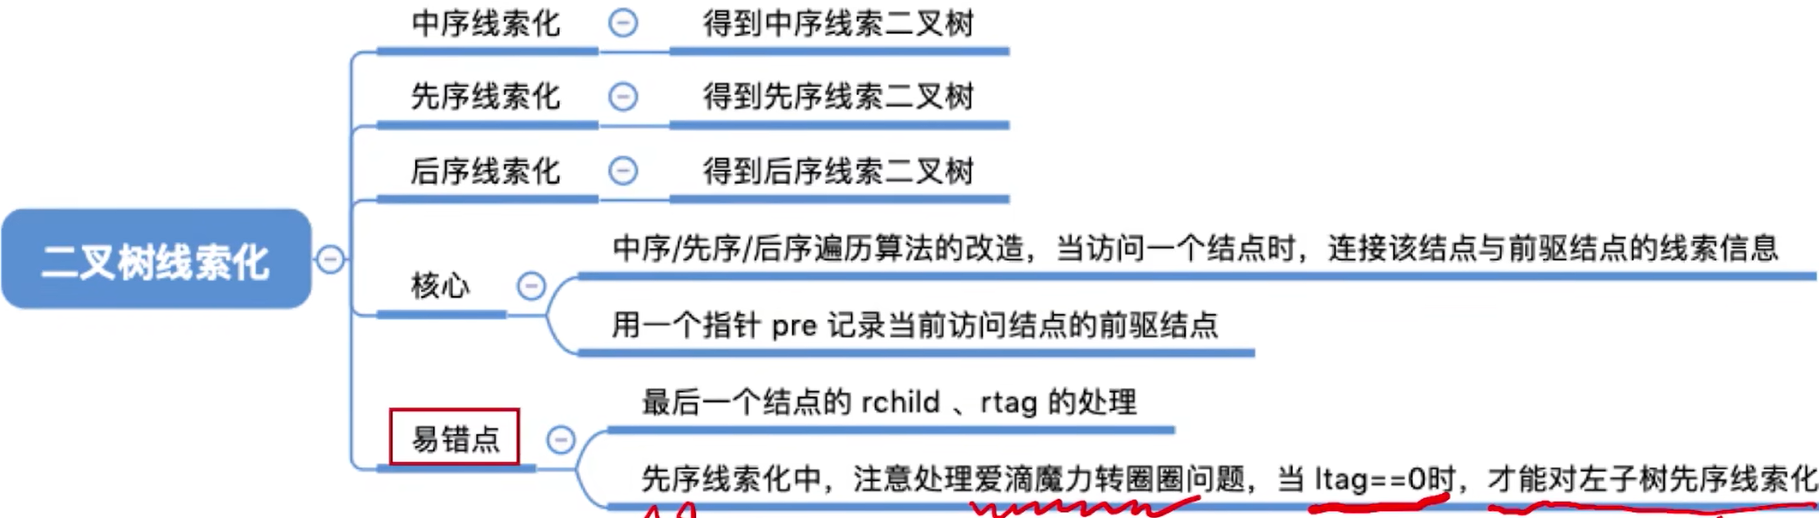
5.3.5二叉树的线索化
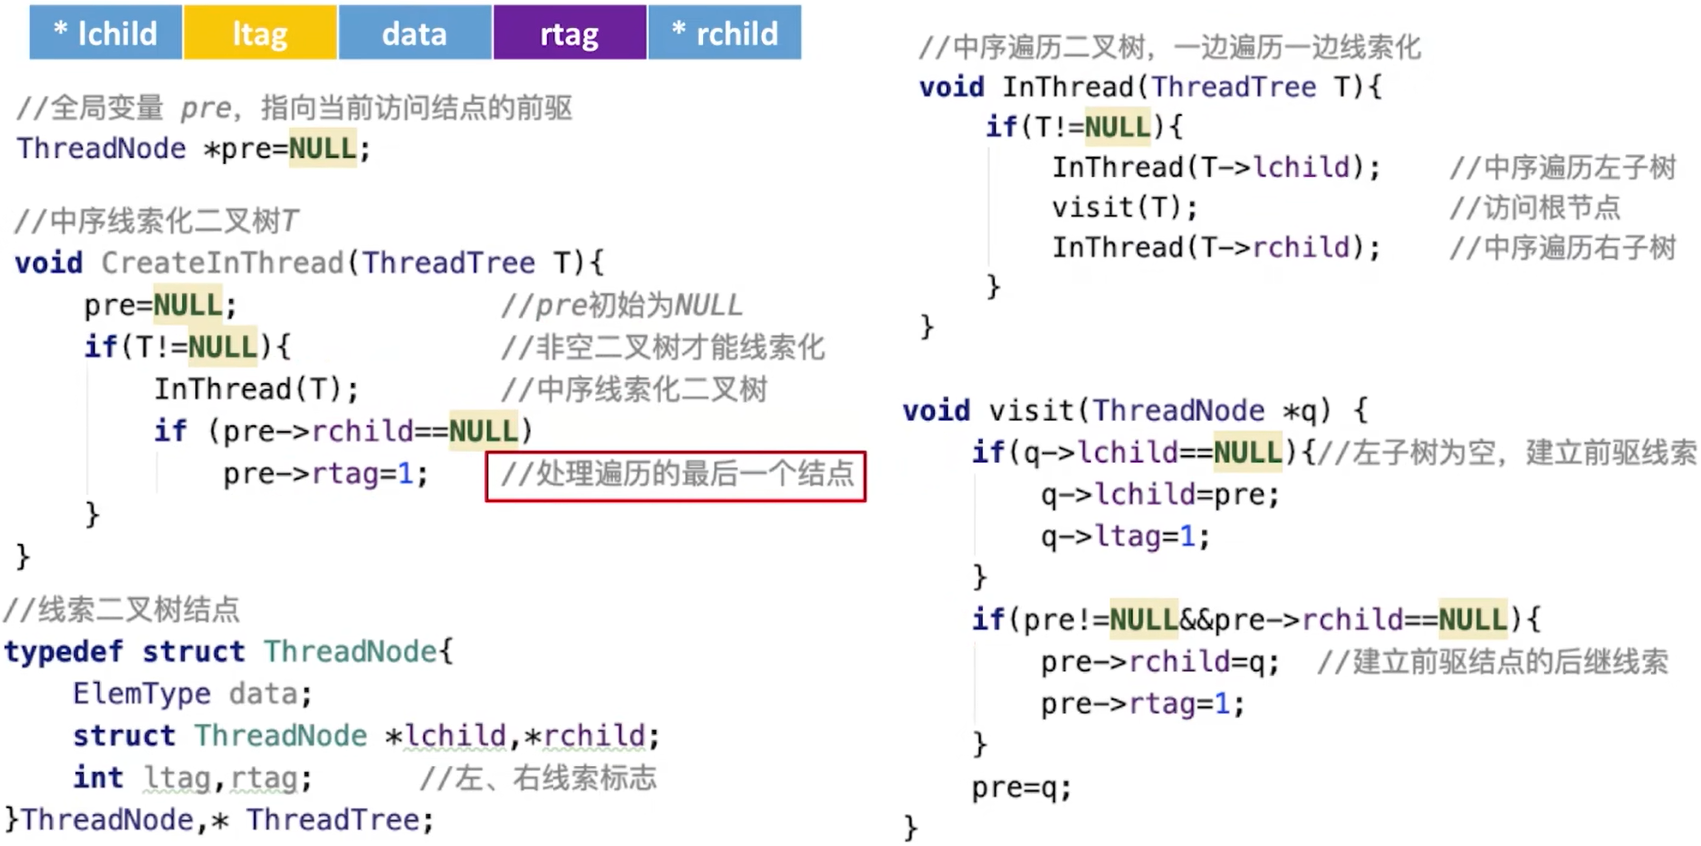
1、中序线索化
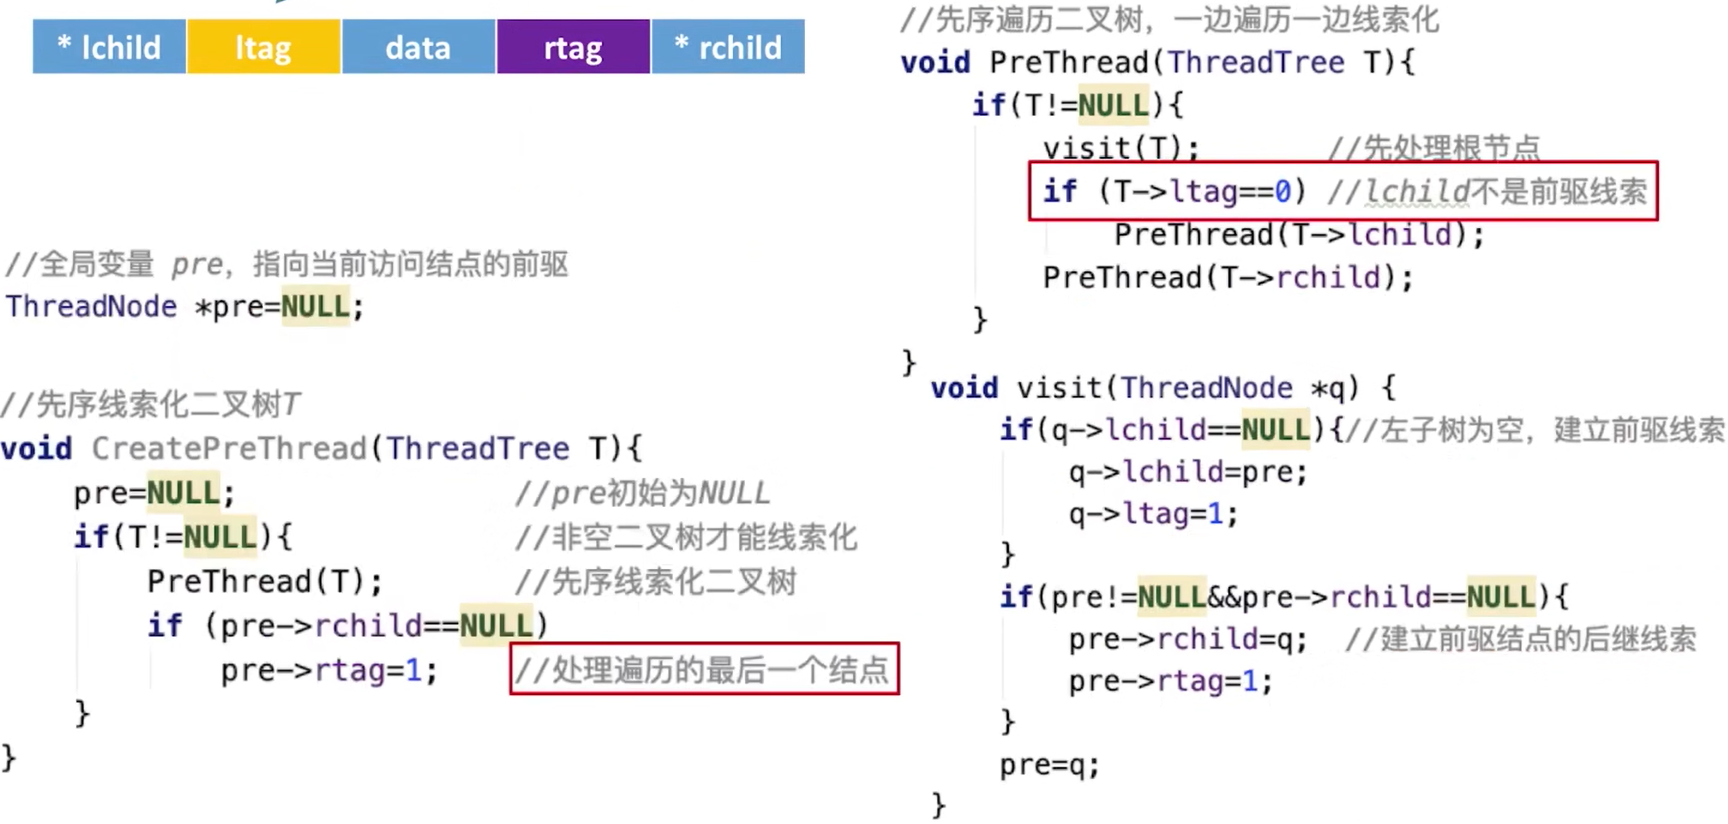
2、先序线索化
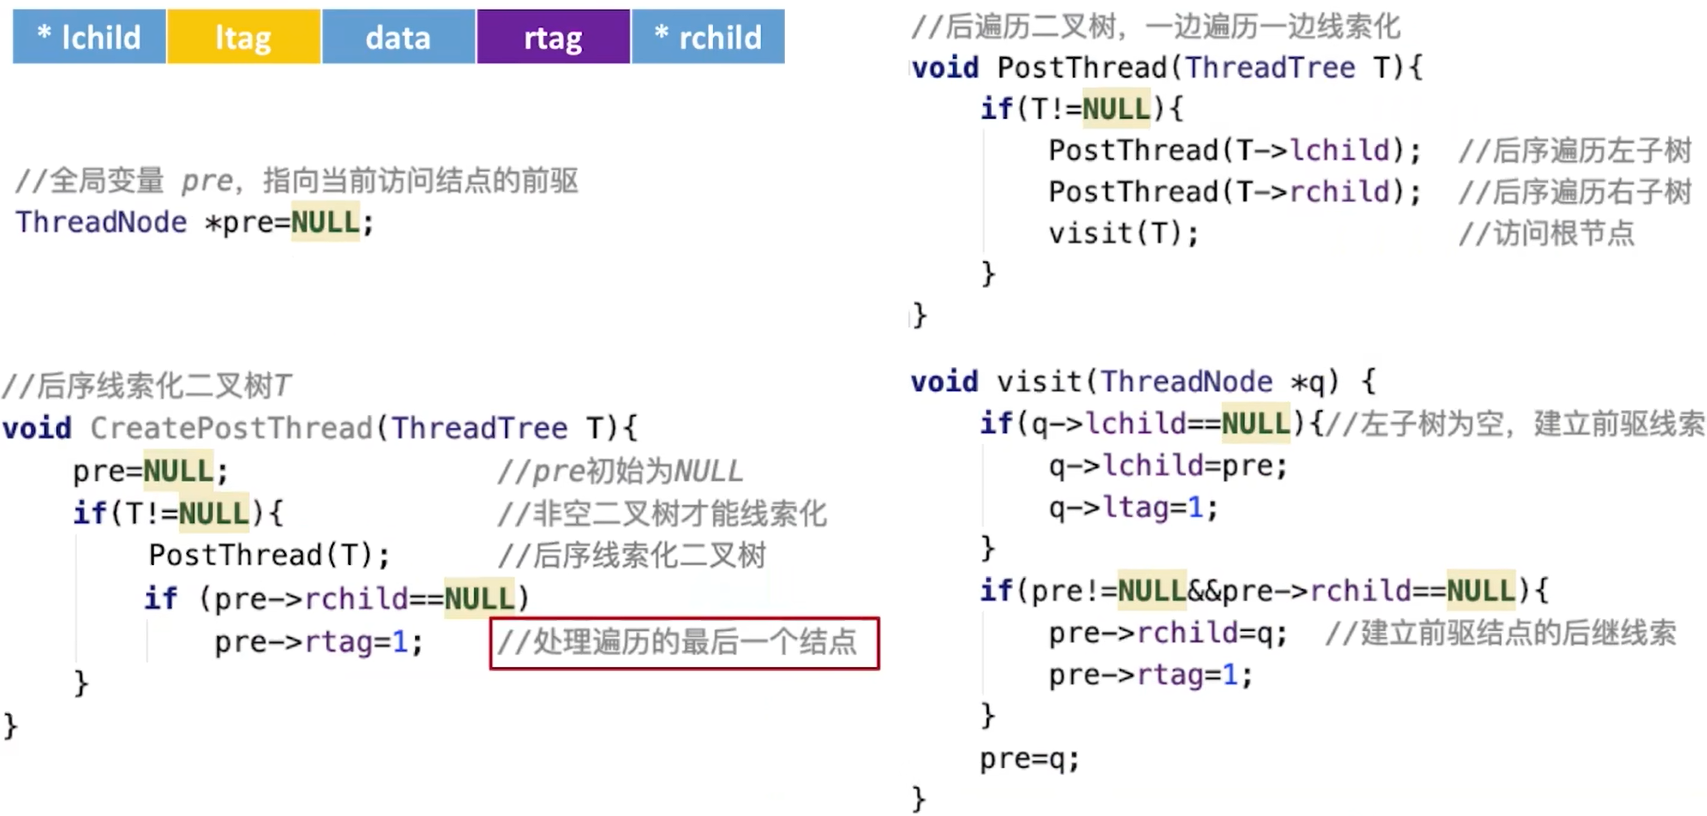
3、后序线索化
4、知识回顾
5.3.6在线索二叉树中找前驱后继
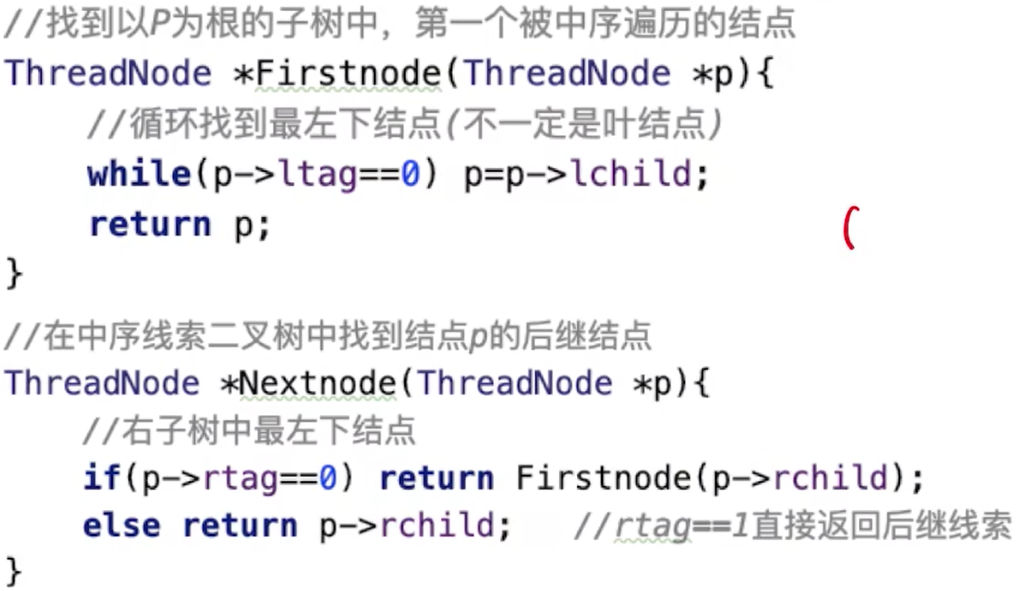
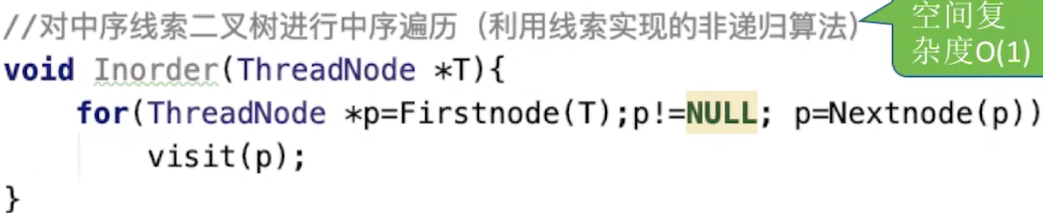
1、中序线索二叉树找中序后继
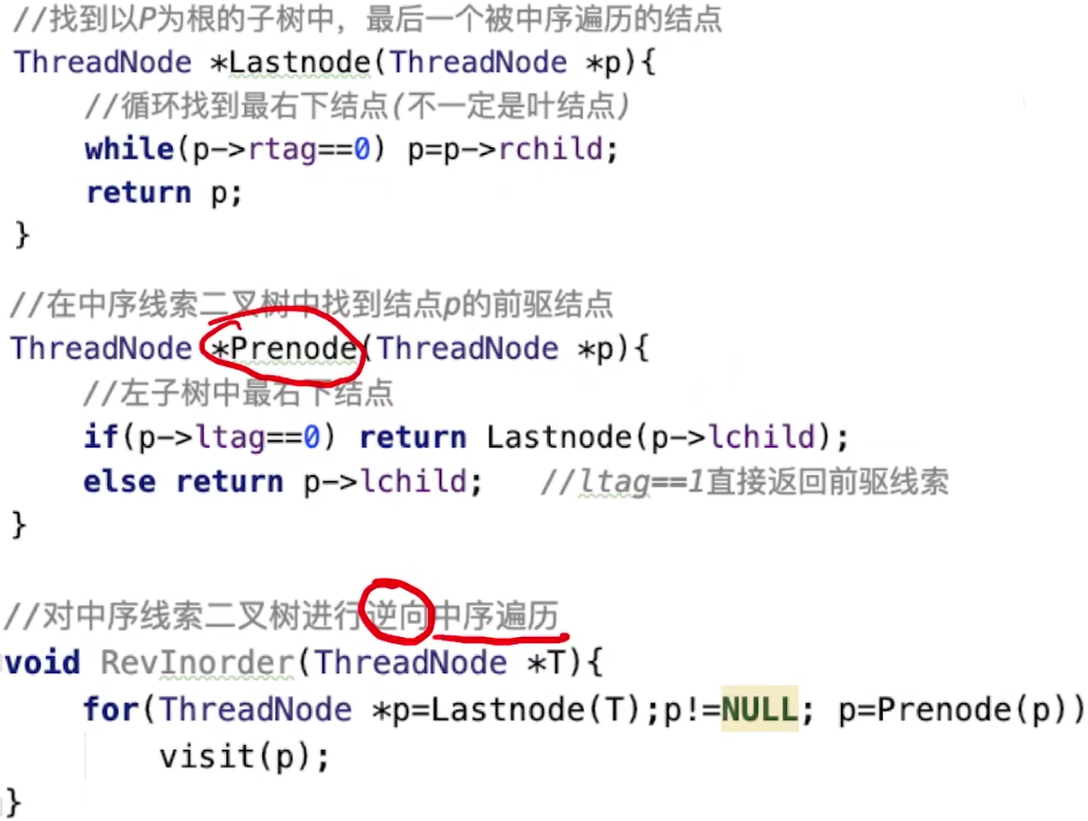
2、中序线索二叉树找中序前驱
3、先序线索二叉树找先序后继
若p有左孩子,则先序后继为左孩子
若p有右孩子,则先序后继为右孩子
4、先序线索二叉树找先序前驱
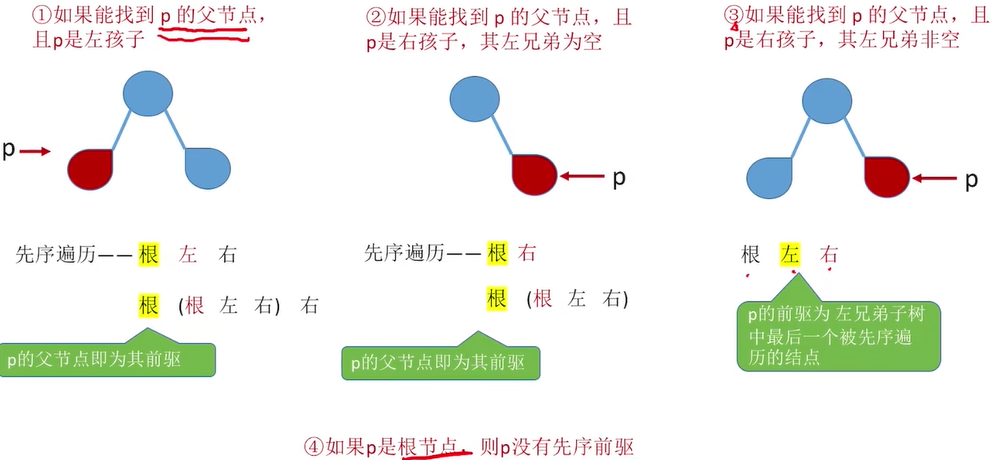
5、后序线索二叉树找后序前驱
若p有右孩子,则后序前驱为右孩子
若p没有右孩子,则后序前驱为左孩子
6、后序线索二叉树找后序后继
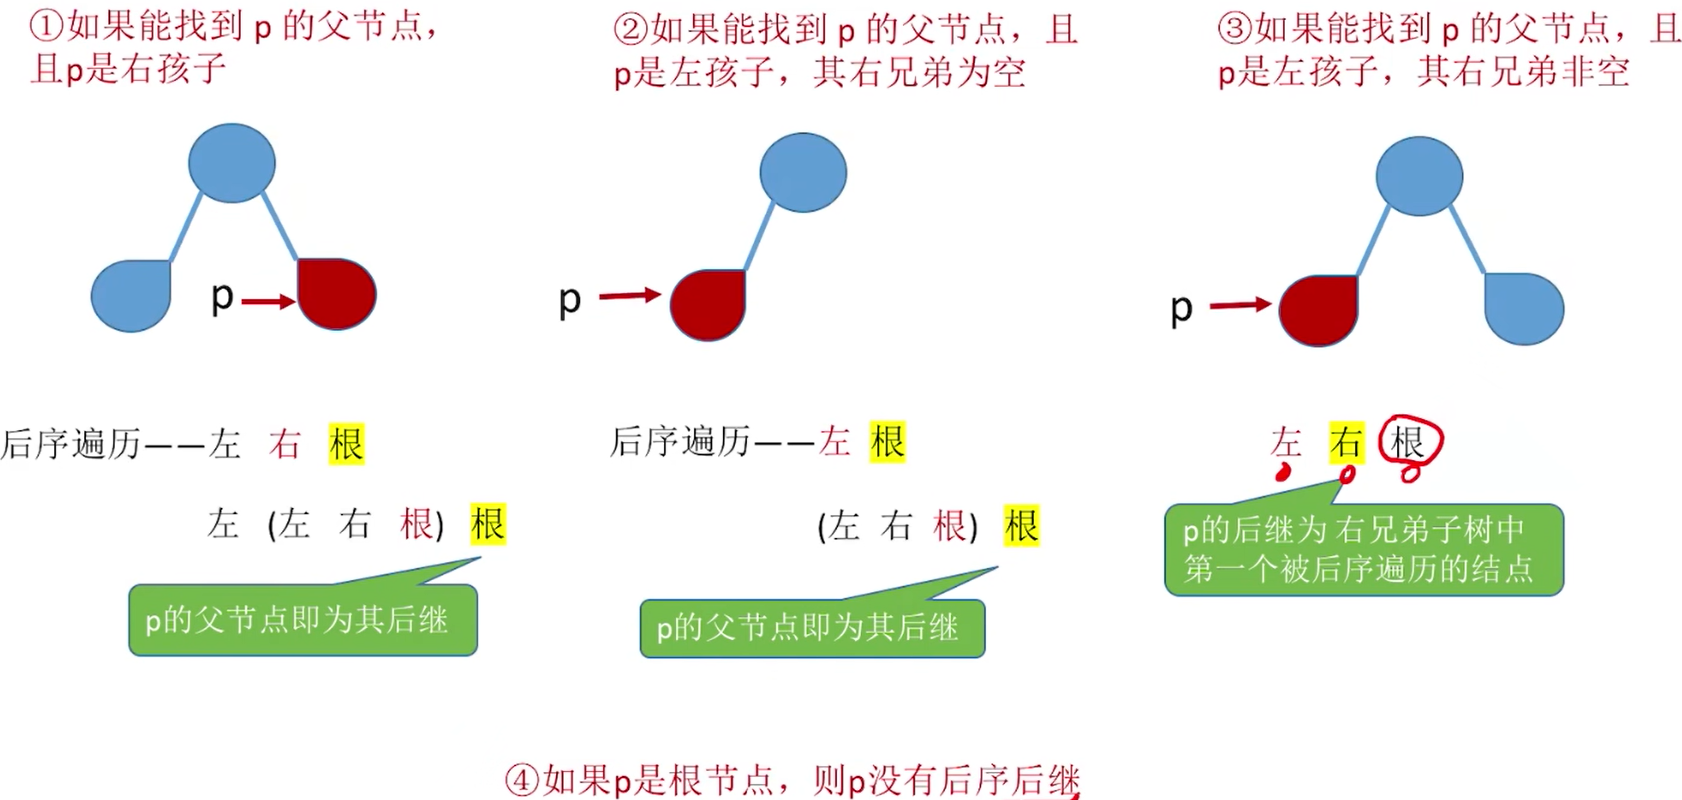
7、知识回顾

5.4树、森林
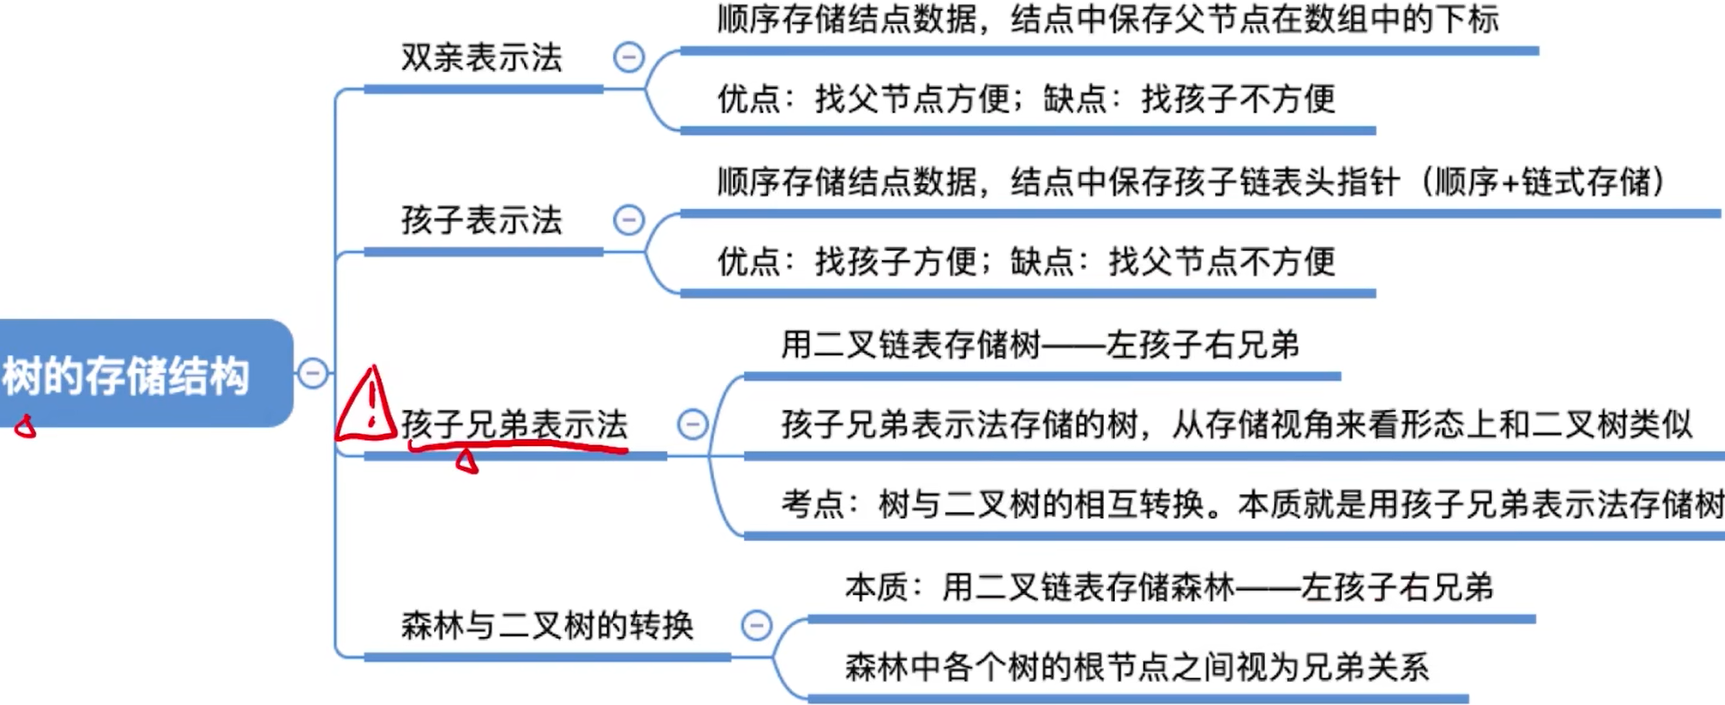
5.4.1树的存储结构
1、双亲表示法(顺序存储)
双亲表示法:每个结点中保存指向双亲的“指针”
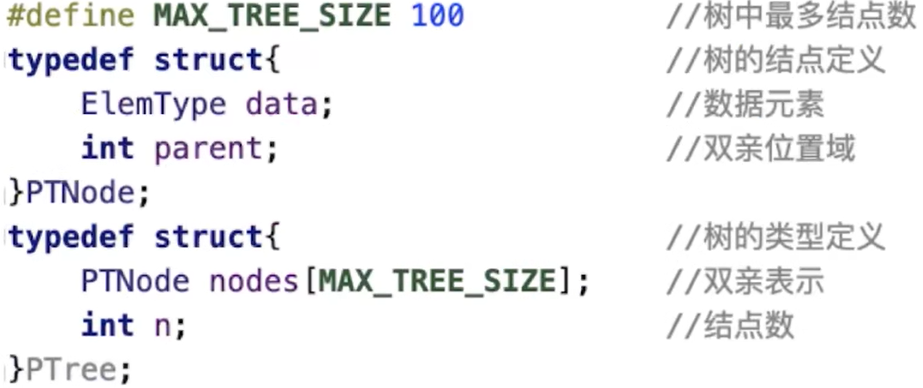
新增数据元素无需按逻辑上的次序存储
优点:查指定结点的双亲很方便
缺点:查指定结点的孩子只能从头遍历
2、孩子表示法(顺序+链式存储)
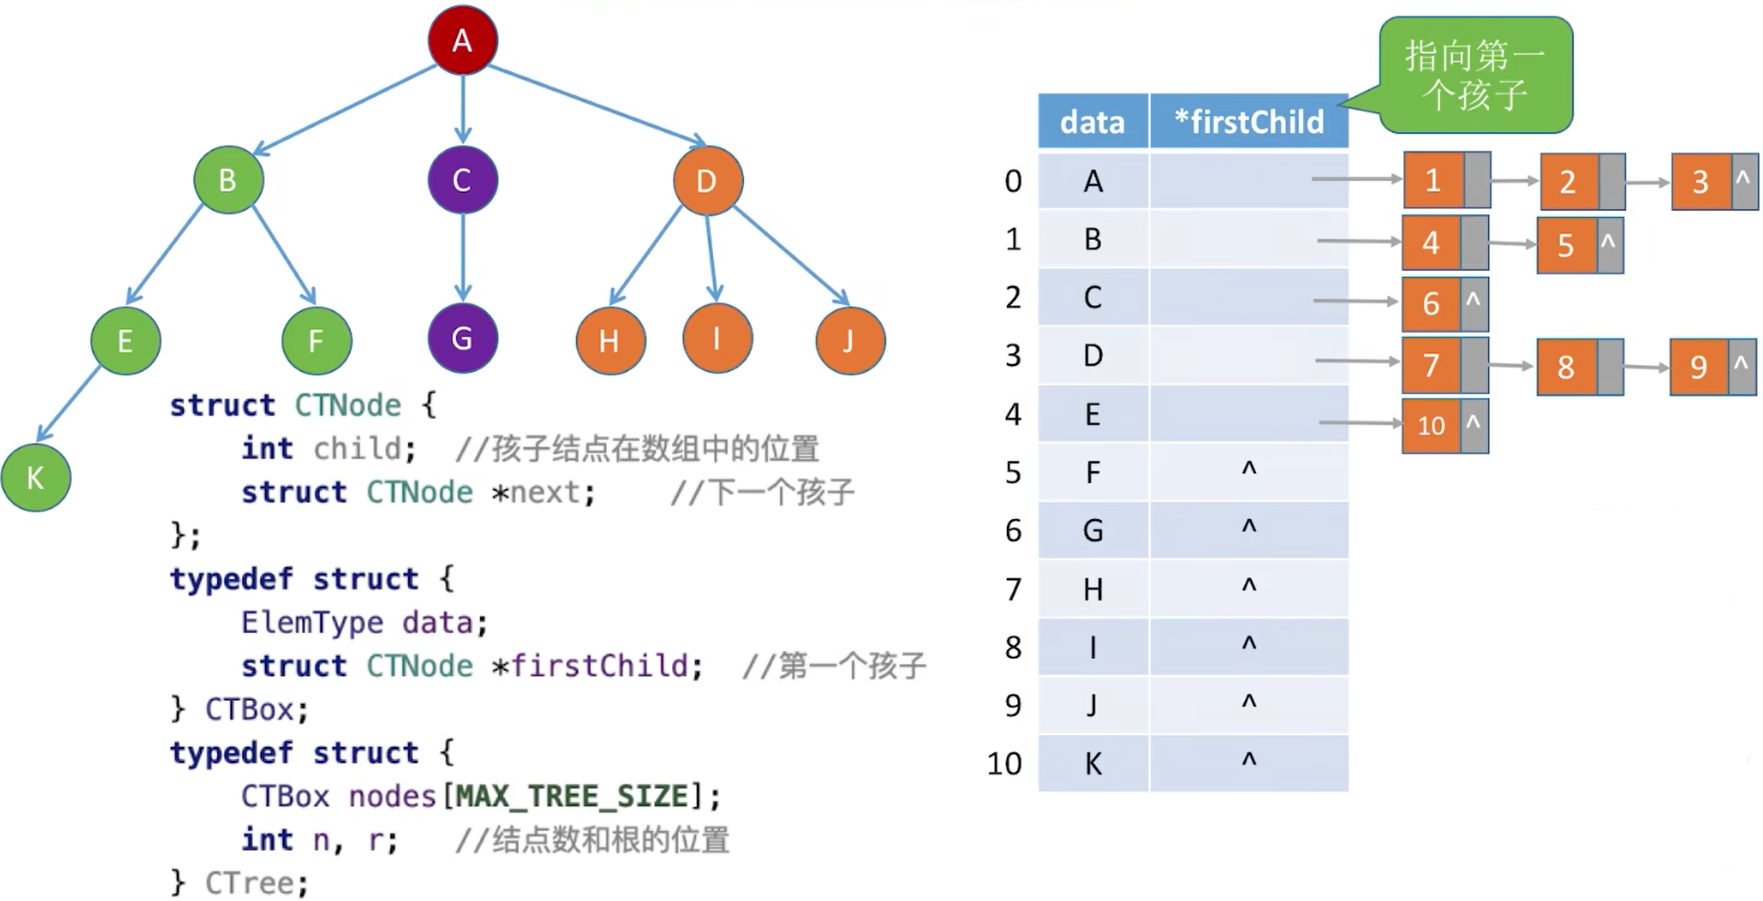
优点:查指定结点的孩子很方便
缺点:查指定结点的双亲不方便
3、孩子兄弟表示法(链式存储)
3.1、树和二叉树的转化
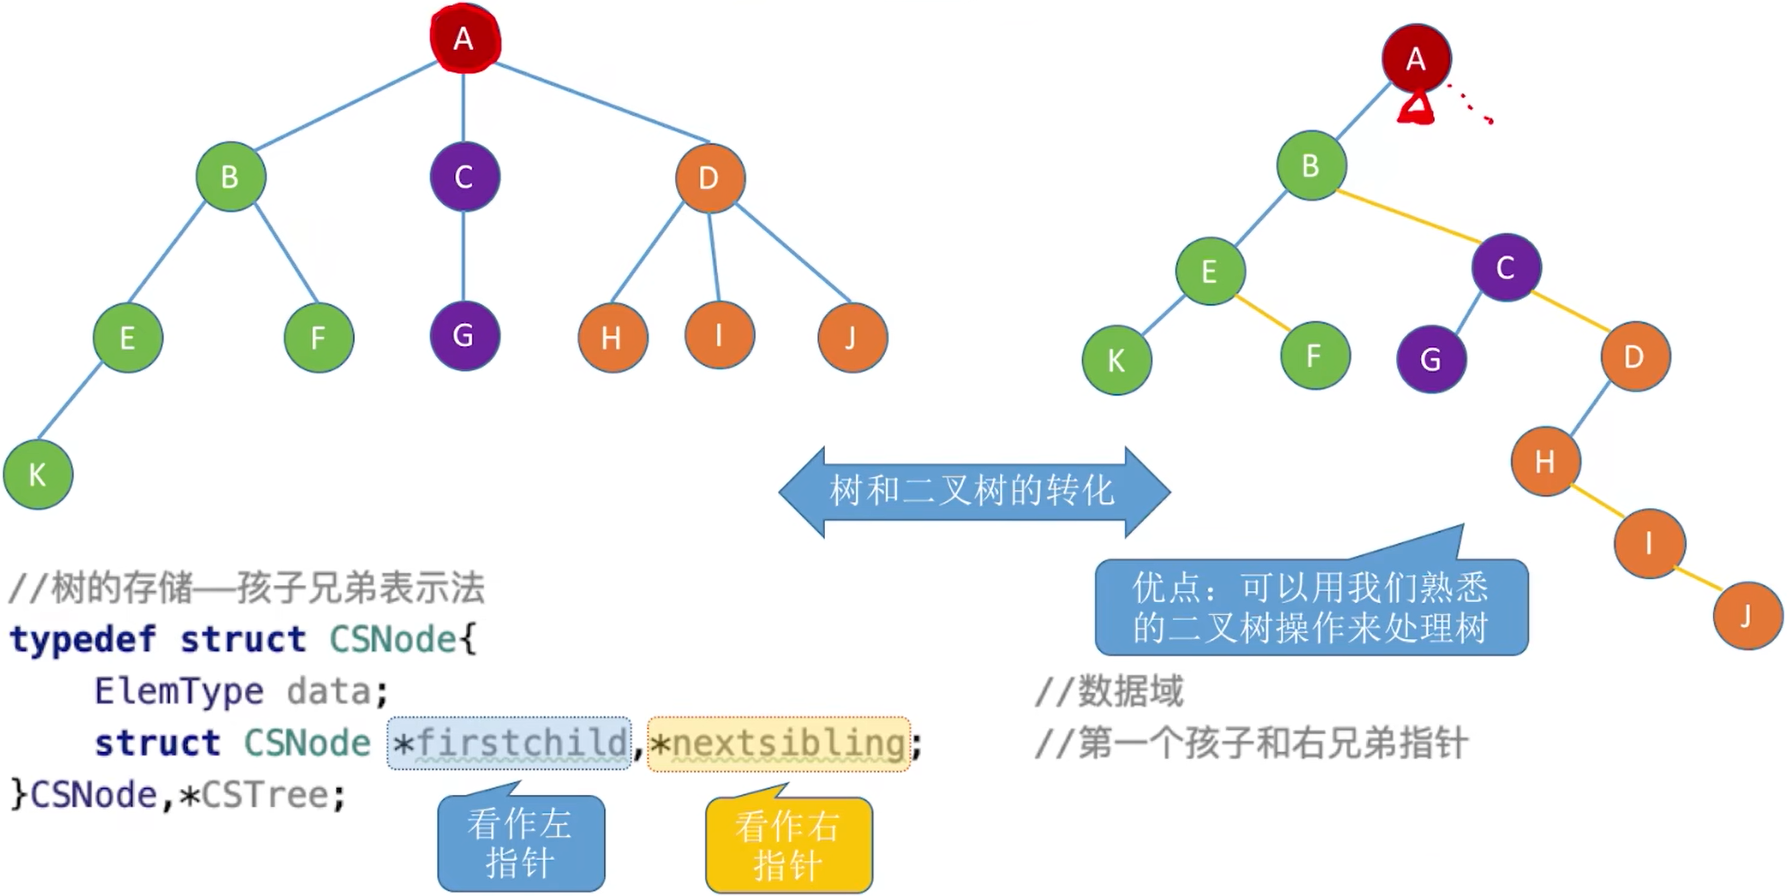
左孩子,右兄弟
3.2、森林和二叉树的转化
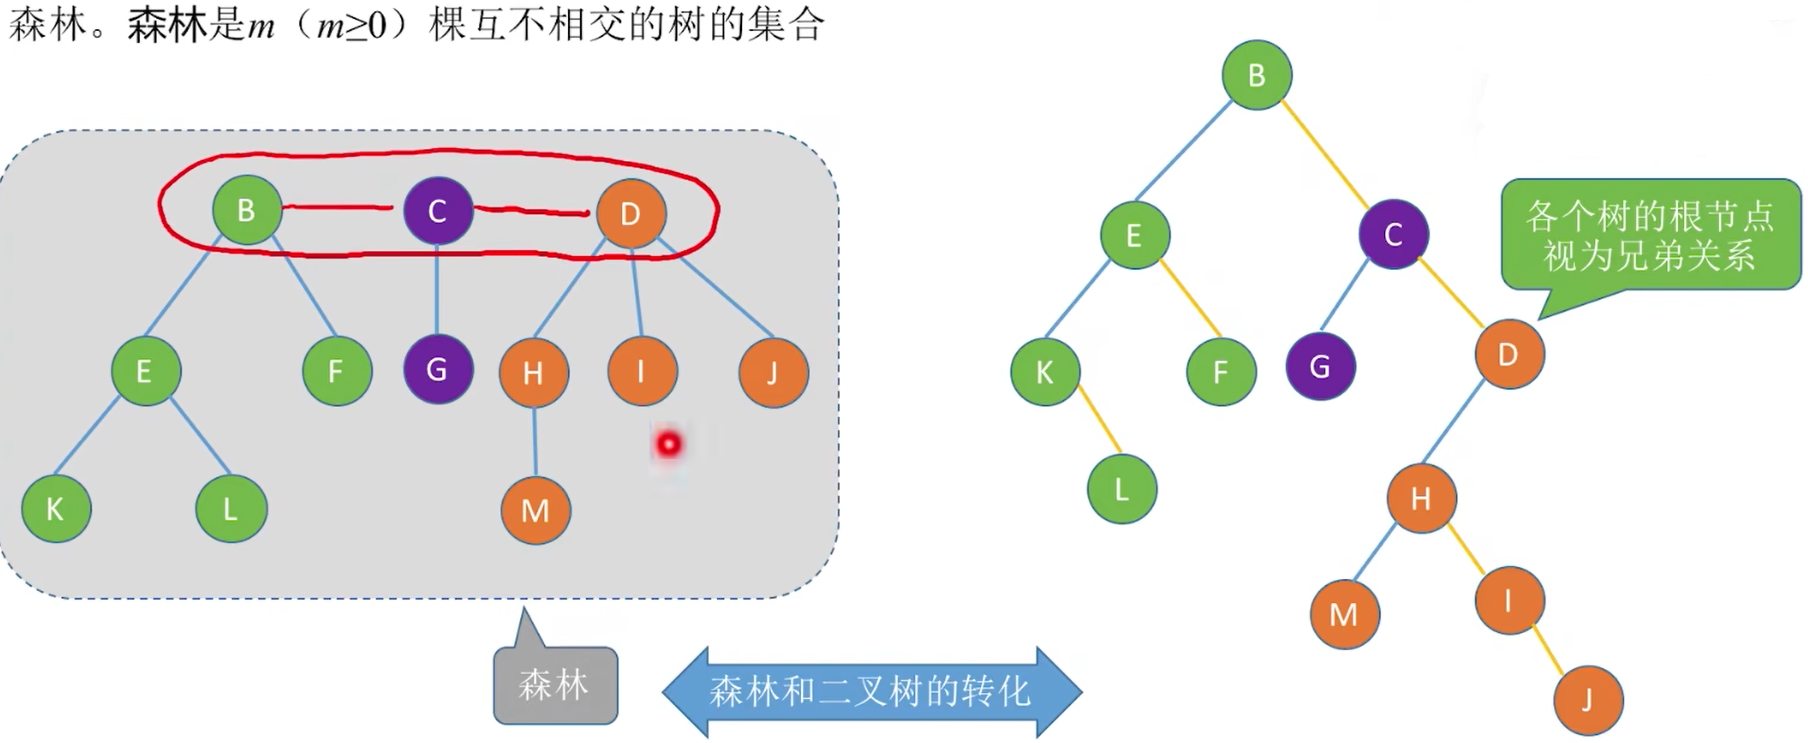
4、知识回顾
5.4.2树和森林的遍历
1、树的遍历
1.1、先根遍历
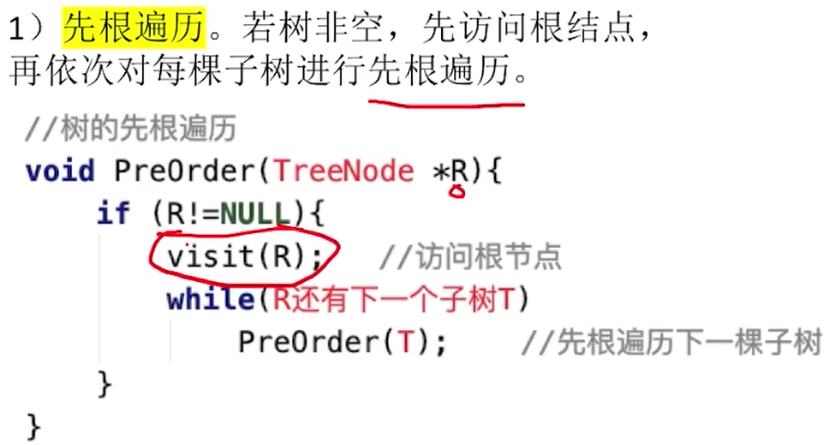
树的先根遍历序列与这棵树相应的二叉树的先序序列相同
1.2、后根遍历
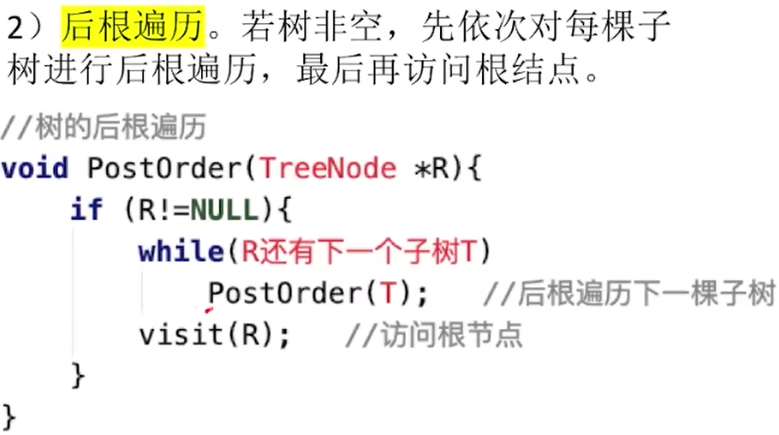
树的后根遍历序列与这棵树相应的二叉树的中序序列相同
2、森林的遍历
2.1、先序遍历森林
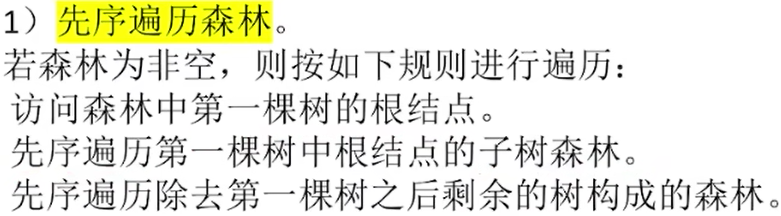
效果等同于依次对各个树进行先根遍历,等同于依次对二叉树的先序遍历
2.2、中序遍历森林
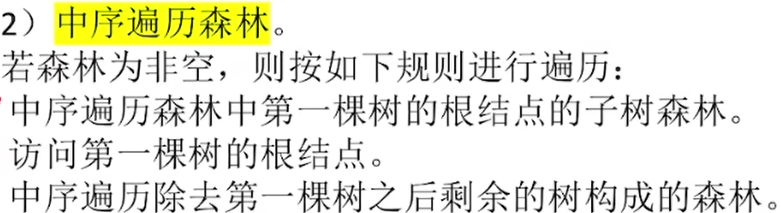
效果等同于依次对各个树进行后根遍历,等同于依次对二叉树的中序遍历
5.5树和二叉树的应用
5.5.1二叉排序树
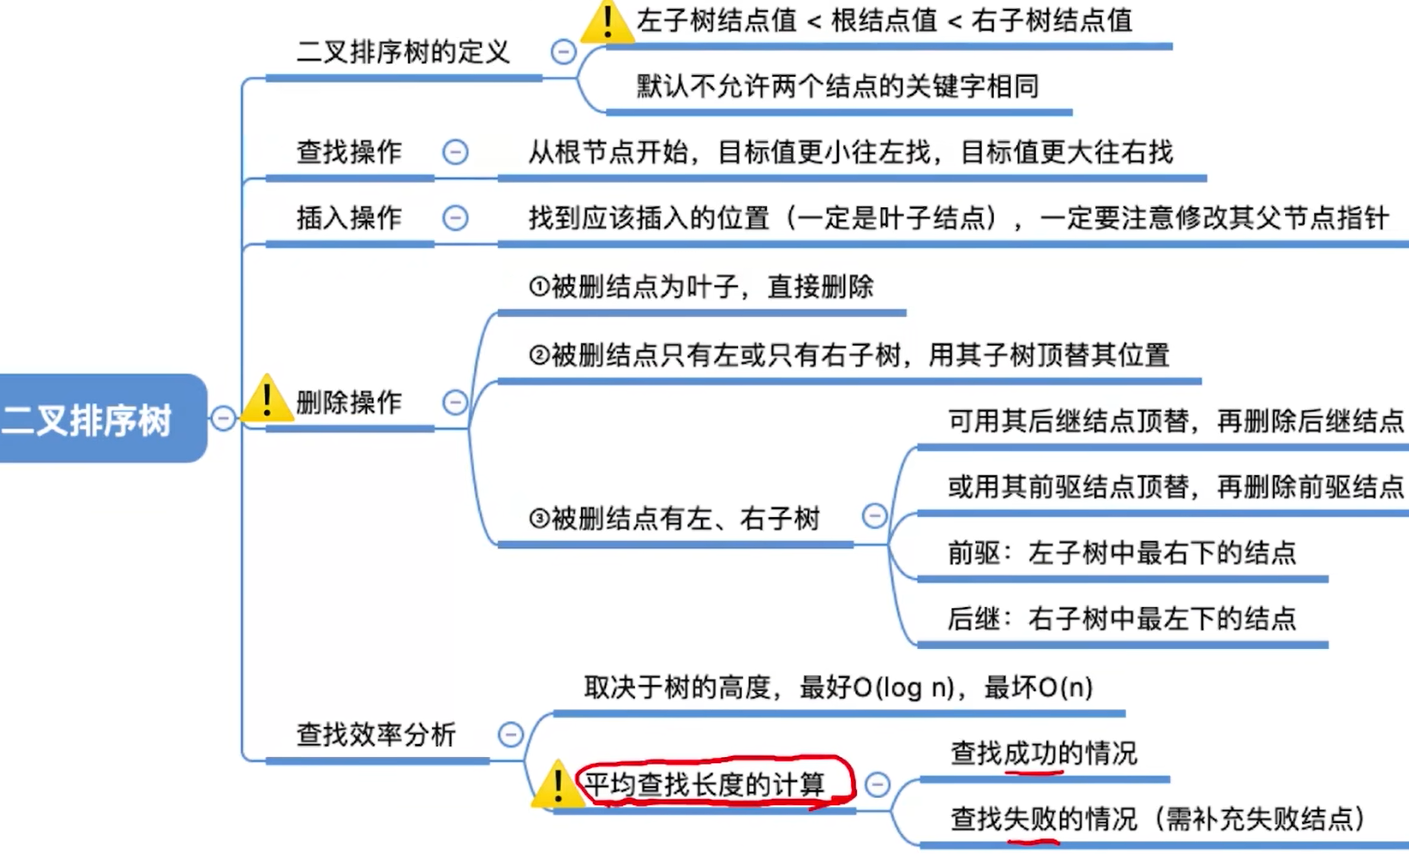
1、定义
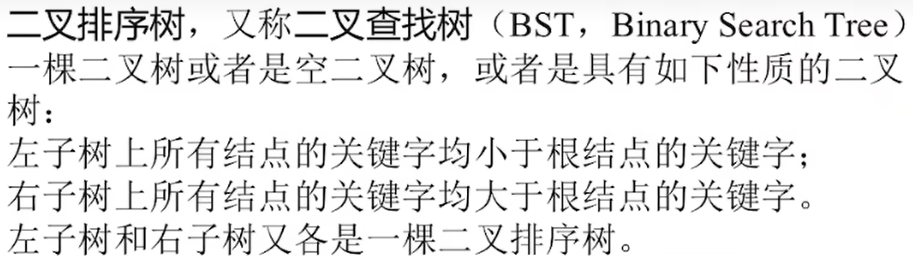 左子树结点值<根结点值<右子树结点值
进行中序遍历,可以得到一个递增的有序序列
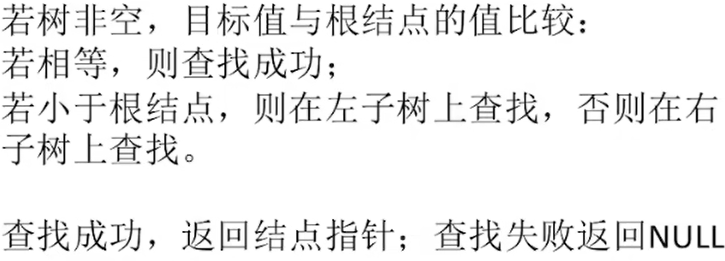
二叉排序树可用于元素的有序组织、搜索
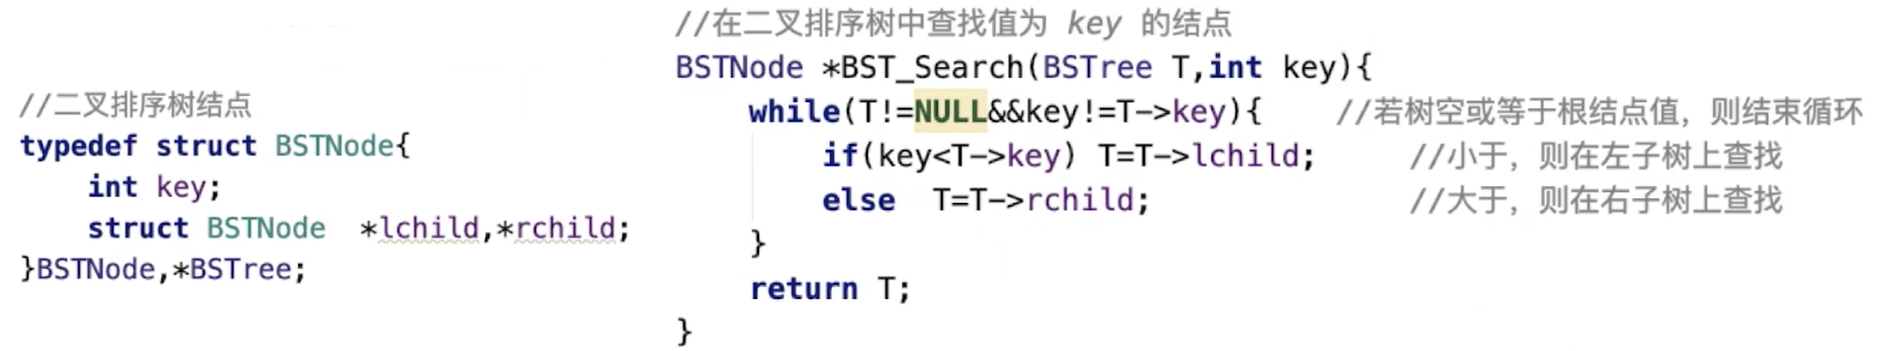
2、查找
3、插入
4、二叉排序树的构造
5、删除
先搜索找到目标结点:
(1)若被删除结点z是叶结点,则直接删除,不会破坏二叉排序树的性质
(2)若结点z只有一棵左子树或右子树,则让z的子树成为z父结点的子树,替代z的位置
(3)若结点z有左、右两棵子树,则令z的直接后继(或直接前驱)替代z,然后从二叉排序树中删去这个直接后继(或直接前驱),这样就转换成了第一或第二种情况
6、查找效率分析
查找长度——在查找运算中,需要对比关键字的次数称为查找长度,反映了查找操作时间复杂度
查找成功的平均查找长度ASL:平均查找次数
查找失败的平均查找长度ASL:平均查找次数
7、知识回顾
5.5.2平衡二叉树
1、定义
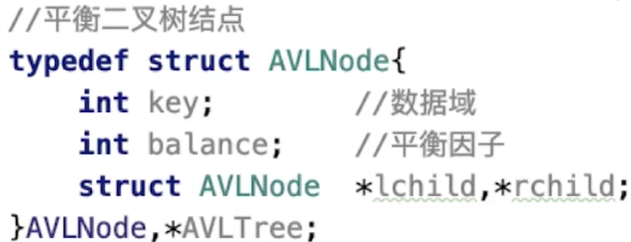
平衡二叉树,简称平衡树(AVL树):树上任一结点的左子树和右子树的深度之差不超过1
结点的平衡因子=左子树高-右子树高
2、平衡二叉树的插入
2.1、插入新结点后,从插入点往回找到第一个不平衡结点,调整以该结点为根的子树
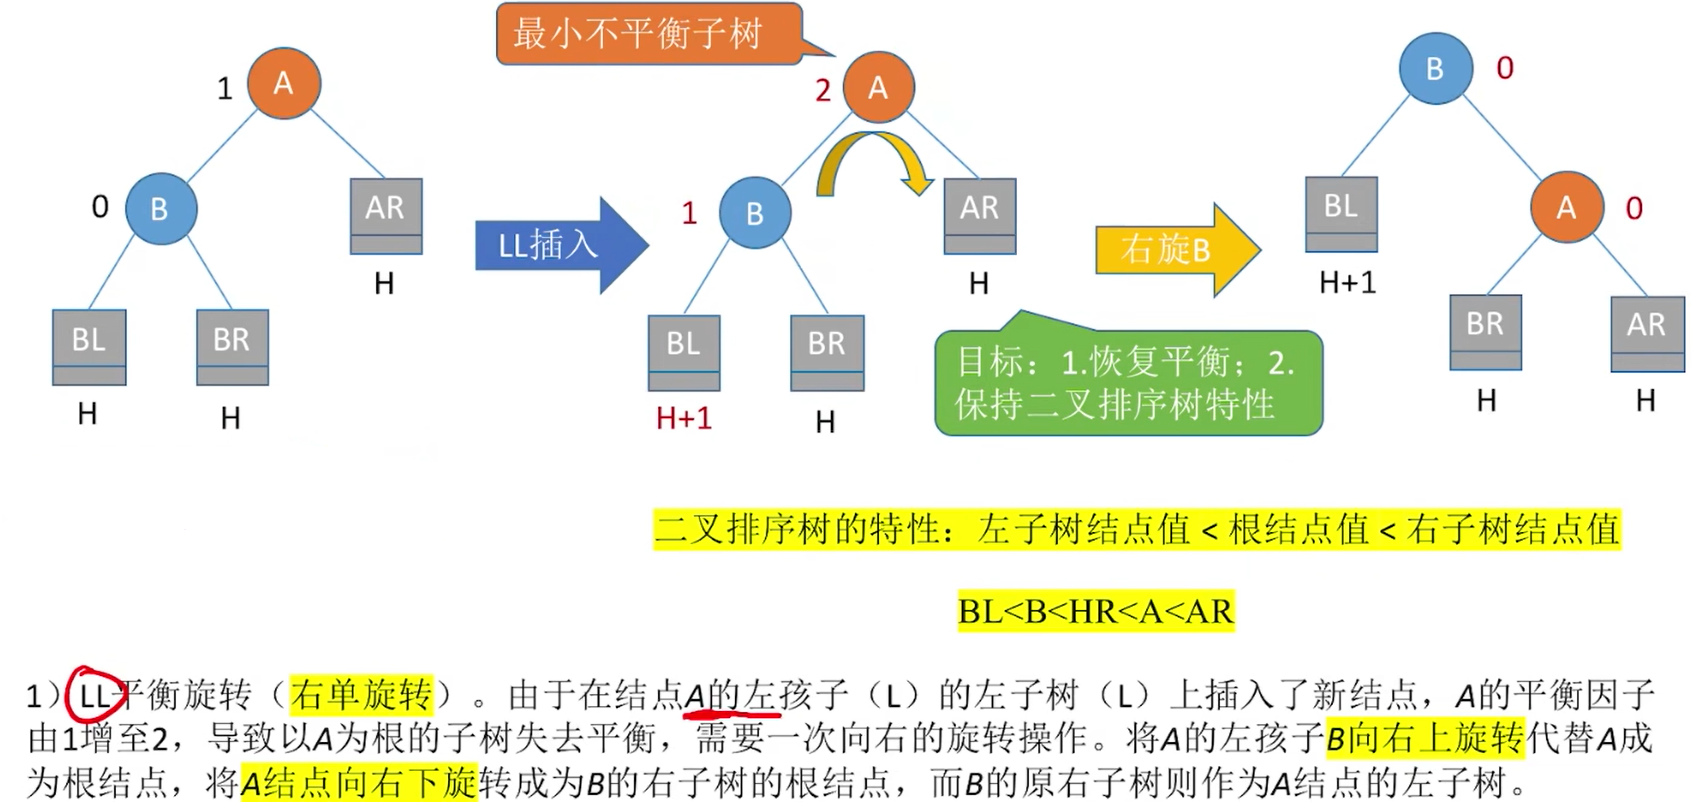
每次调整的对象都是“最小不平衡子树”
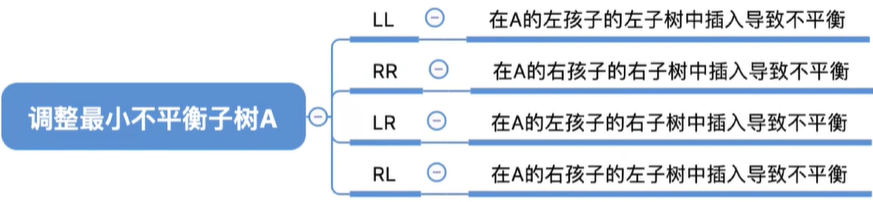
2.2、调整最小不平衡子树(LL)
2.3、调整最小不平衡子树(RR)

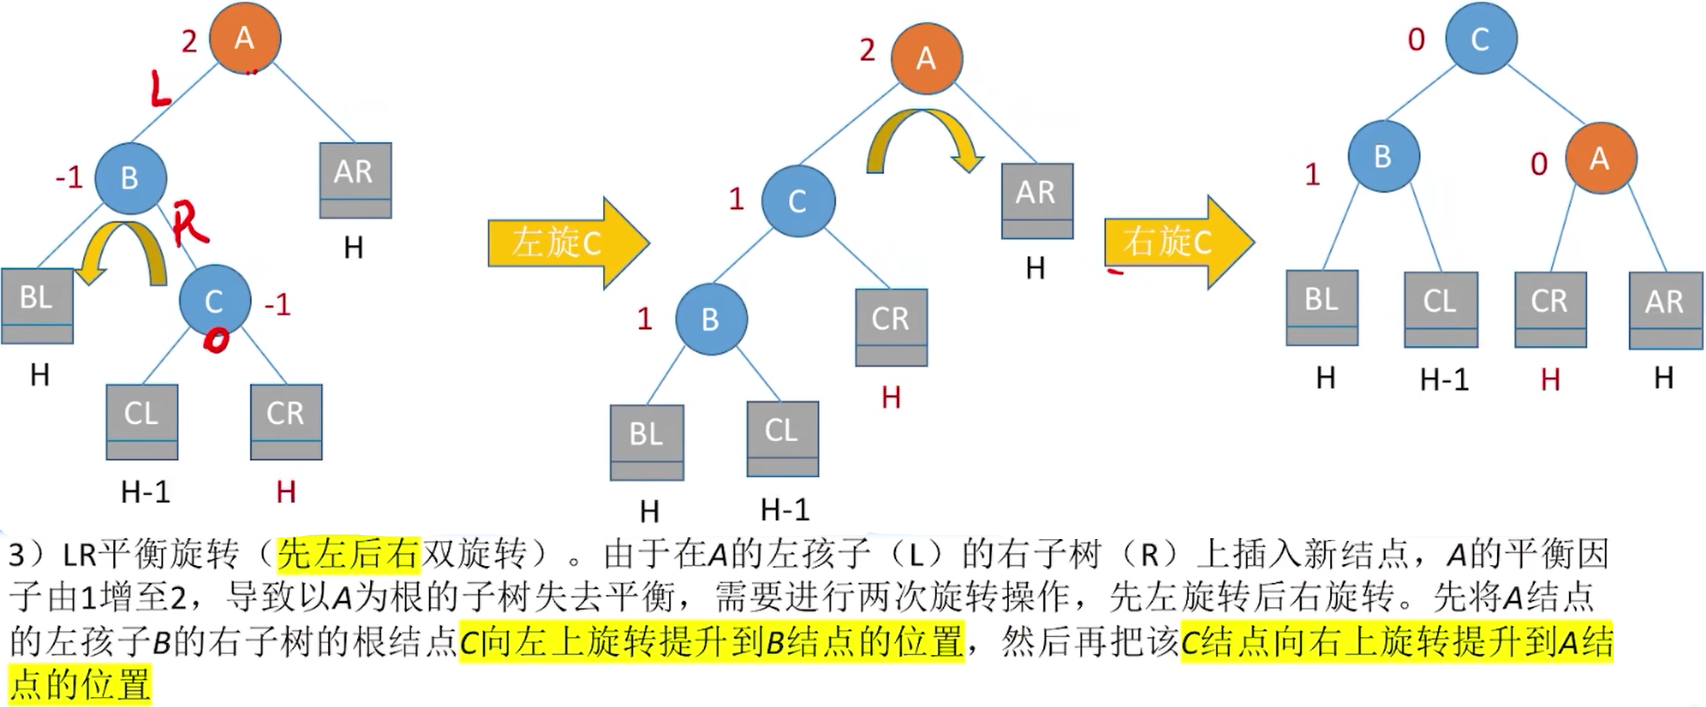
2.4、调整最小不平衡子树(LR)
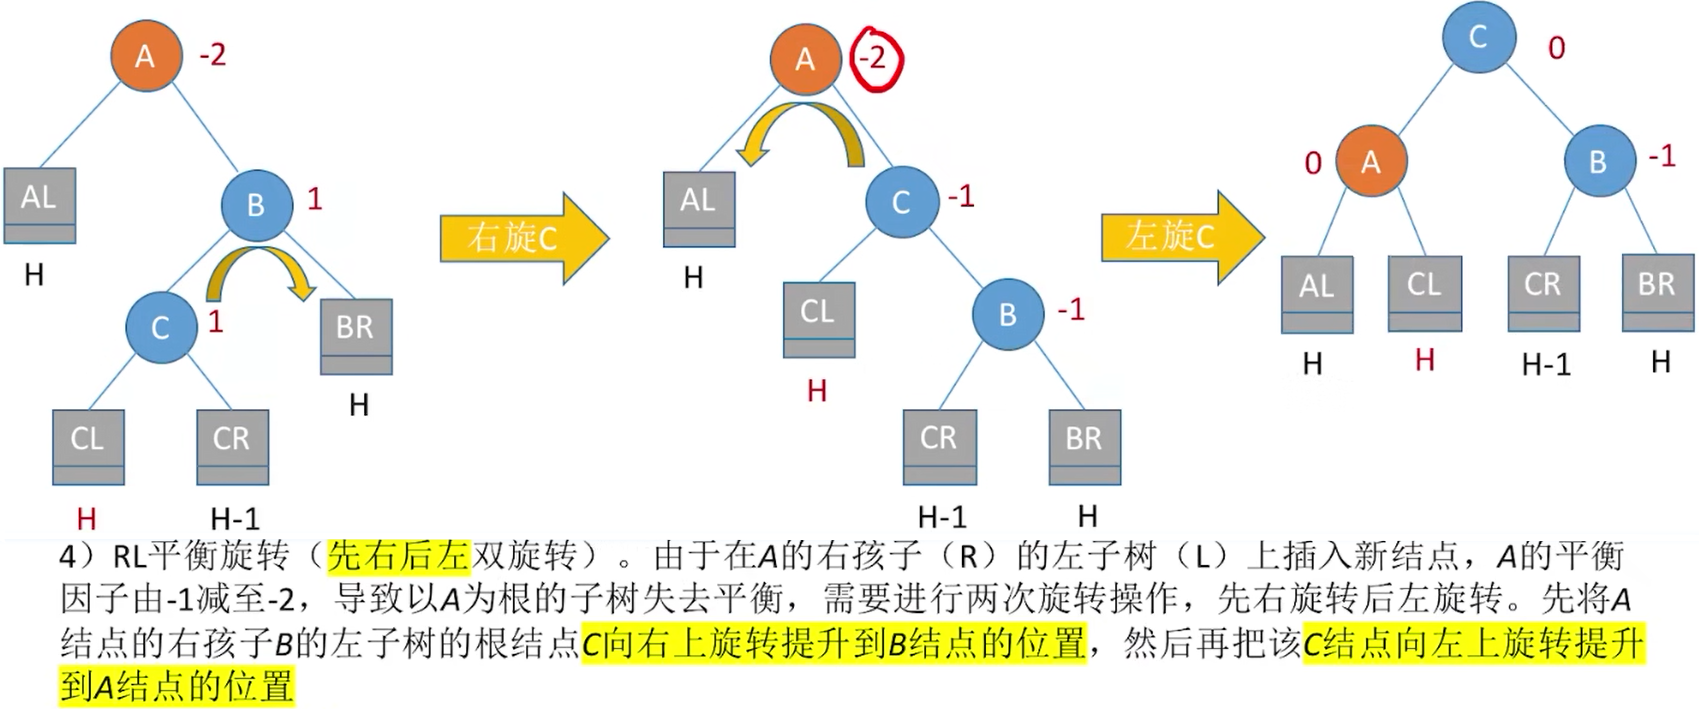
2.5、调整最小不平衡子树(RL)
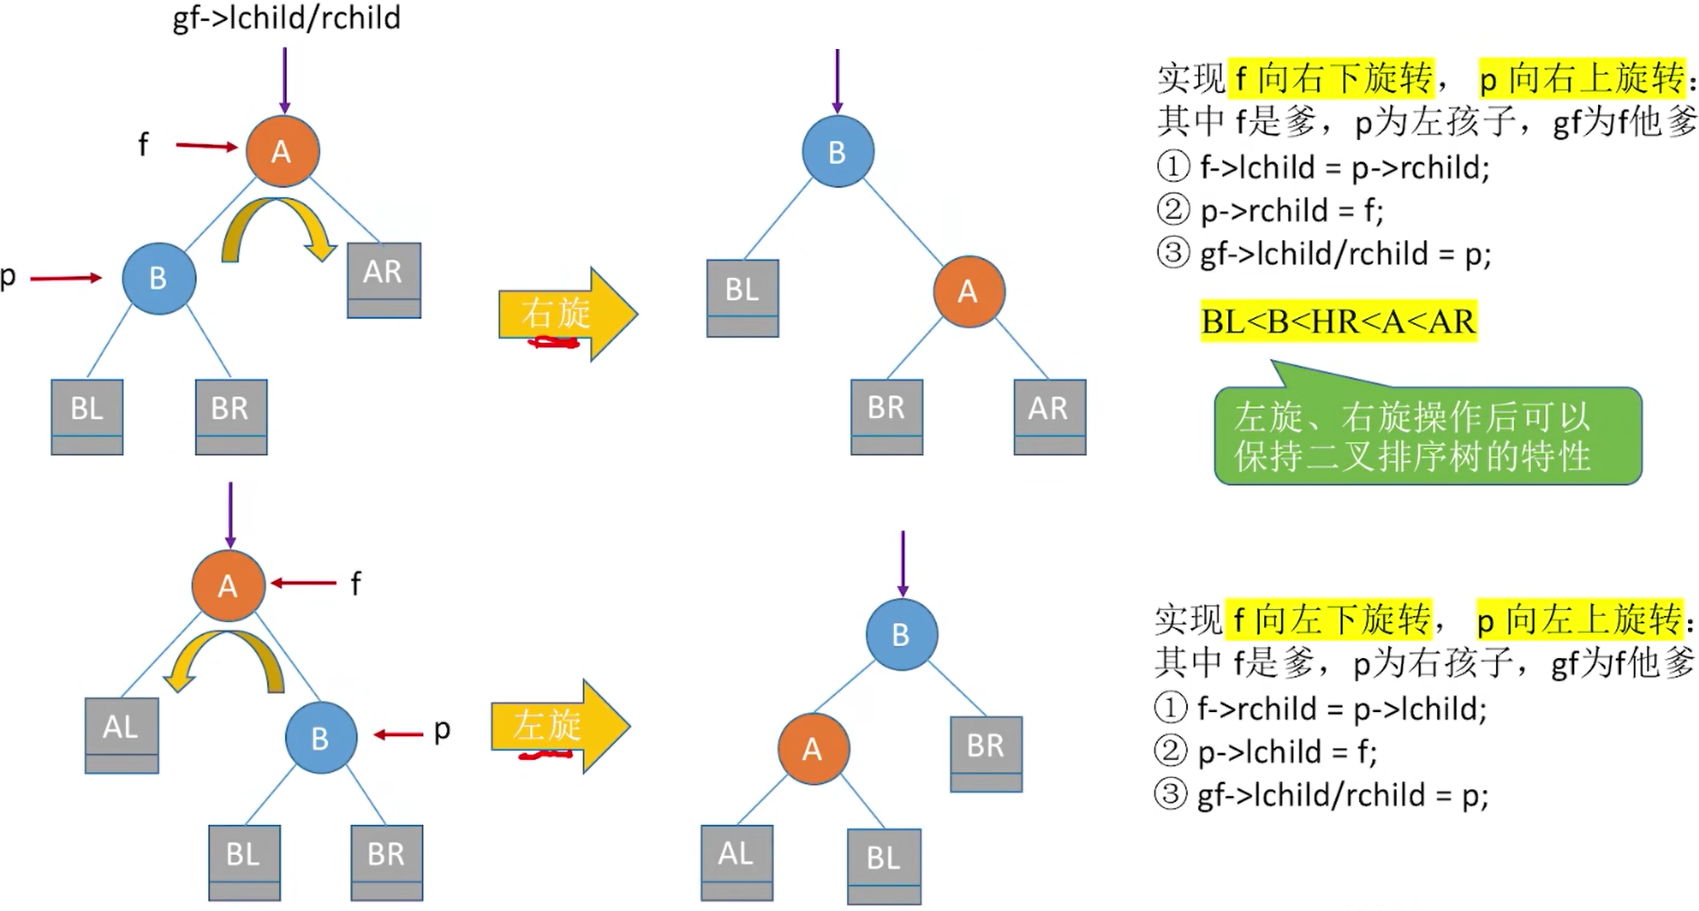
2.6、代码思路
3、知识回顾
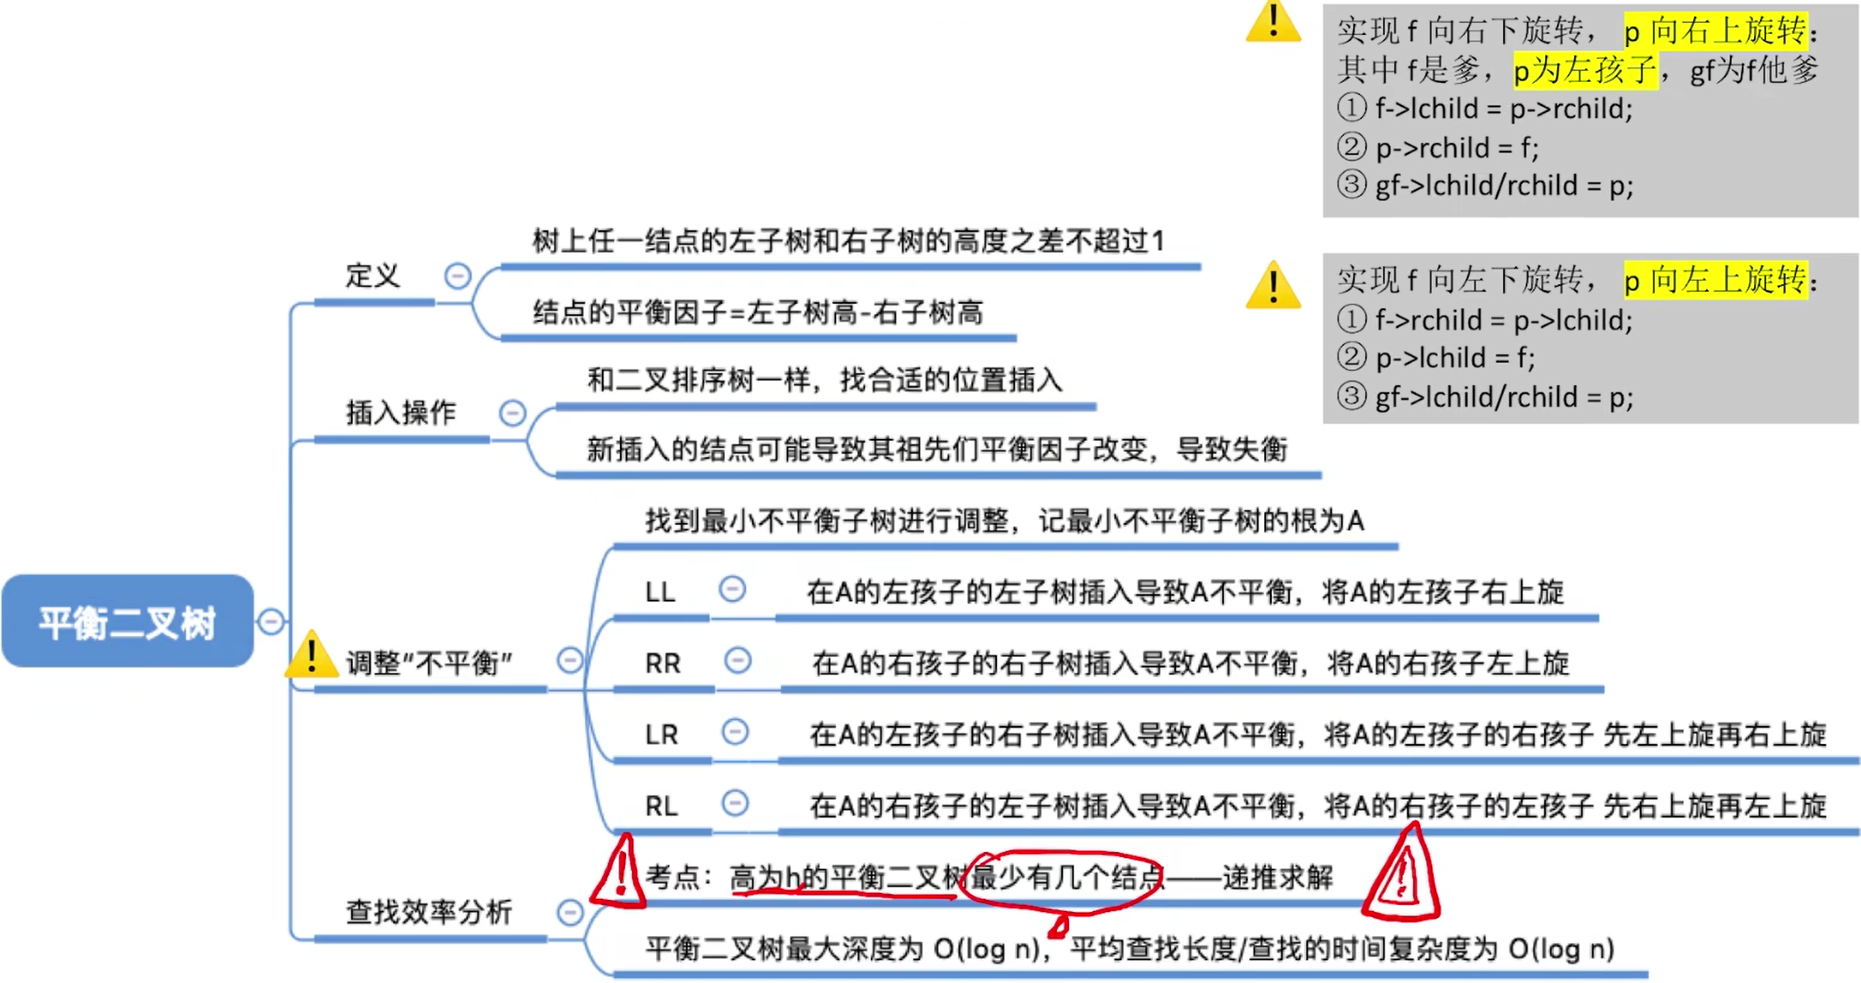
假设Nh表示深度为h的平衡树中含有的最少结点数,则有N0=0,N1=1,N2=2,并且有Nh = Nh-1 + Nh-2 + 1
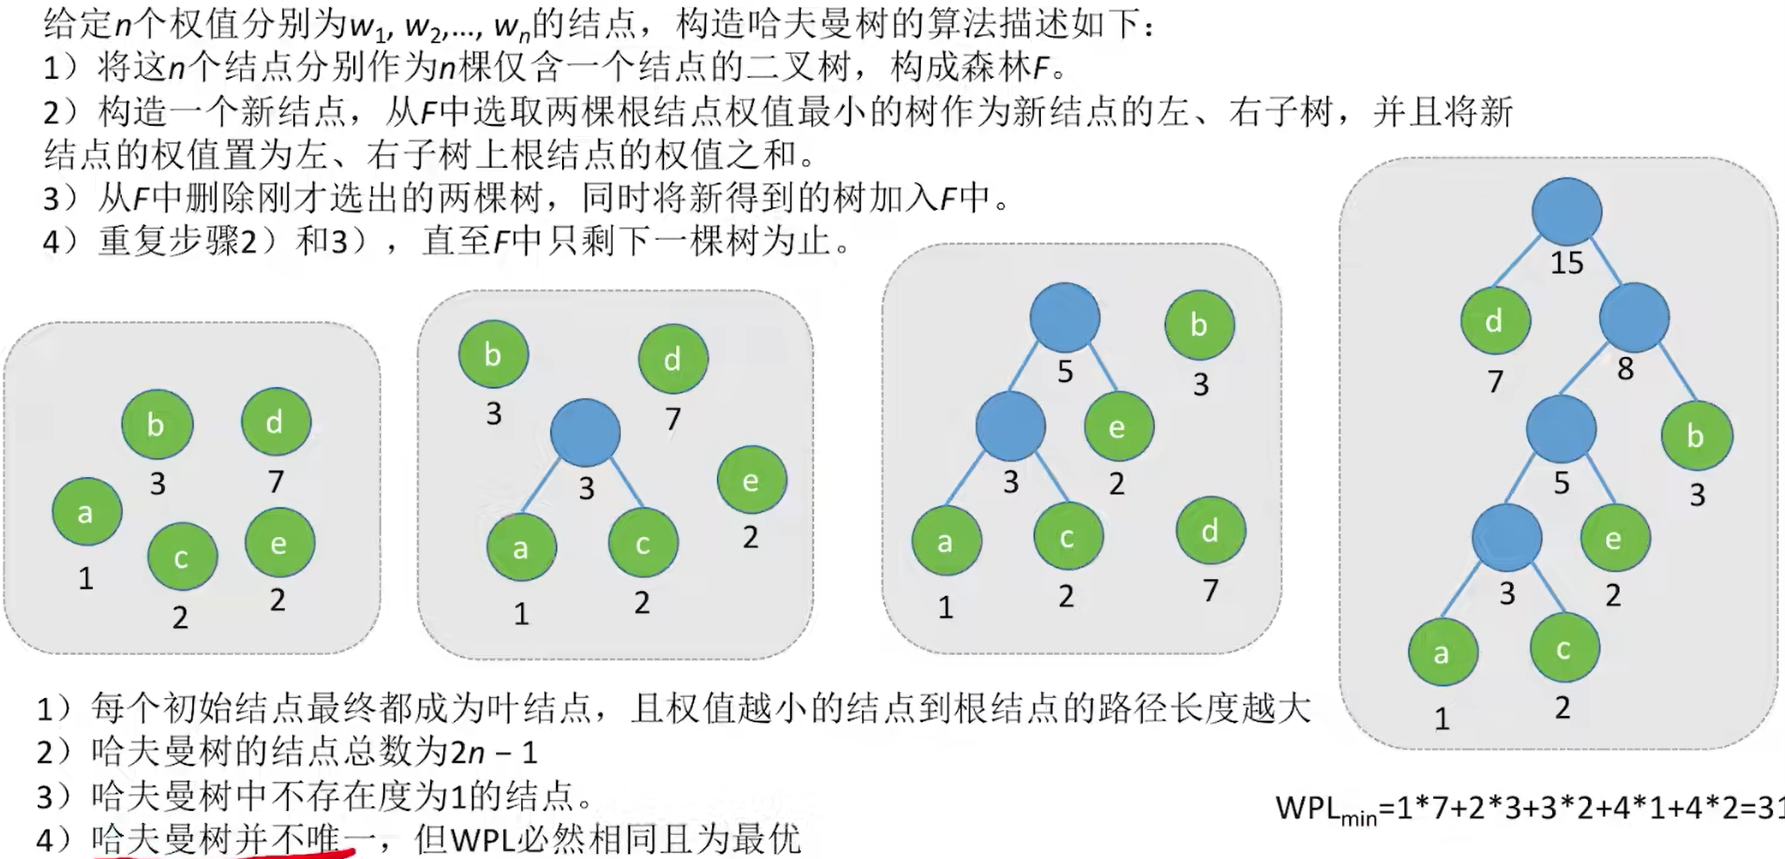
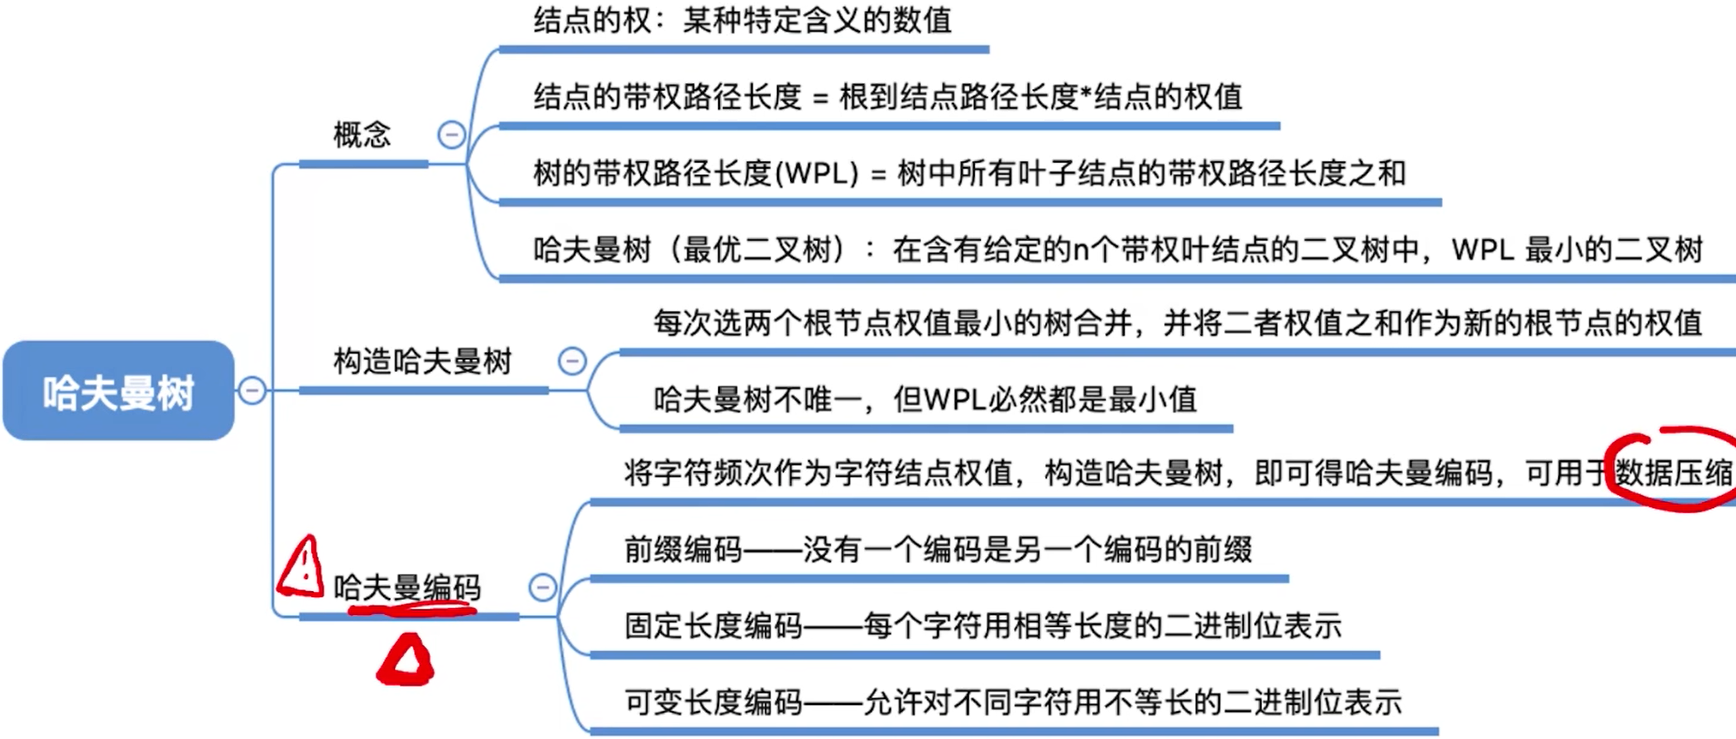
5.5.3哈夫曼树
1、定义
结点的权:有某种现实含义的数值(如:表示结点的重要性等)
结点的带权路径长度:从树的根到该结点的路径长度(经过的边数)与该结点上权值的乘积
树的带权路径长度:树中所有叶结点的带权路径长度之和(WPL, Weighted Path Length)WPL=∑wl
哈夫曼树:在含有n个带权叶结点的二叉树中,其中带权路径长度(WPL)最小的二叉树称为哈夫曼树,也称最优二叉树
2、哈夫曼树的构造
3、知识回顾
第六章 图
6.1图的基本概念
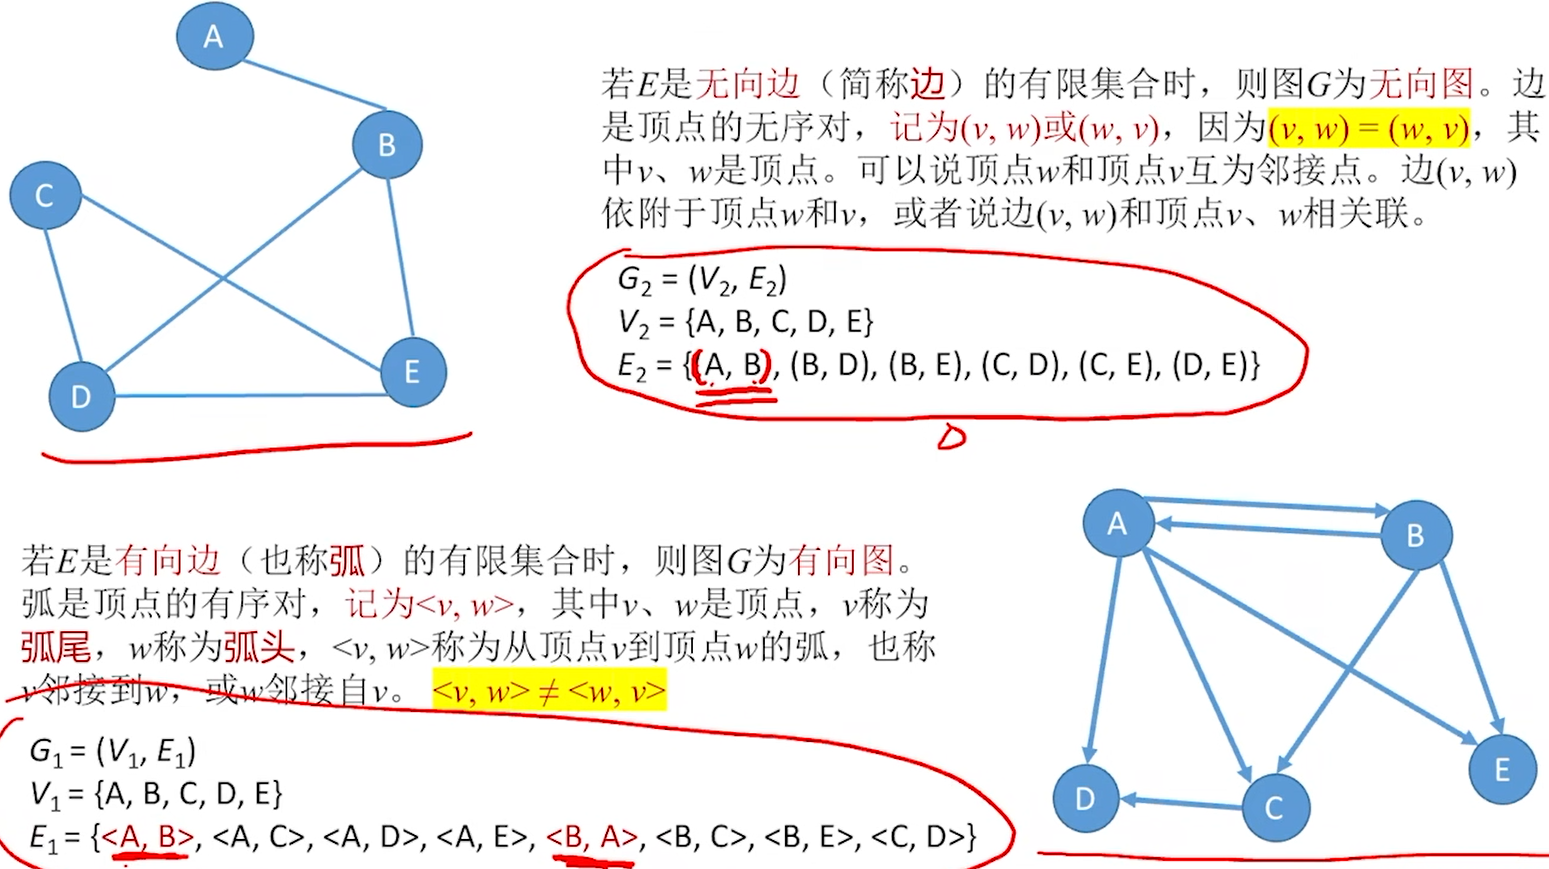
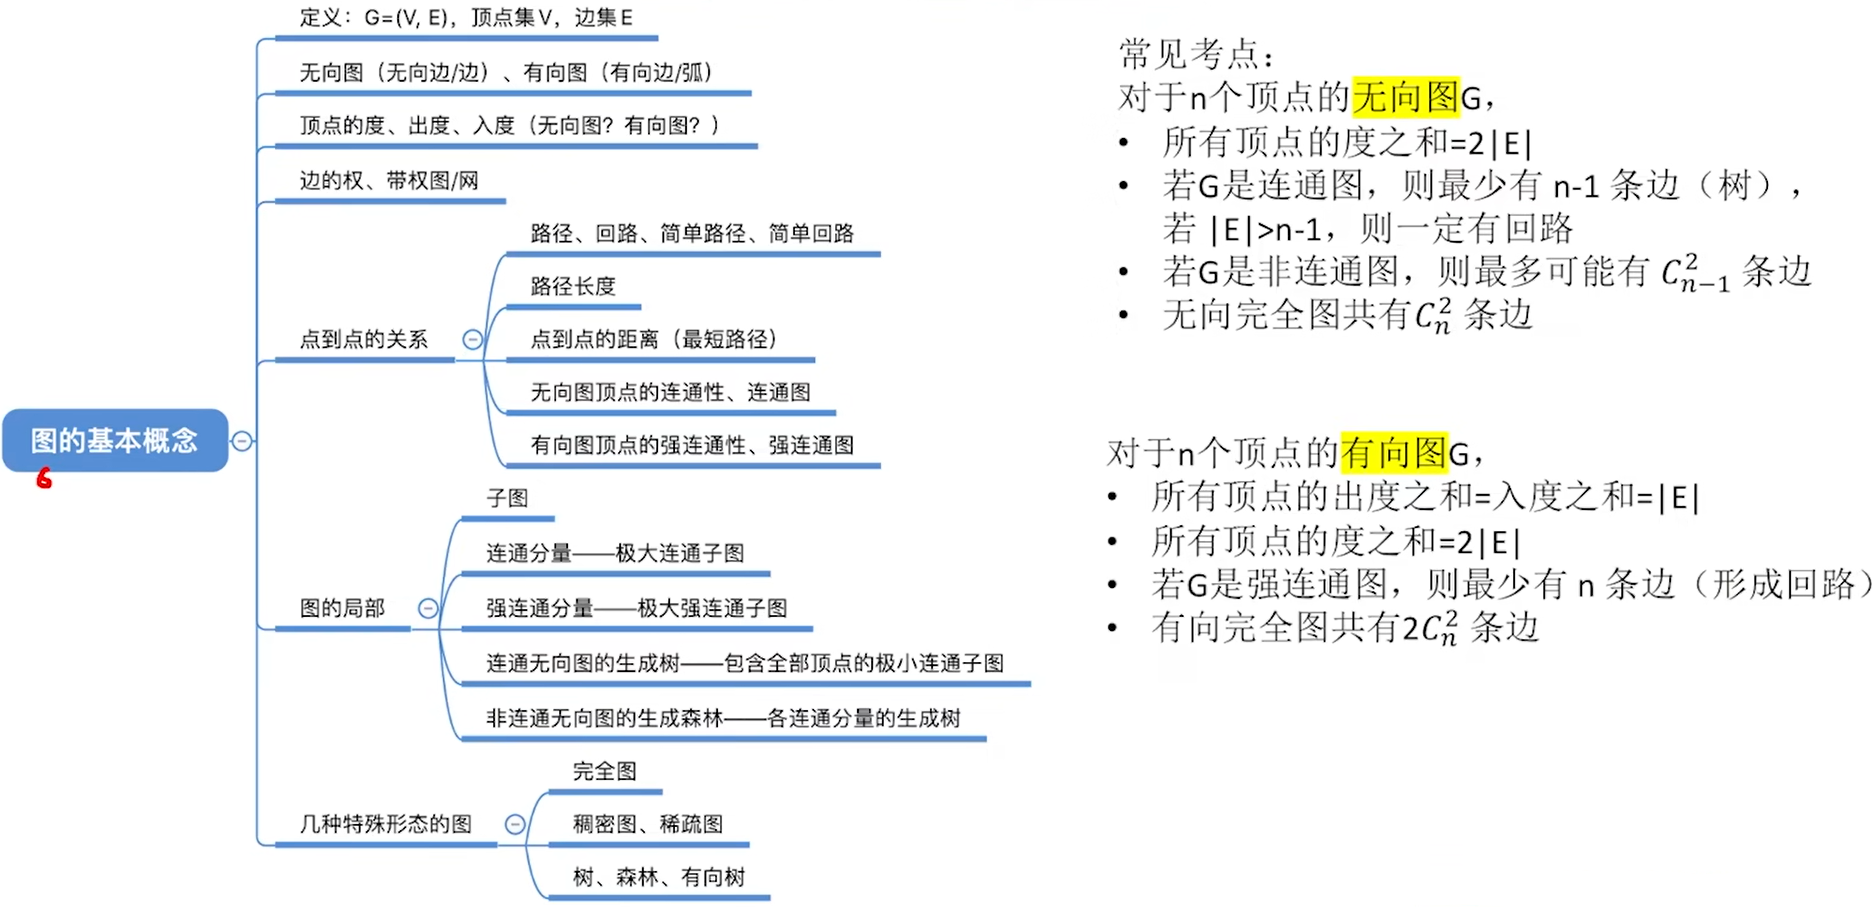
1、图的定义

2、有向图、无向图
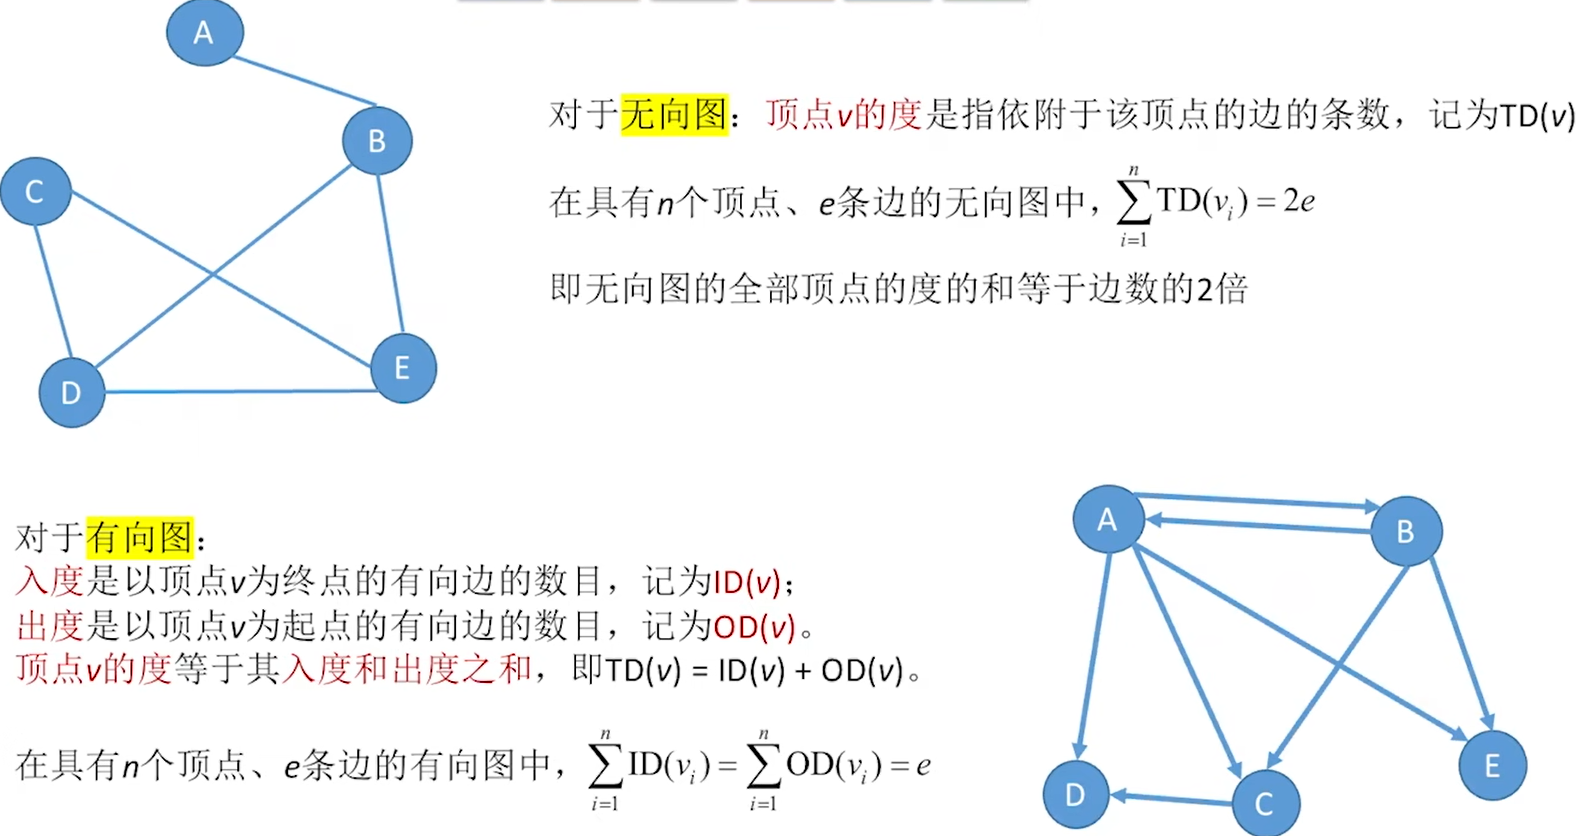
3、顶点的度、入度、出度
4、顶点—顶点的关系描述
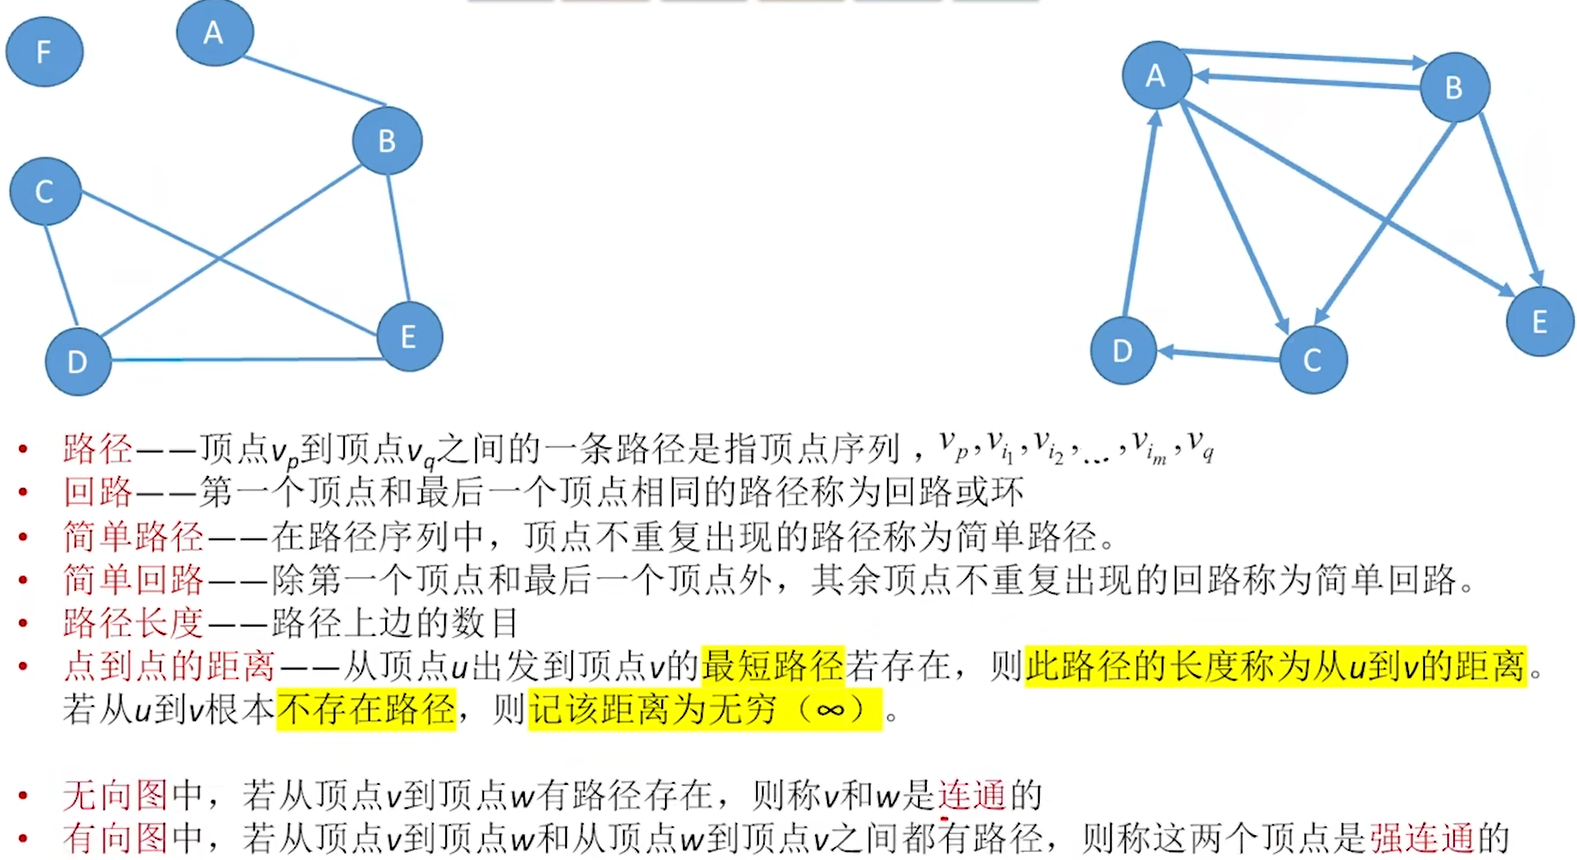
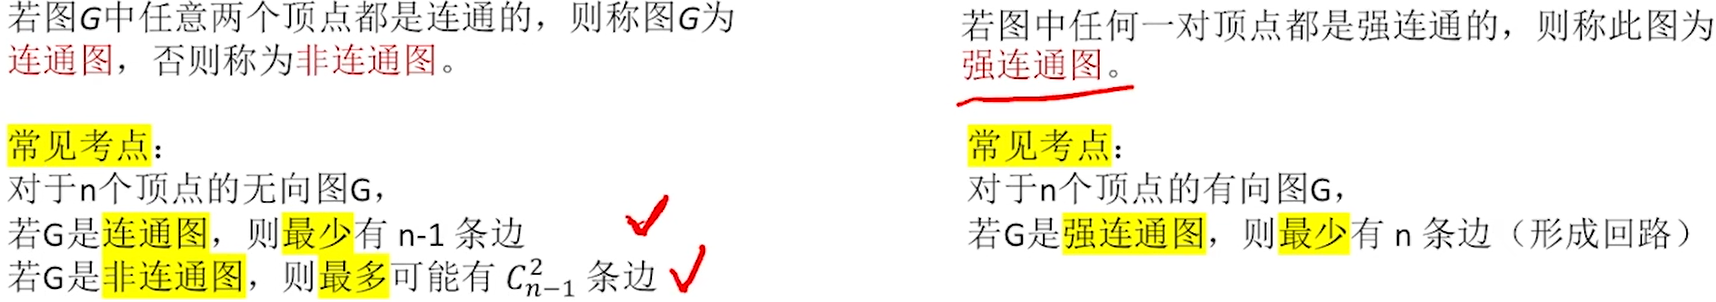
5、连通图、强连通图
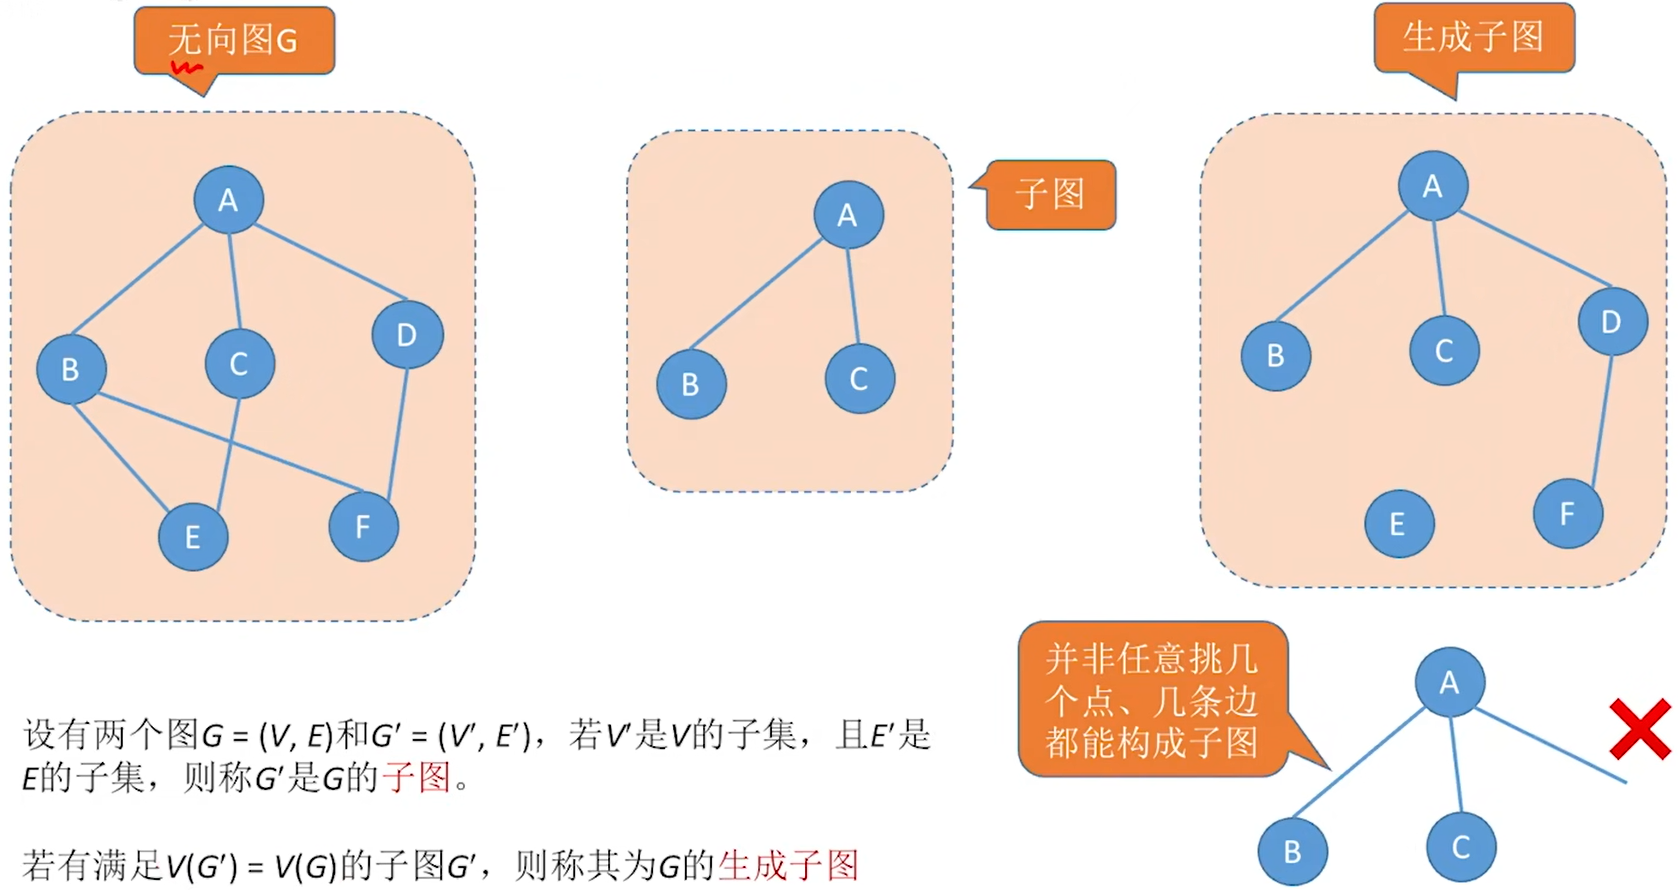
6、子图
7、连通分量、强连通分量
连通分量:无向图中的极大连通子图称为连通分量
子图必须连通,且包含尽可能多的顶点和边
强连通分量:无向图中的极大强连通子图称为强连通分量
子图必须强连通,同时保留尽可能多的边
8、生成树、生成森林
生成树:连通图的生成树是包含图中全部顶点的一个极小连通子图。若图中顶点数为n,则它的生成树含有n-1条边。对生成树而言,若砍去它的一条边,则会变成非连通图,若加上一条边则会形成一个回路)
生成森林:在非连通图中,连通分量的生成树构成了非连通图的生成森林
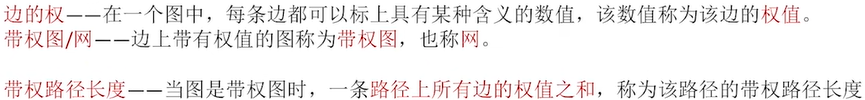
9、边的权、带权图/网
10、几种特殊形态的图
无向完全图——无向图中任意两个顶点之间都存在边
有向完全图——有向图中任意两个顶点之间都存在方向相反的两条弧
边数很少的图称为稀疏图,反之称为稠密图
树——不存在回路,且连通的无向图
有向图——一个顶点的入度为0,其余顶点的入度均为1的有向图,称为有向树
11、知识回顾
6.2图的存储及基本操作
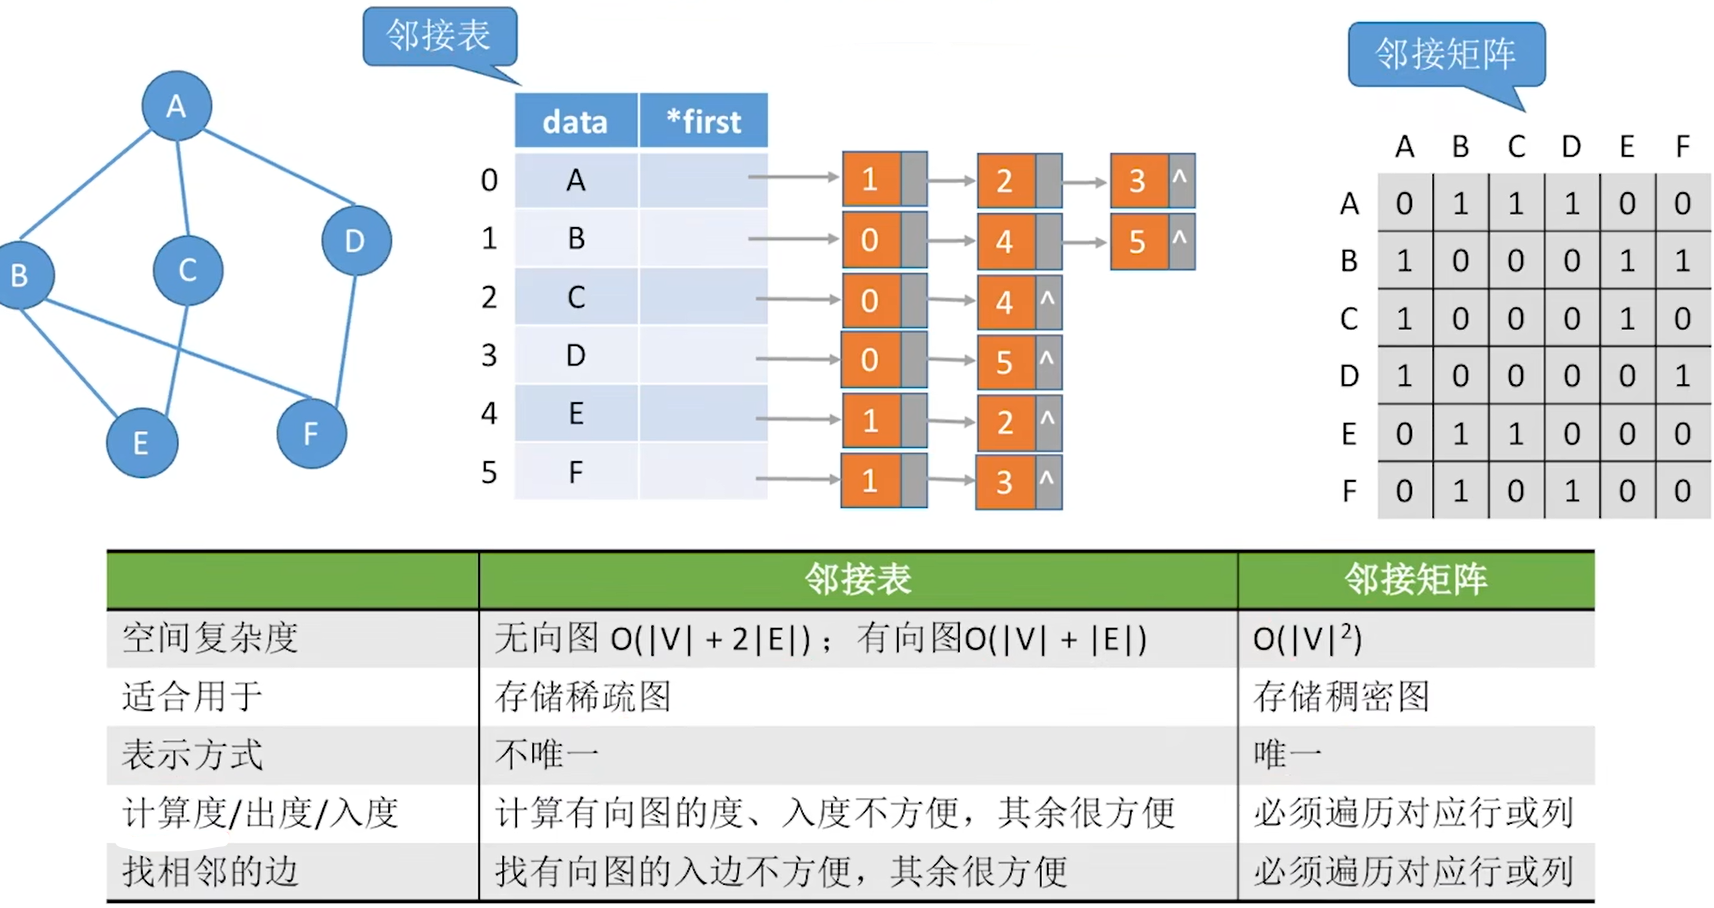
6.2.1邻接矩阵法(顺序存储)
1、定义
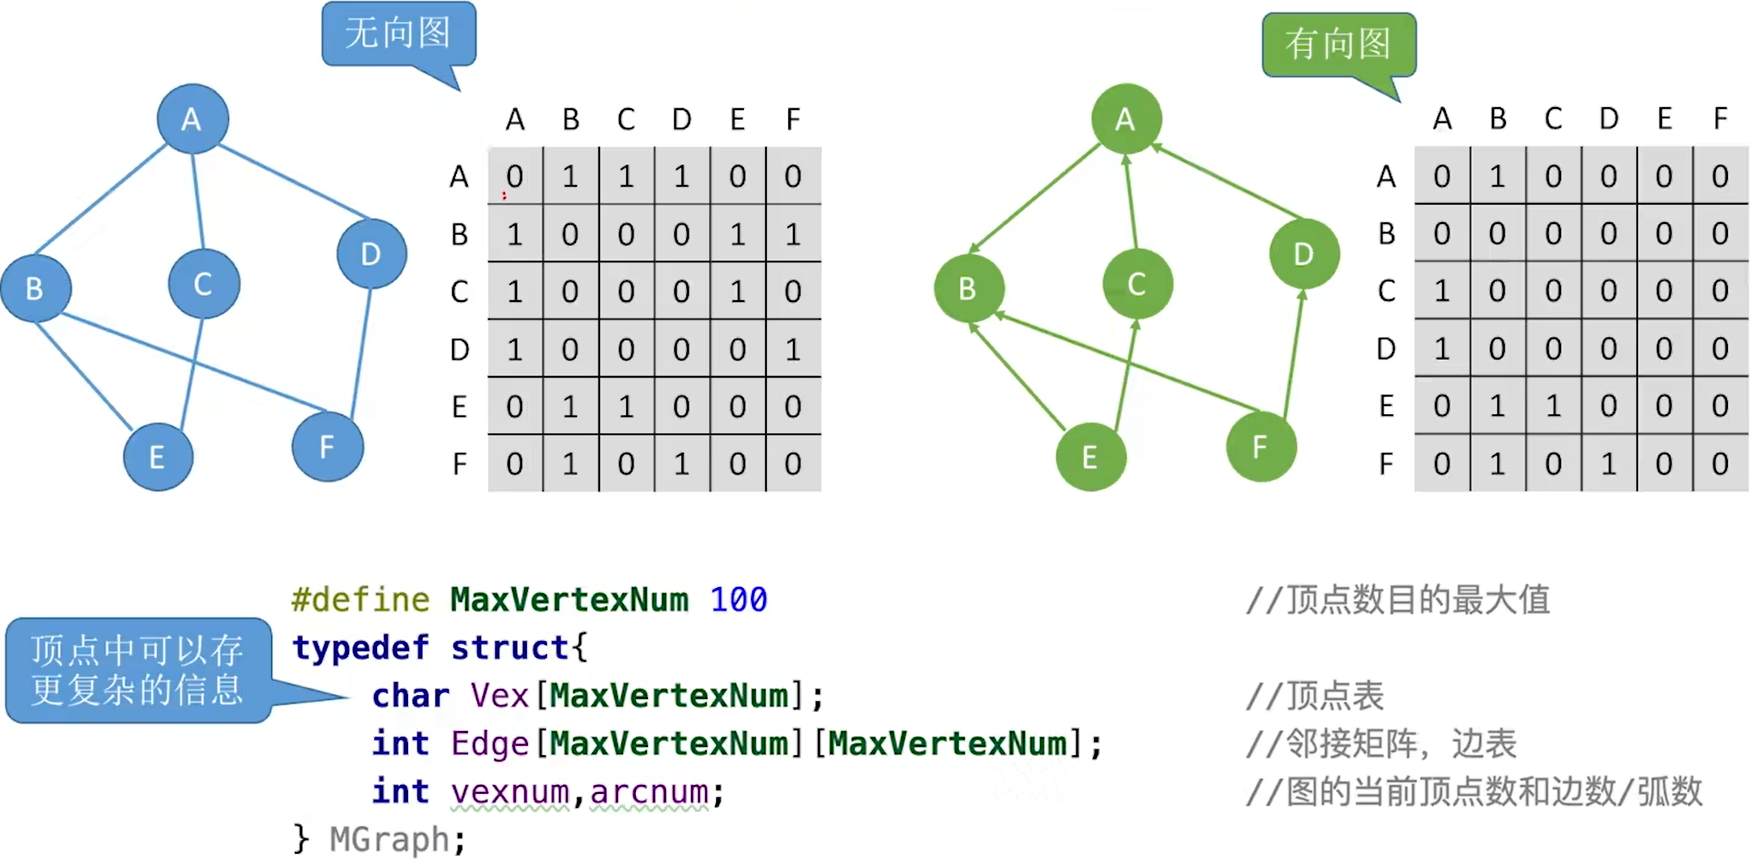
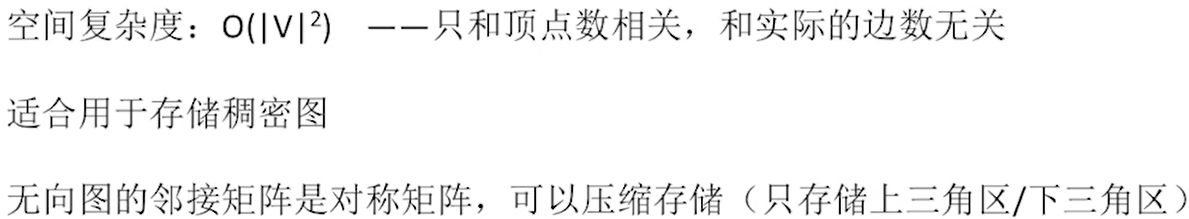
缺点:数组实现的顺序存储,空间复杂度高,不适合存储稀疏图
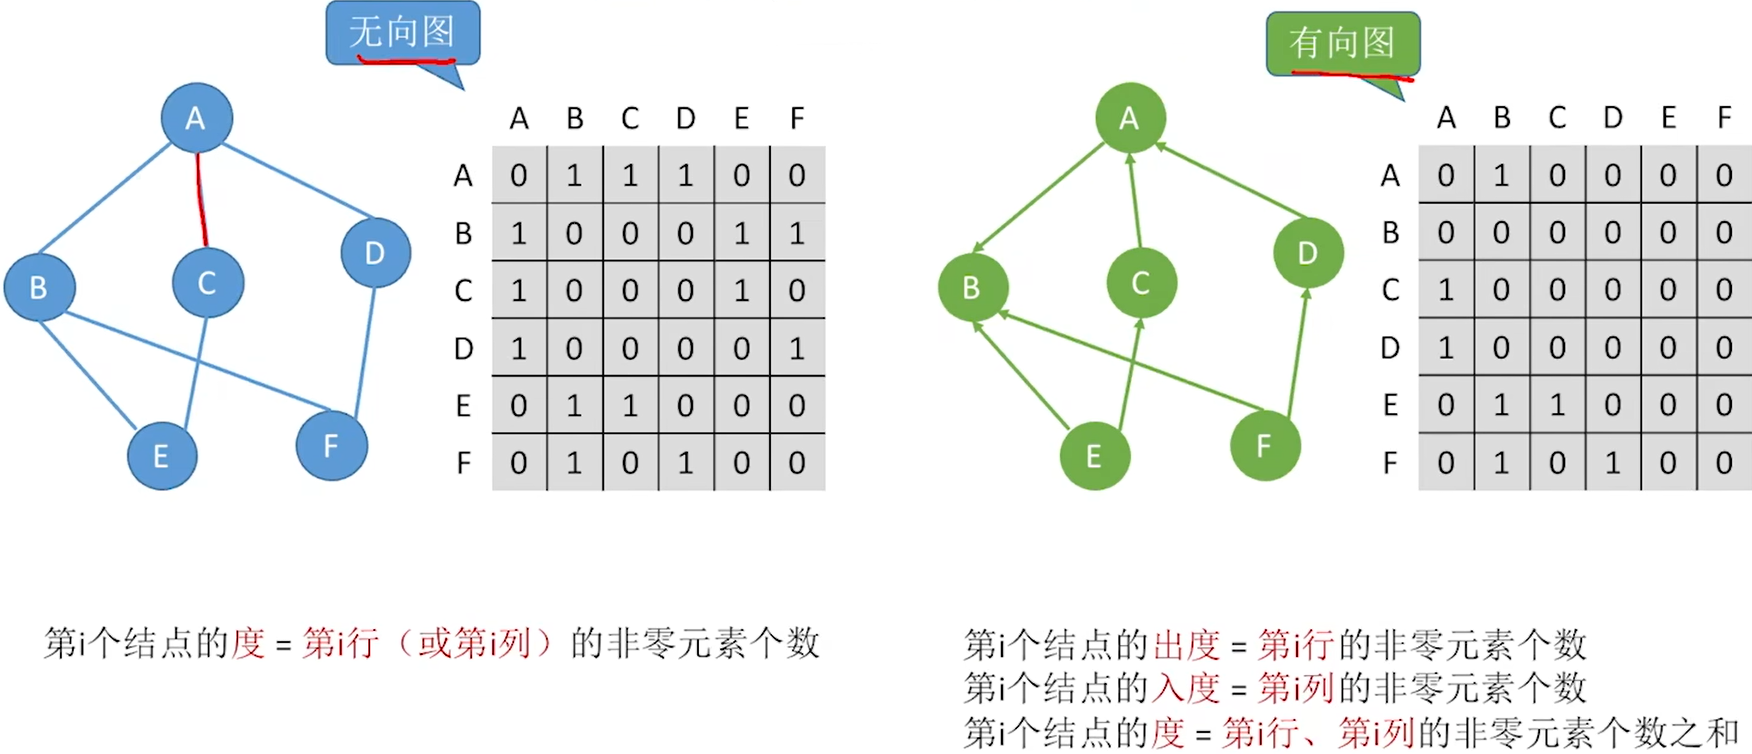
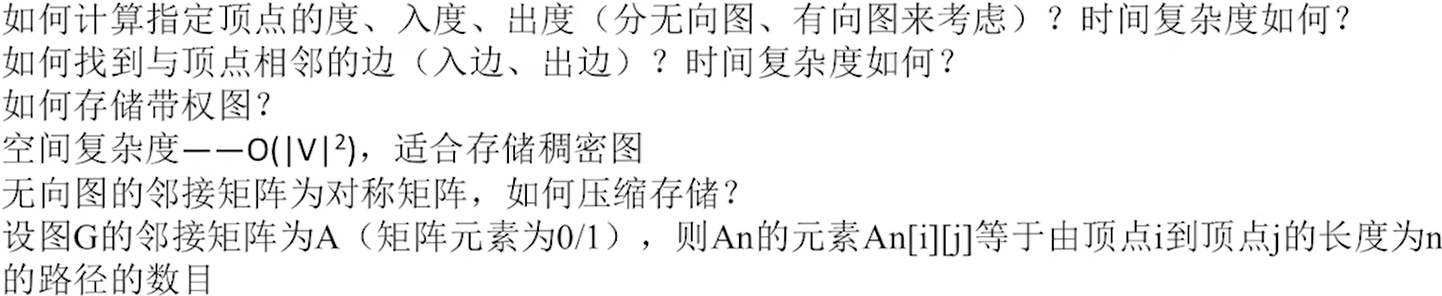
2、度
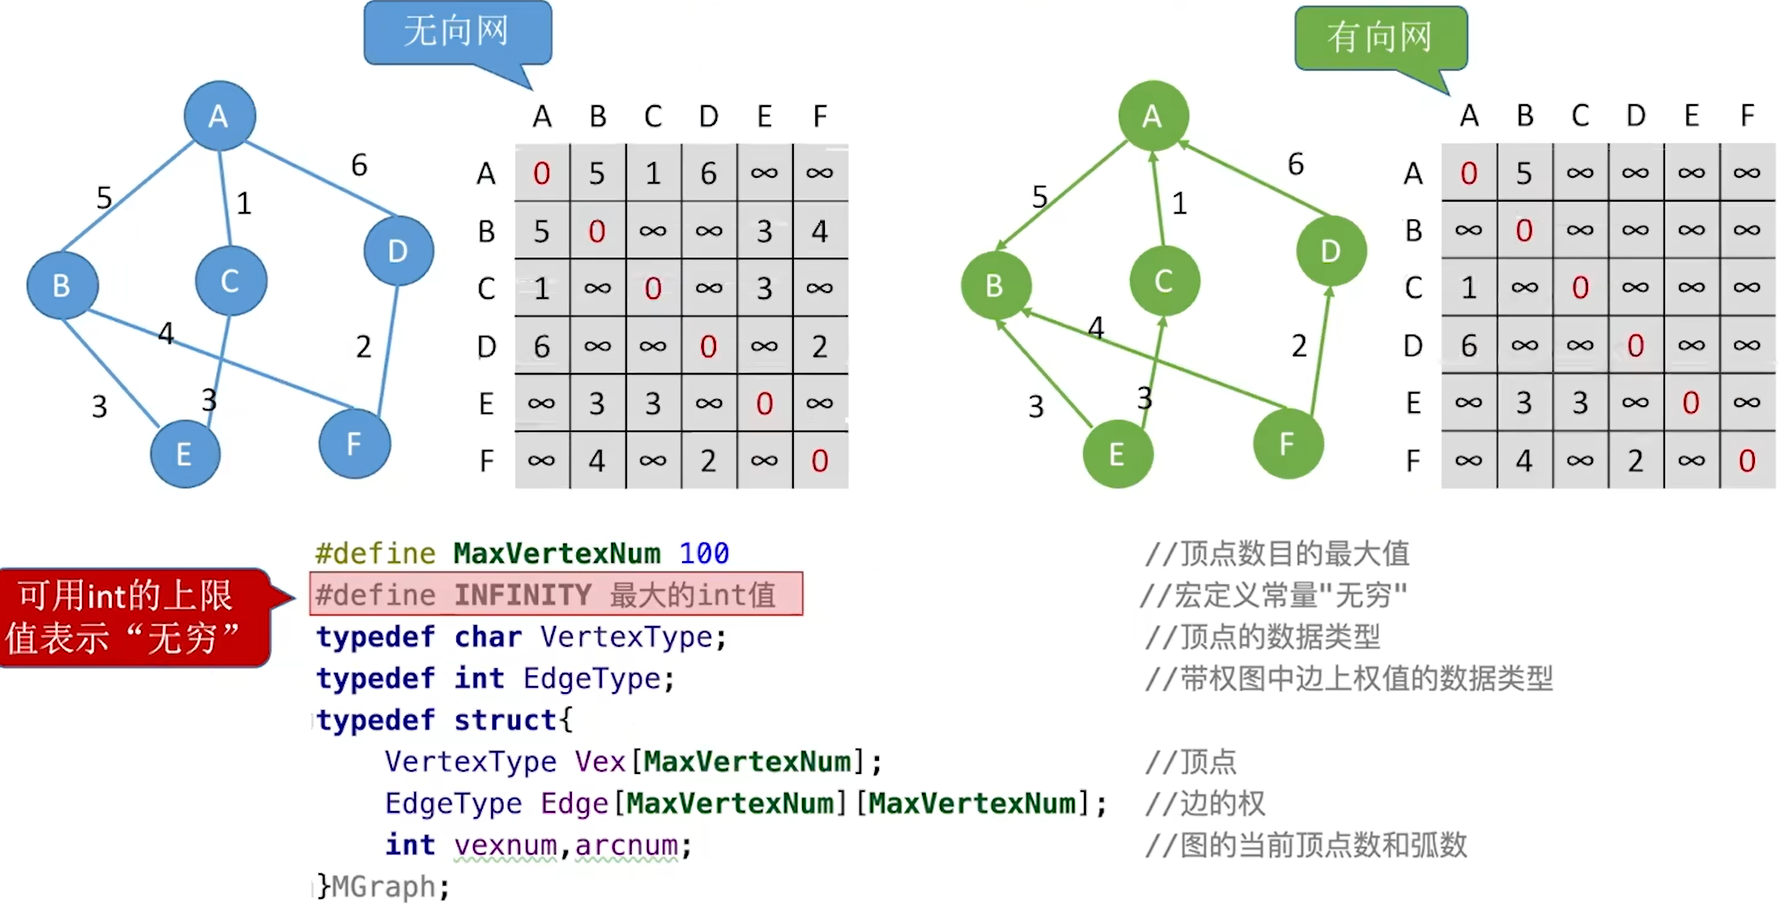
3、带权图
4、性能分析
5、性质
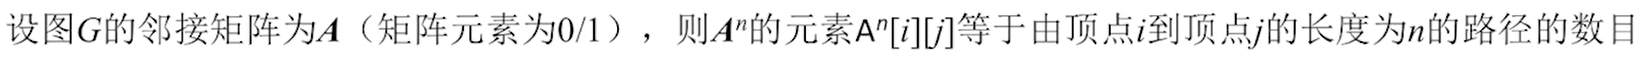
6、知识回顾
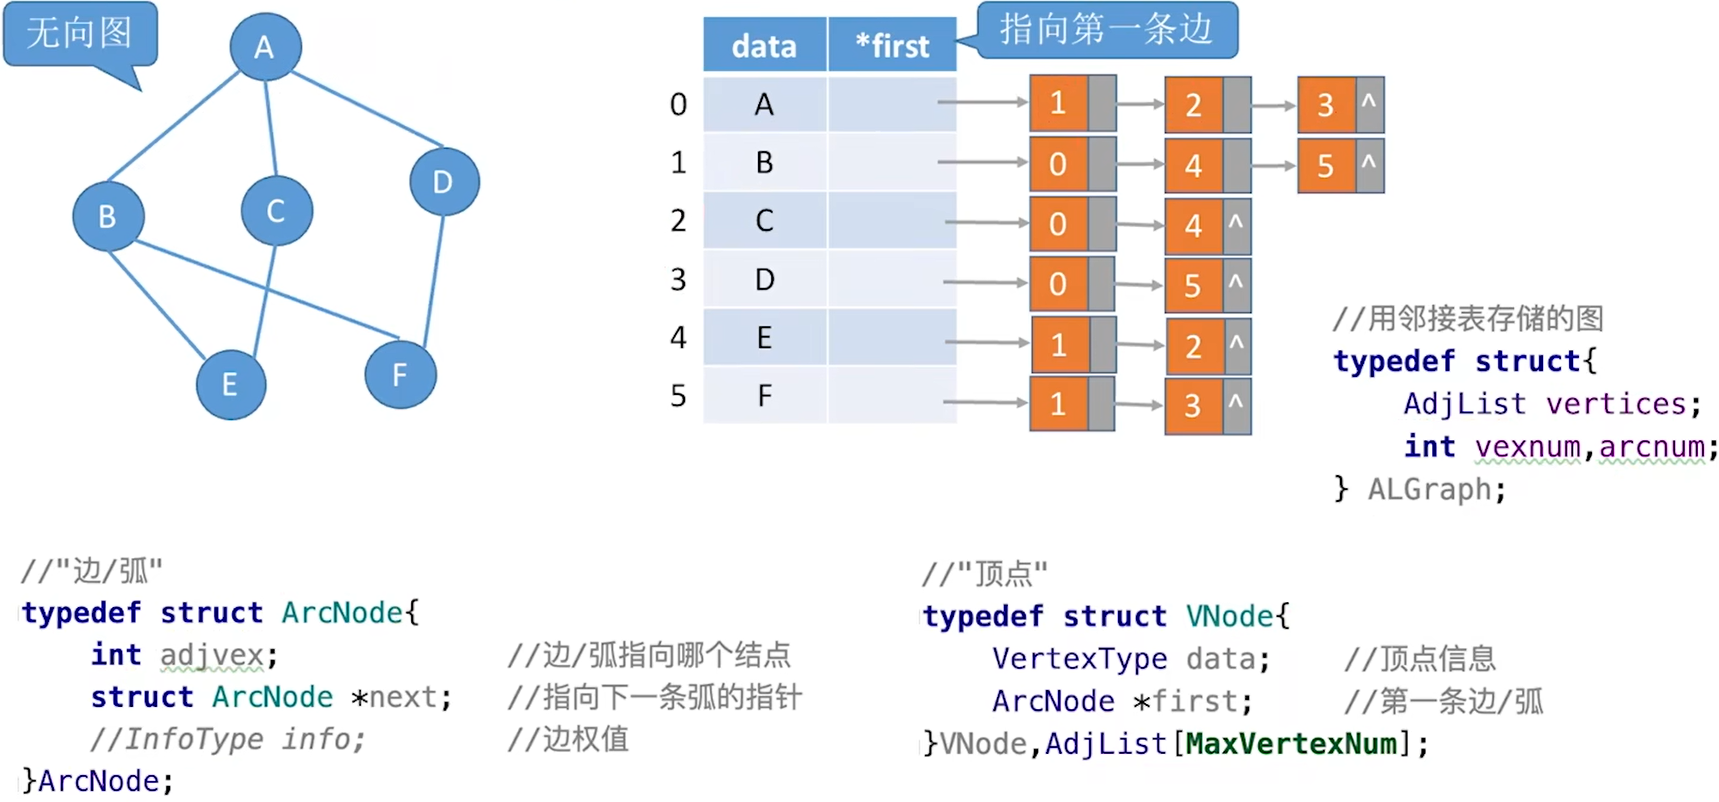
6.2.2邻接表法(顺序+链式存储)
1、定义
2、知识回顾
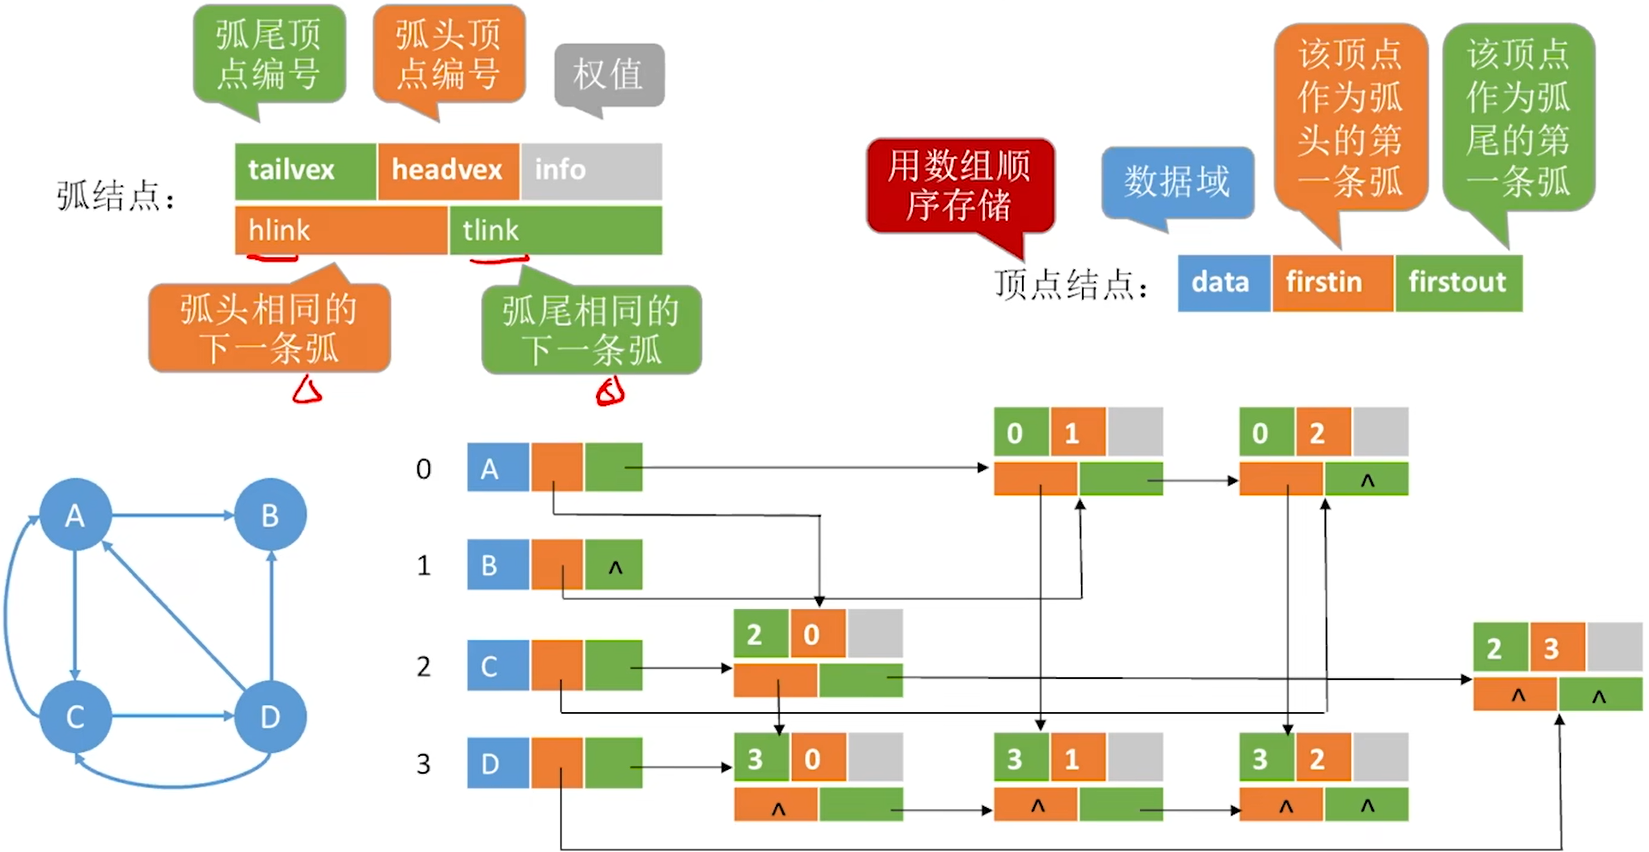
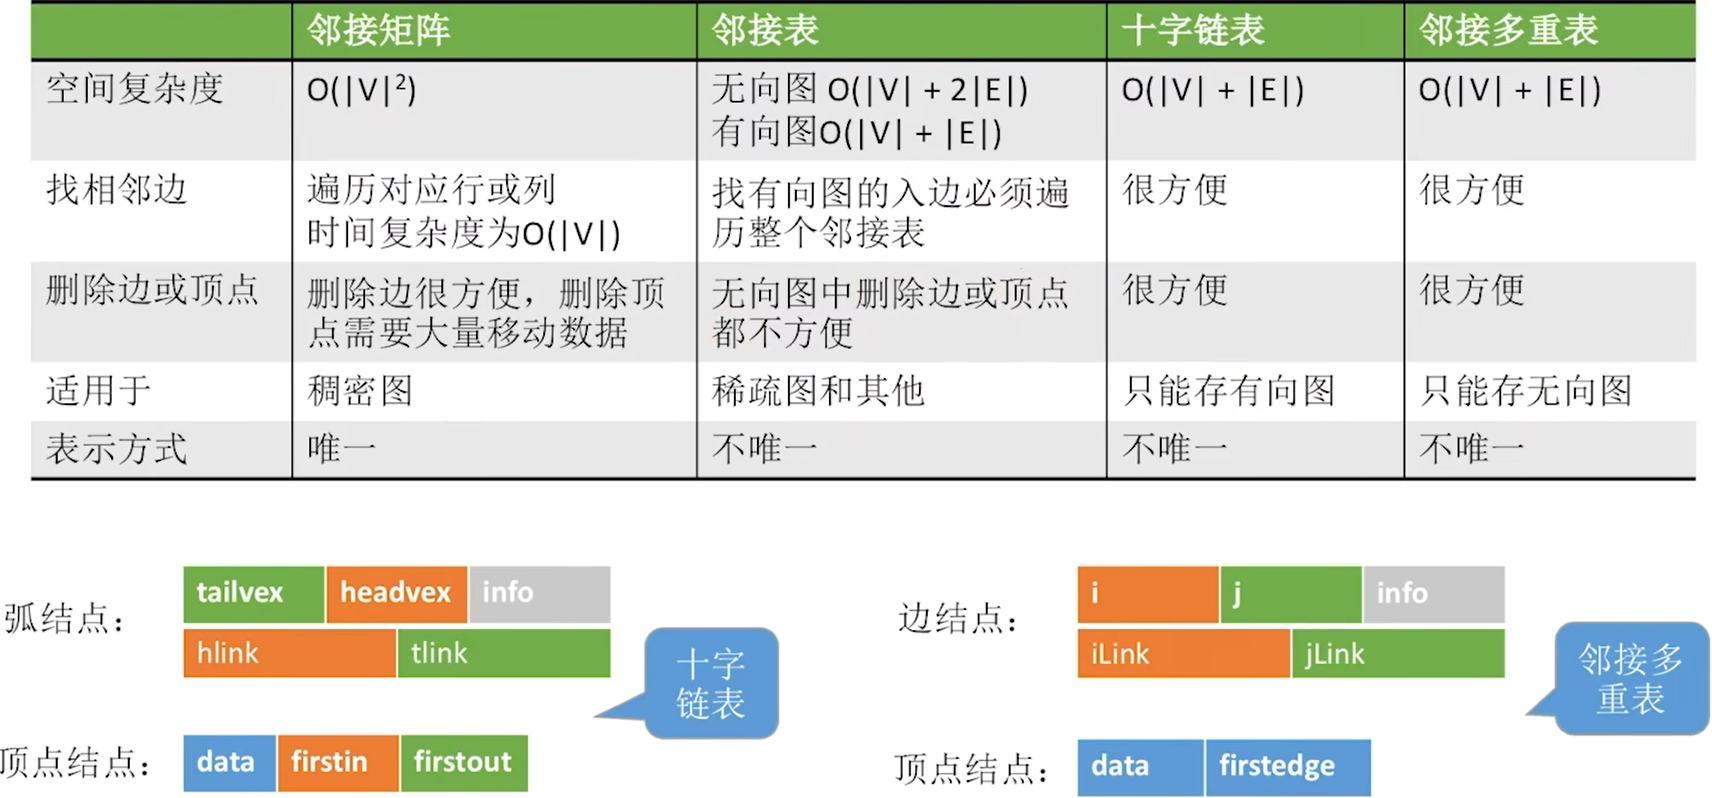
6.2.3十字链表、邻接多重表
1、十字链表
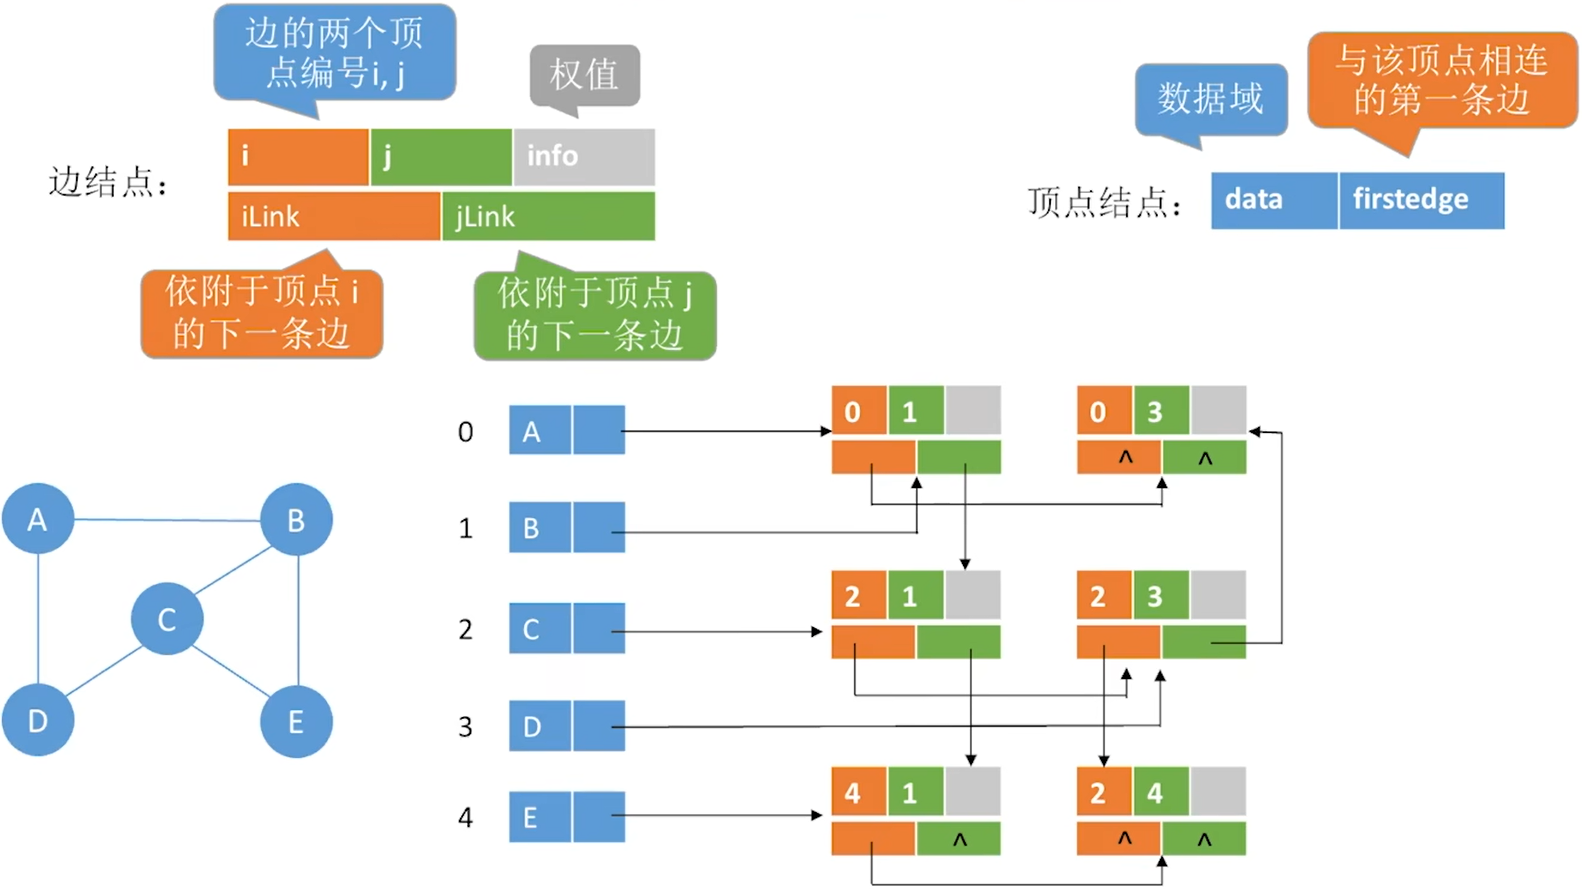
2、邻接多重表
3、知识回顾
6.2.4图的基本操作
1、基本操作
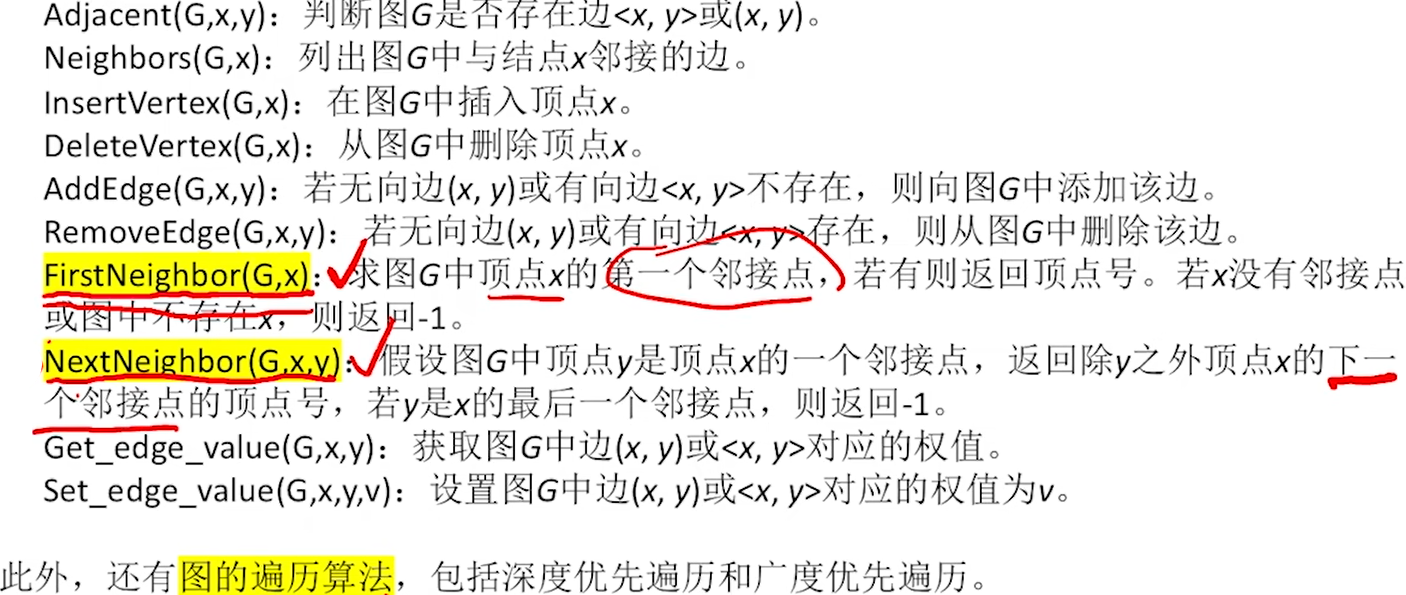
6.3图的遍历
6.3.1图的广度优先遍历
1、代码实现
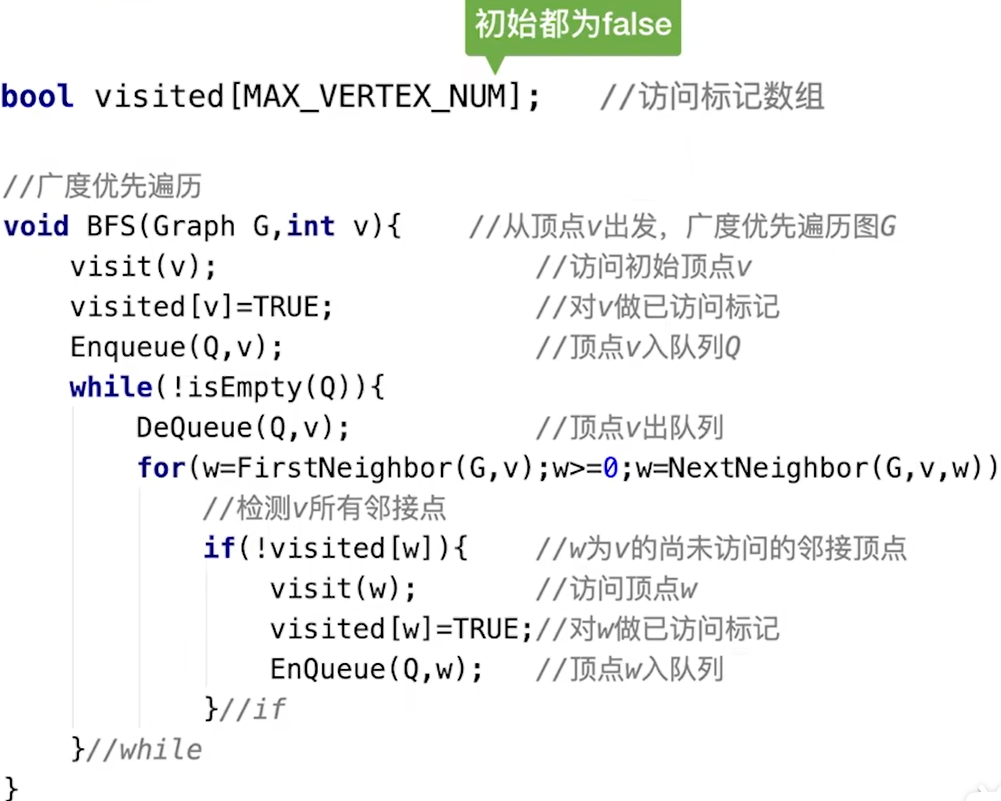
缺点:如果是非连通图,则无法遍历完所有结点
2、final版
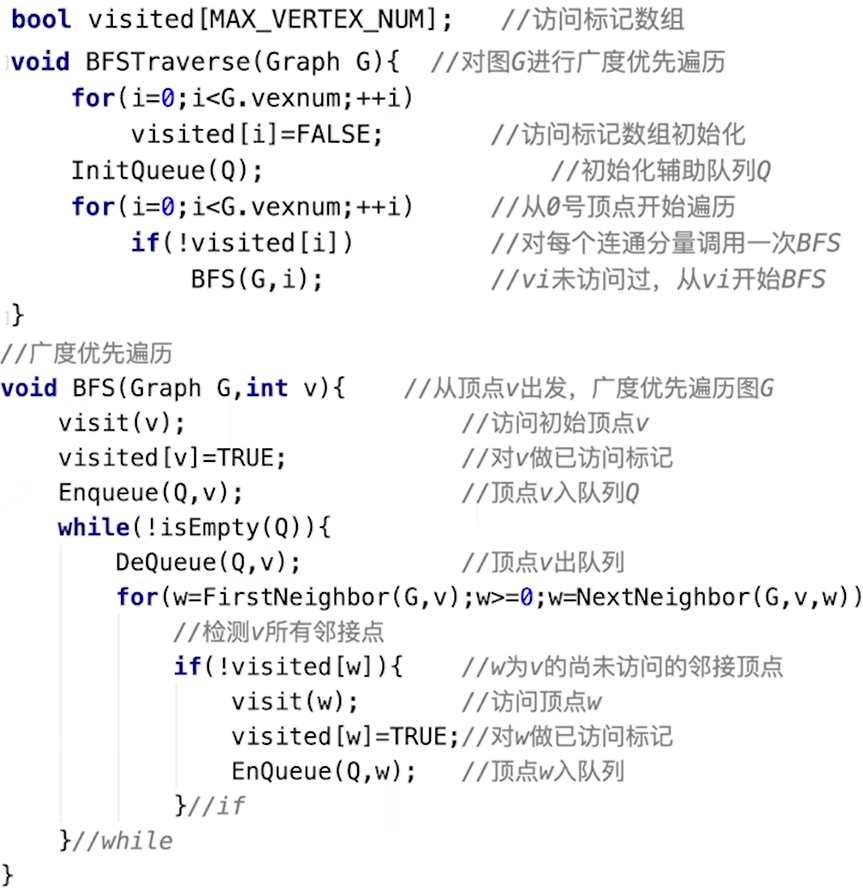
结论:对于无向图,调用BFS函数的次数=连通分量数
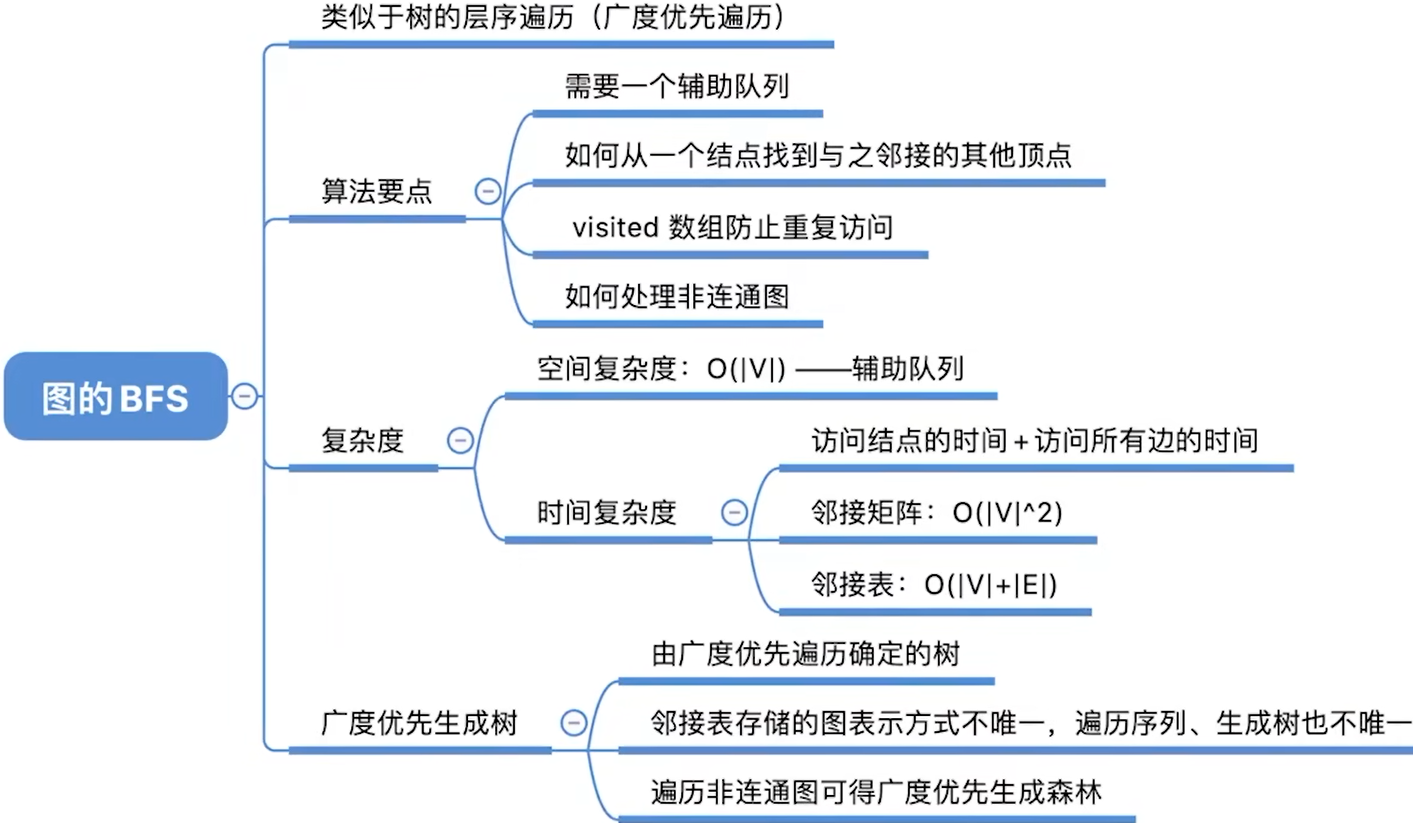
3、知识回顾
6.3.2图的深度优先遍历
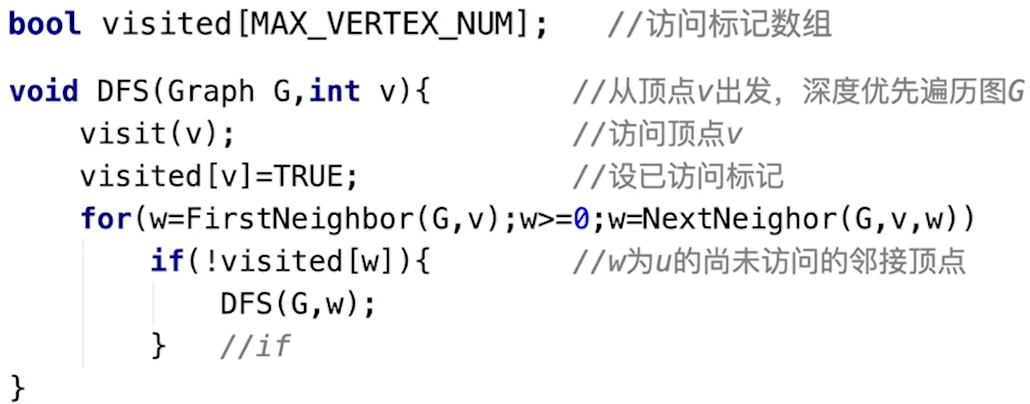
1、代码实现
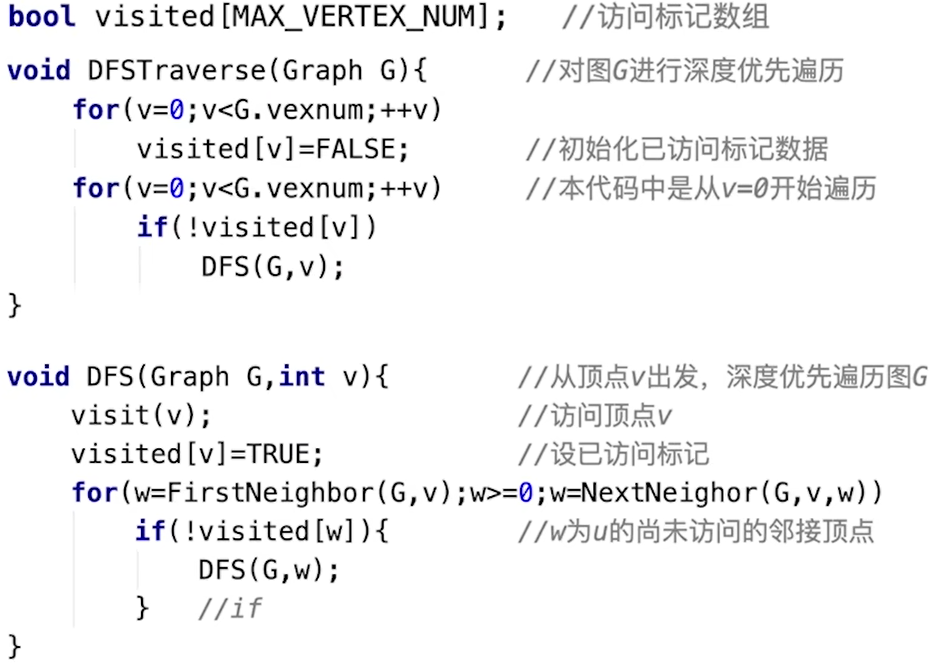
2、final版
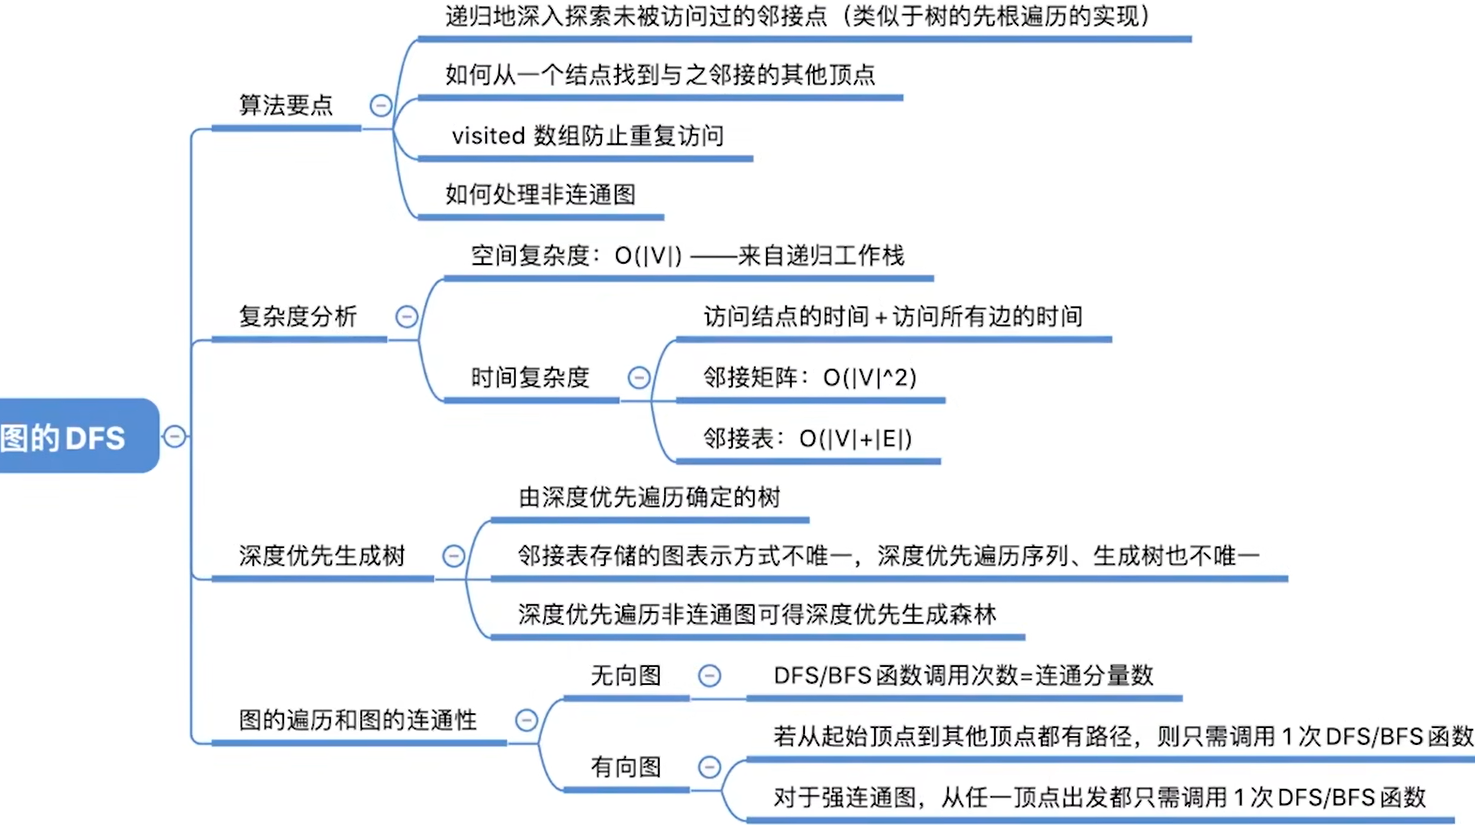
3、知识回顾
6.4图的应用
6.4.1最小生成树
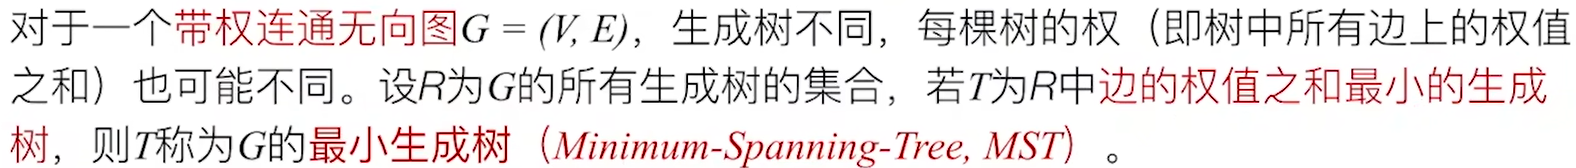
1、定义
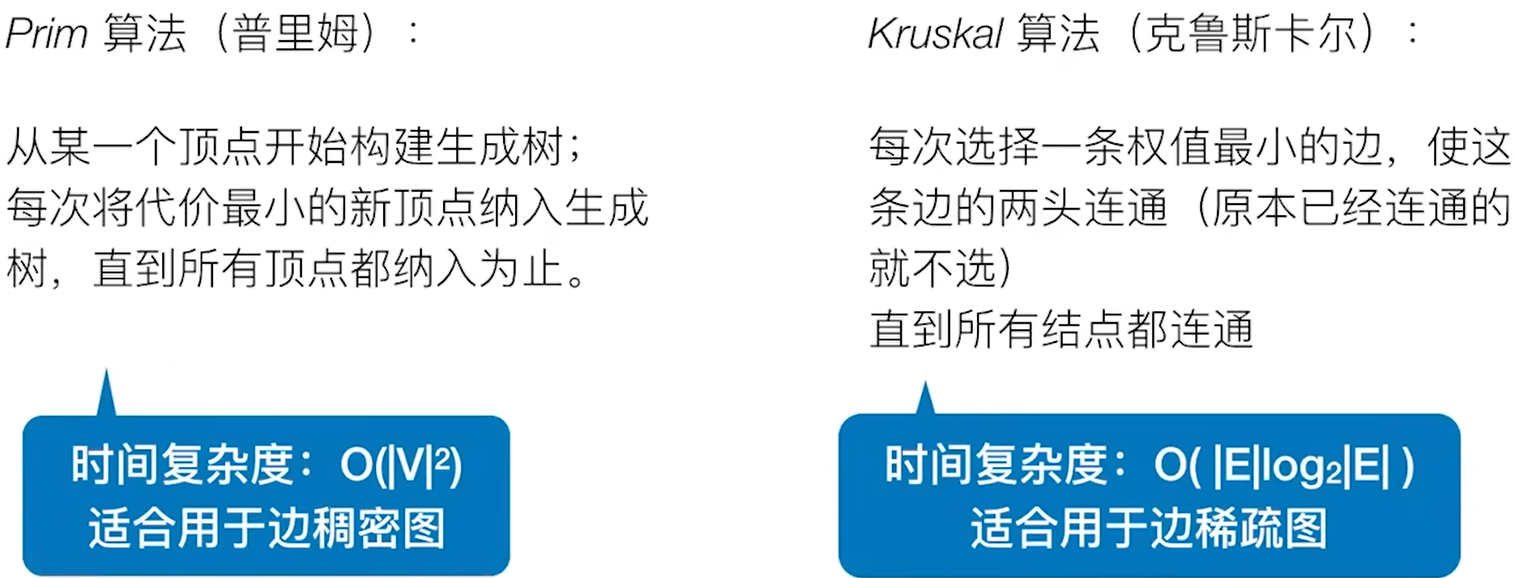
2、算法
6.4.2最短路径问题
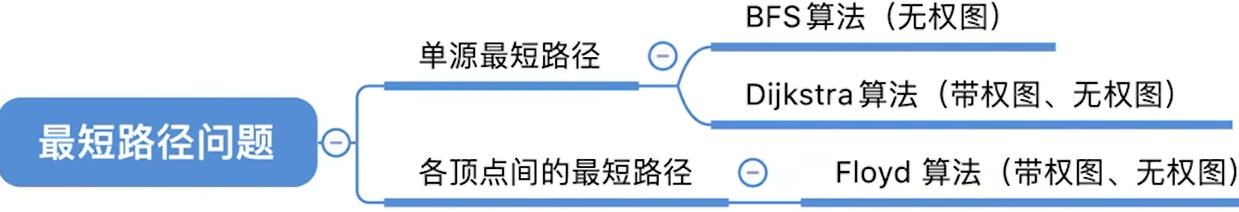
1、最短路径问题
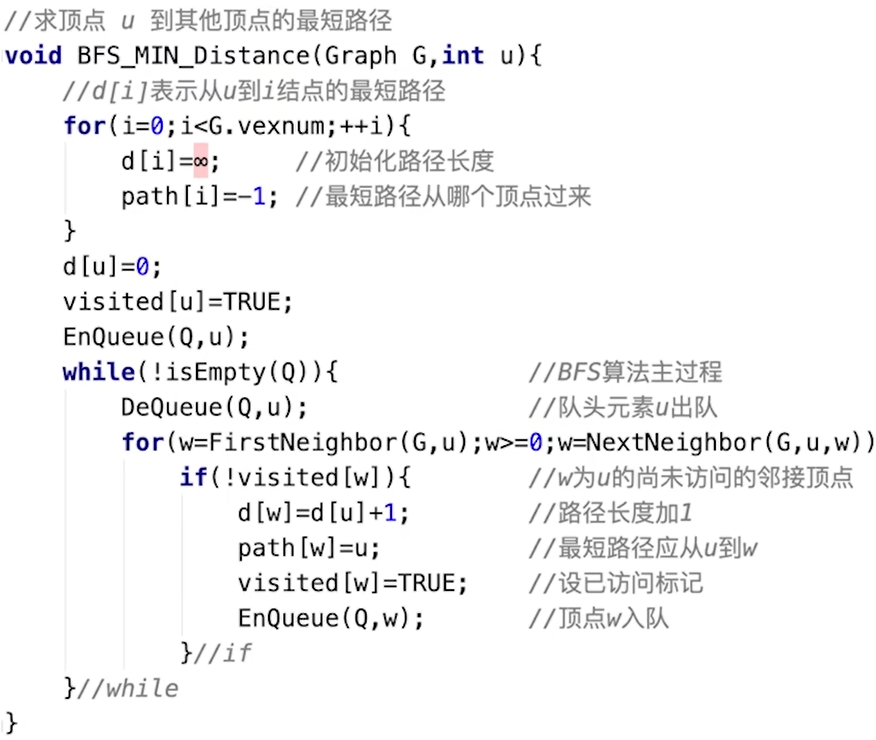
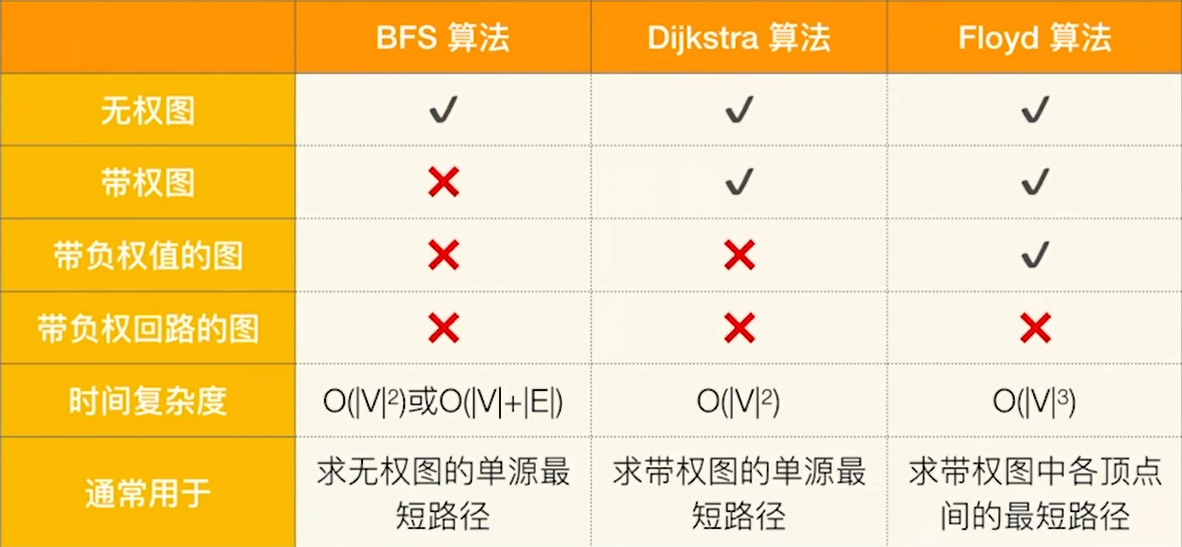
 2、BFS算法
3、Dijkstra算法
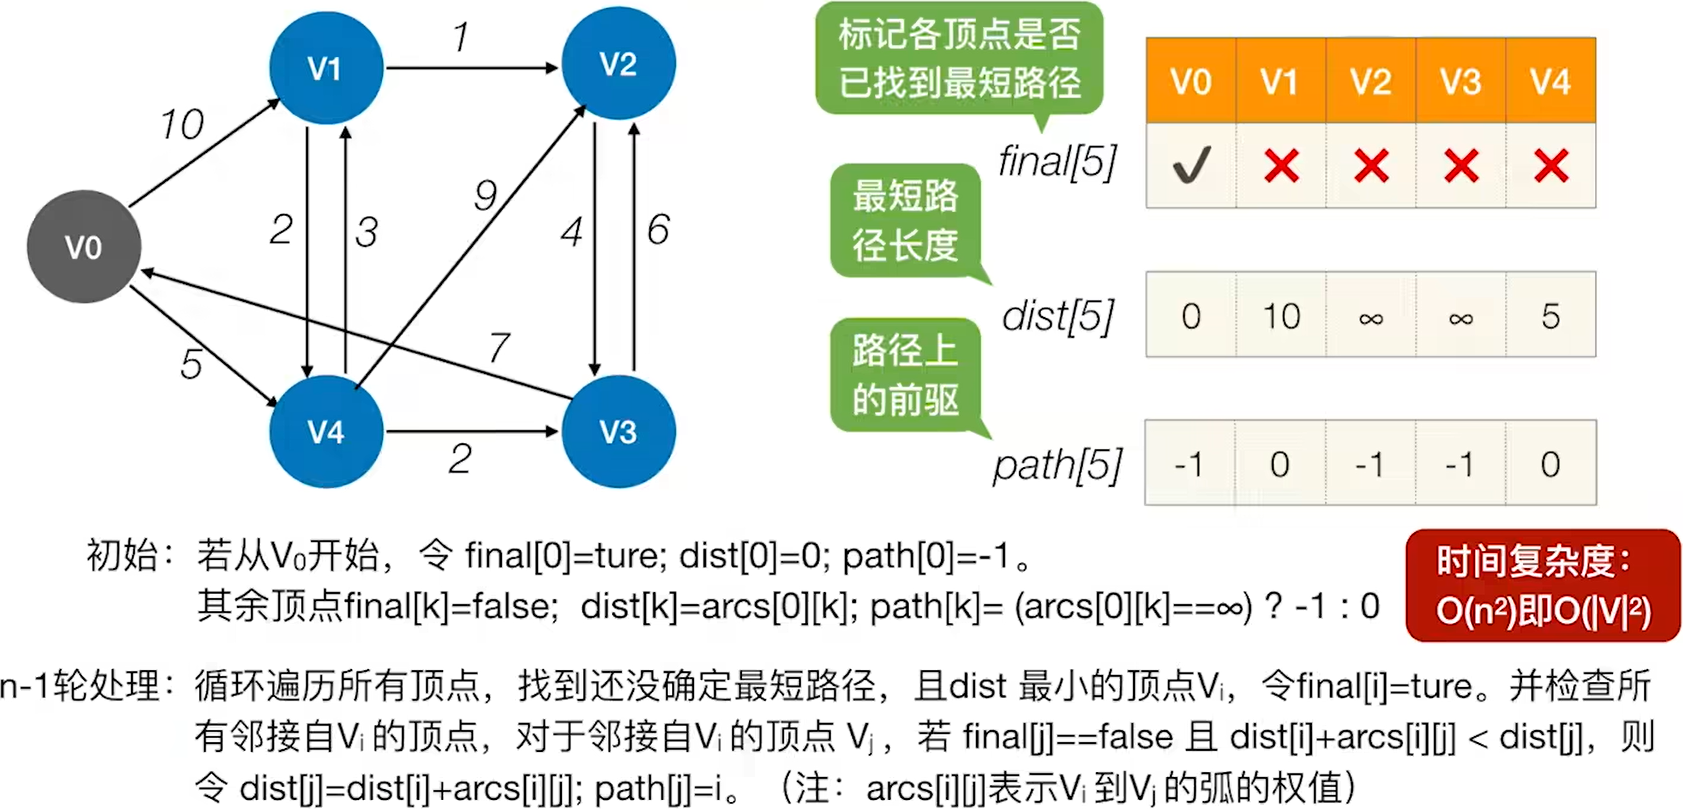
结论:Dijkstra算法不适合用于有负权值的带权图
4、Floyd算法
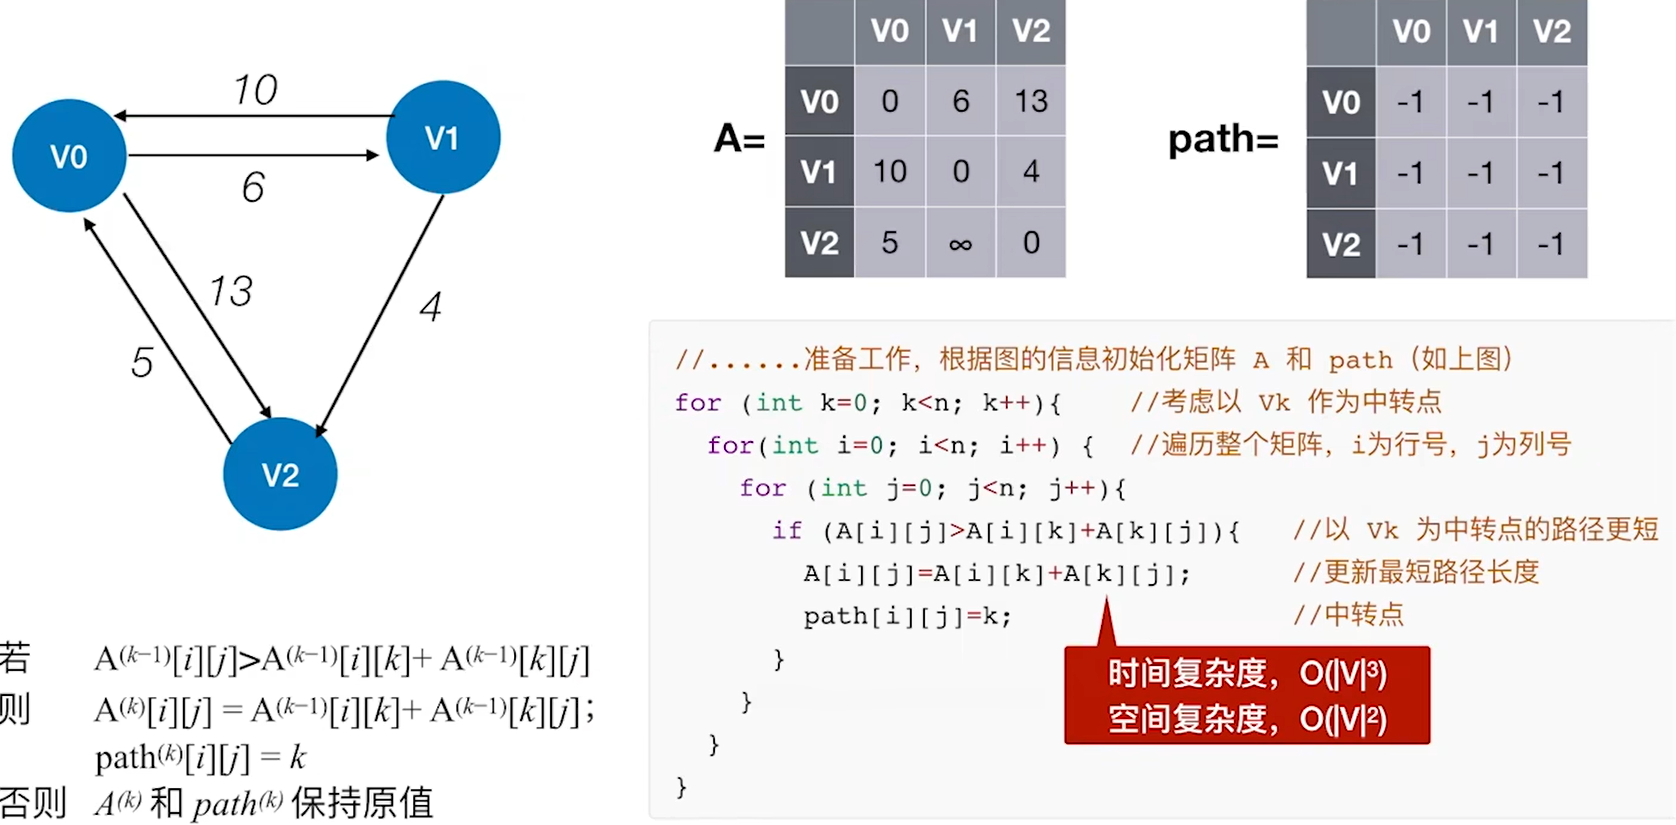
Floyd算法不能解决带有“负权回路”的图(有负权值得边组成回路),这种图有可能没有最短路径
5、知识回顾
6.4.3有向无环图描述表达式
1、定义
有向无环图:若一个有向图中不存在环,则称为有向无环图,简称DAG图
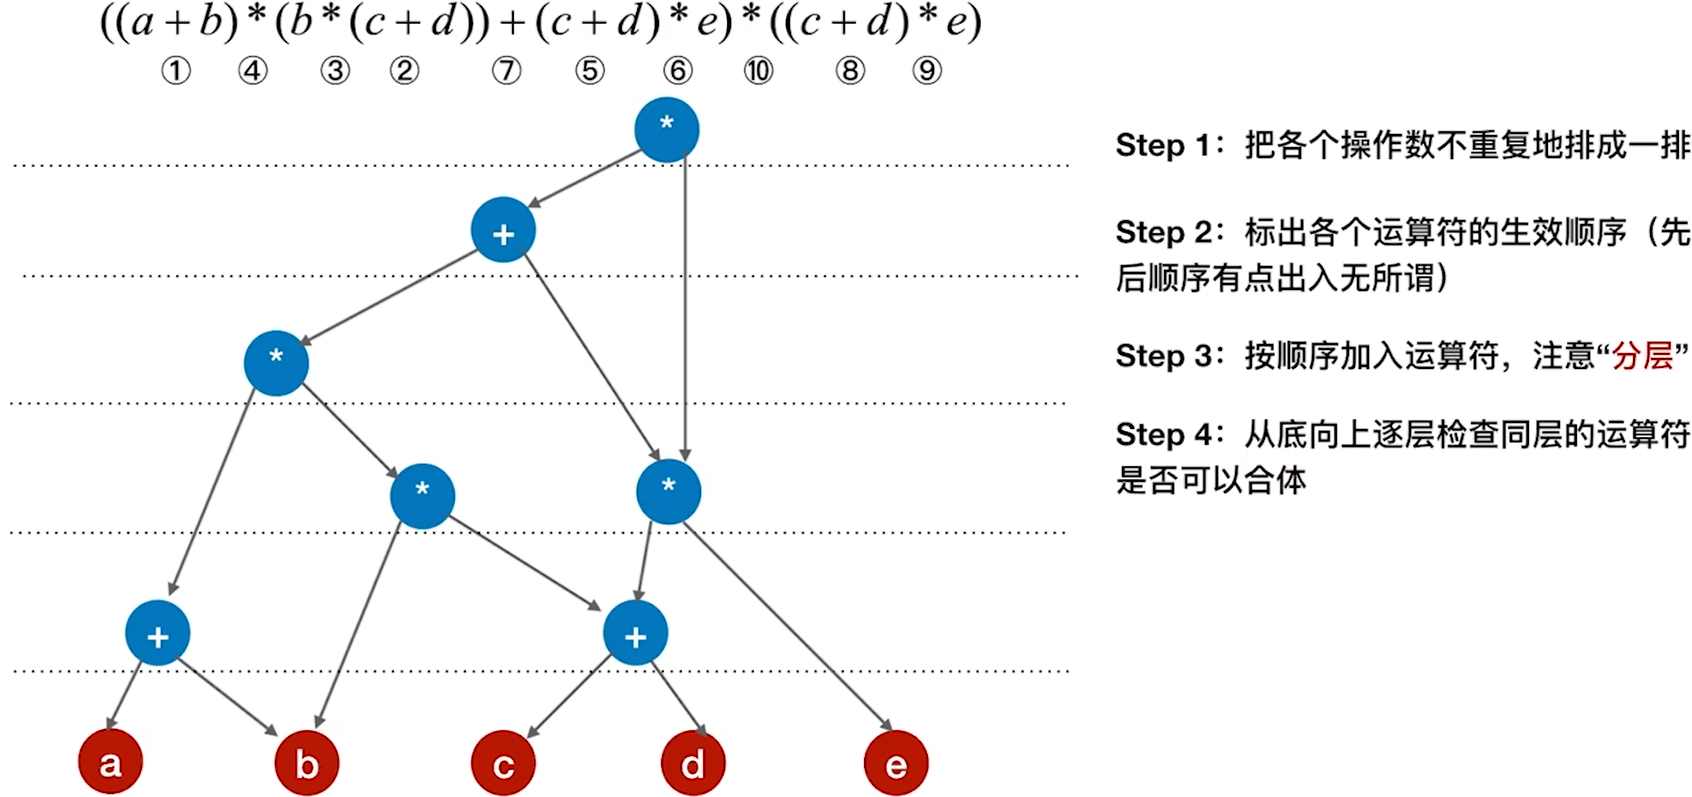
2、DAG描述表达式
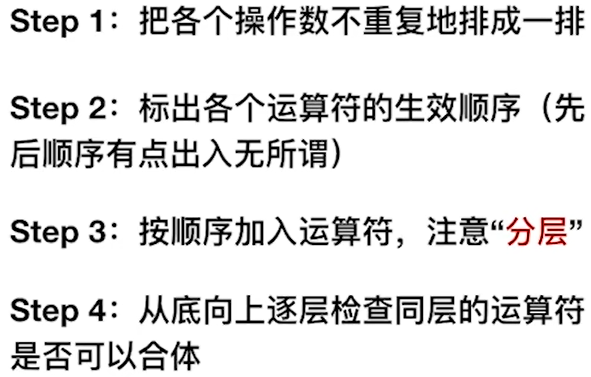
2.1、解题步骤:
2.2、案例:
6.4.4拓扑排序
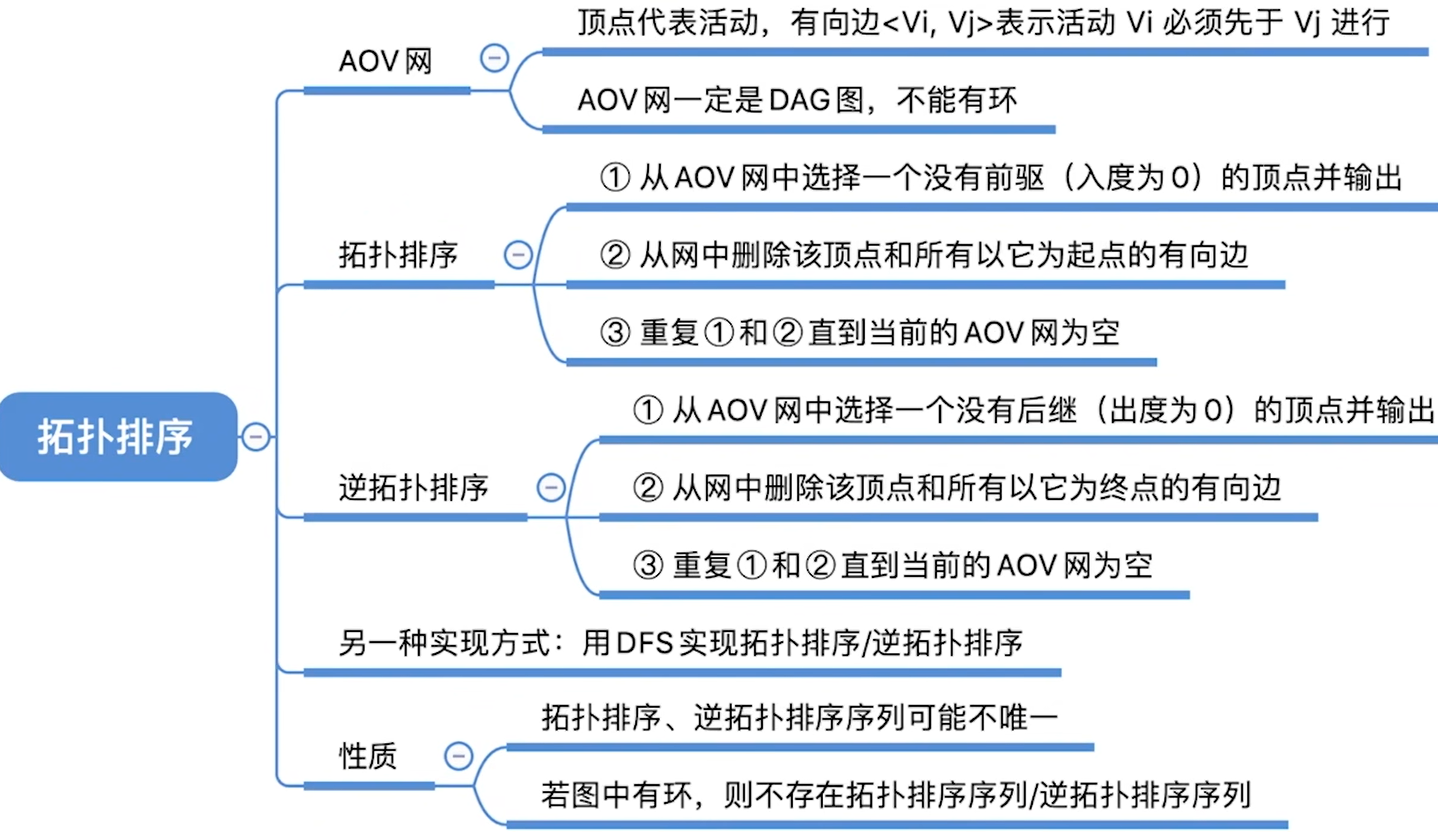
1、定义


2、代码实现
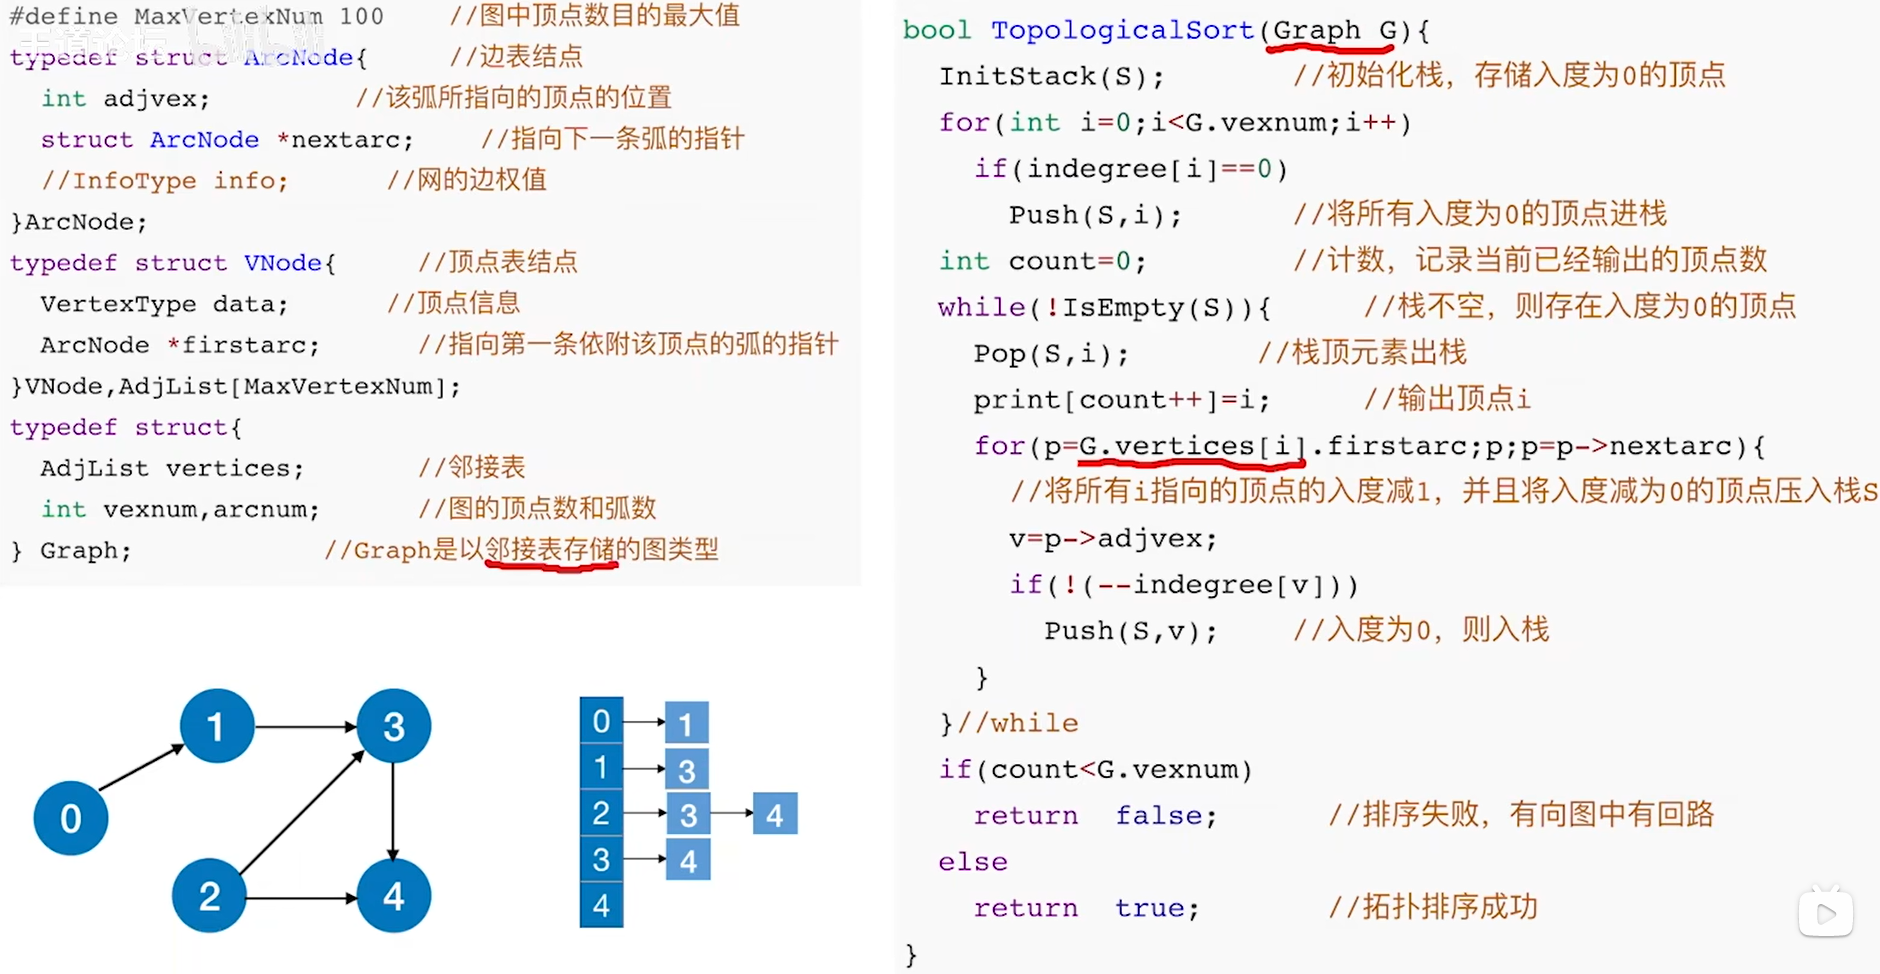
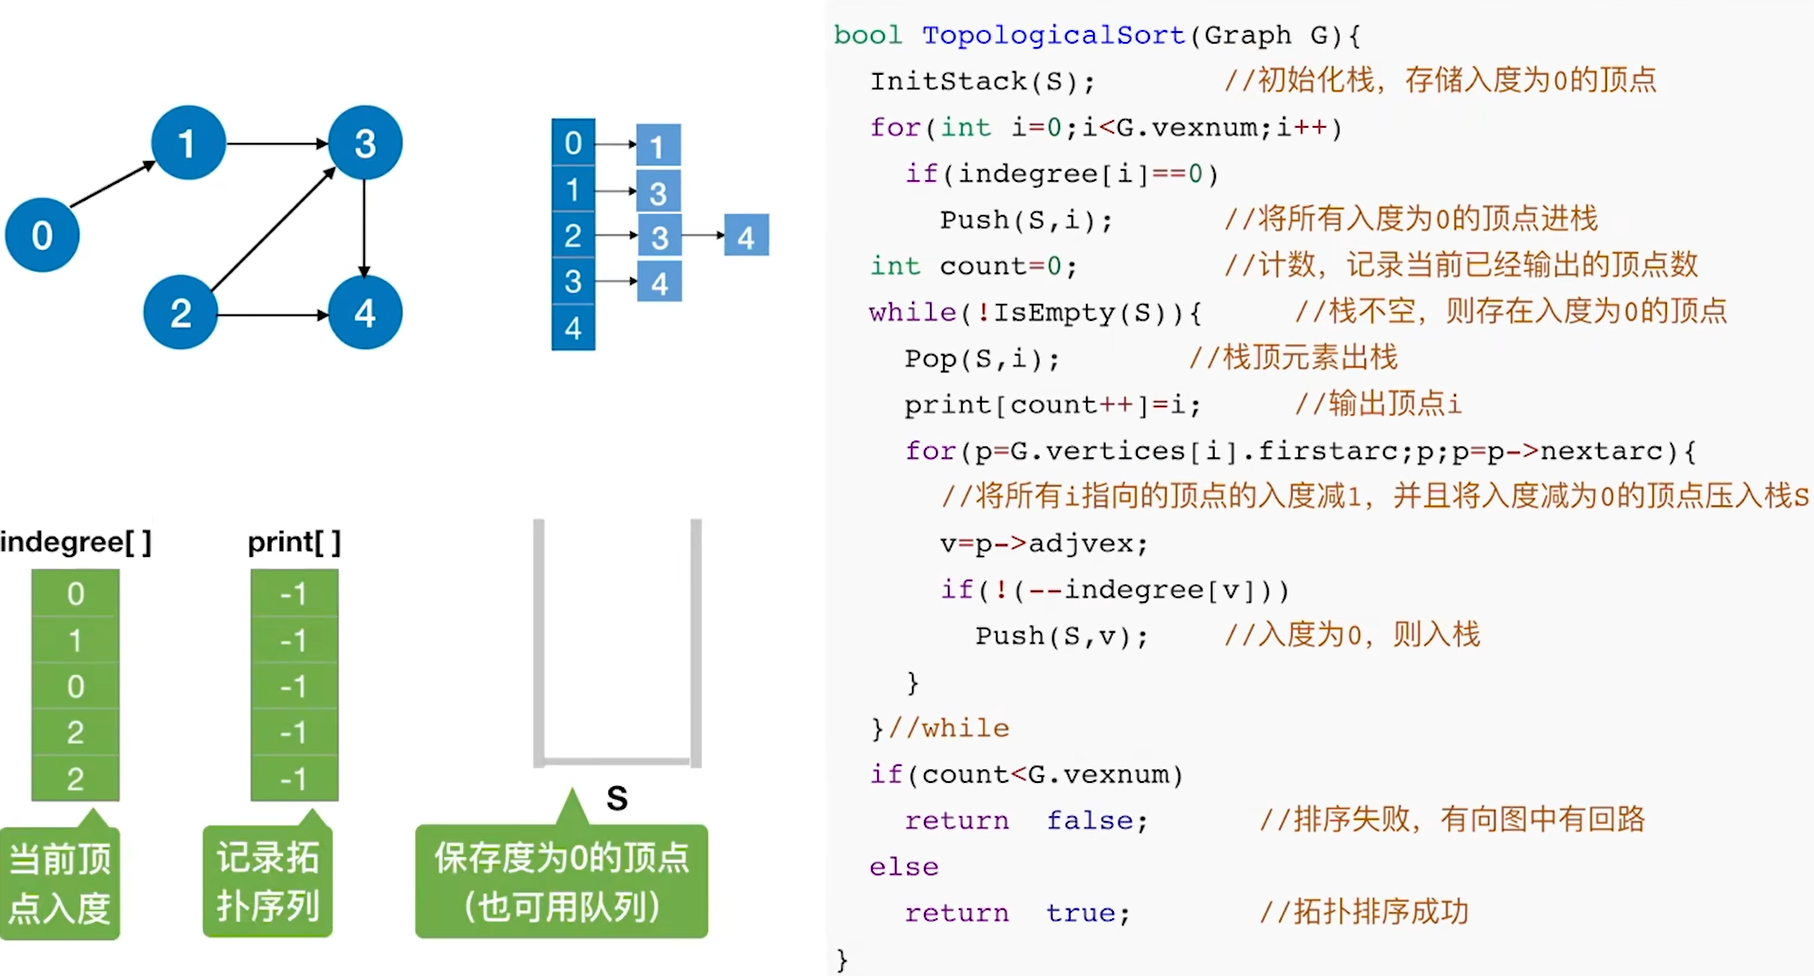
3、逆拓扑排序
3.1、定义
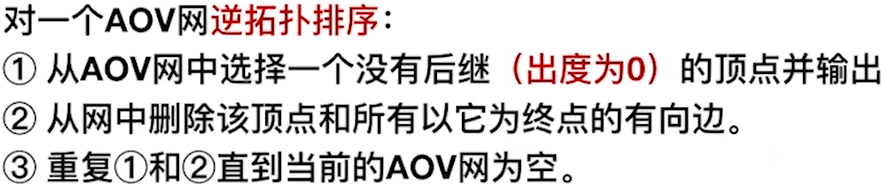
实现时把入度改为出度即可
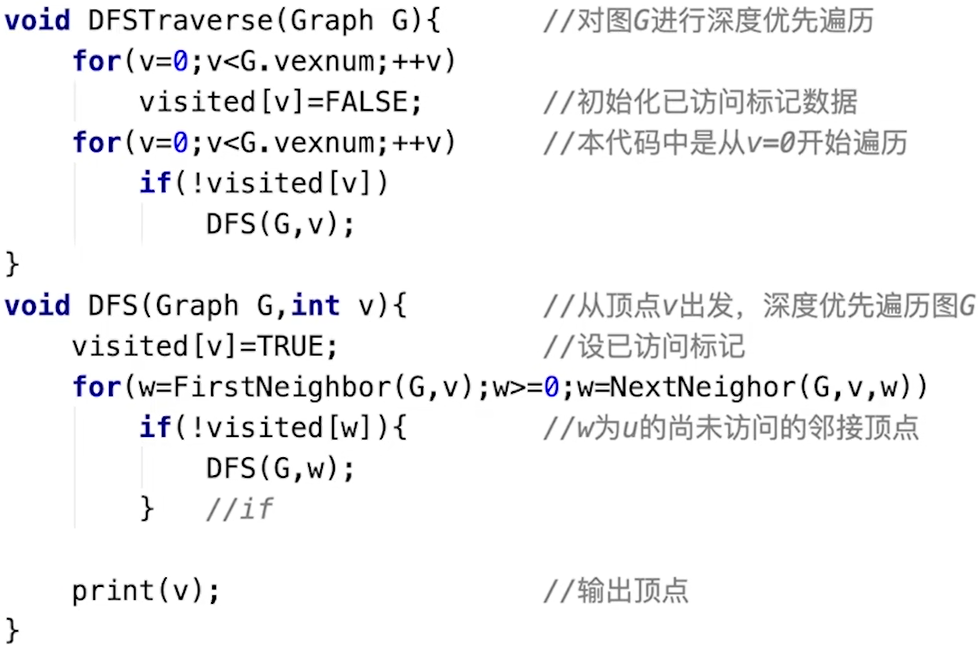
3.2、DFS算法实现逆拓扑
4、知识回顾
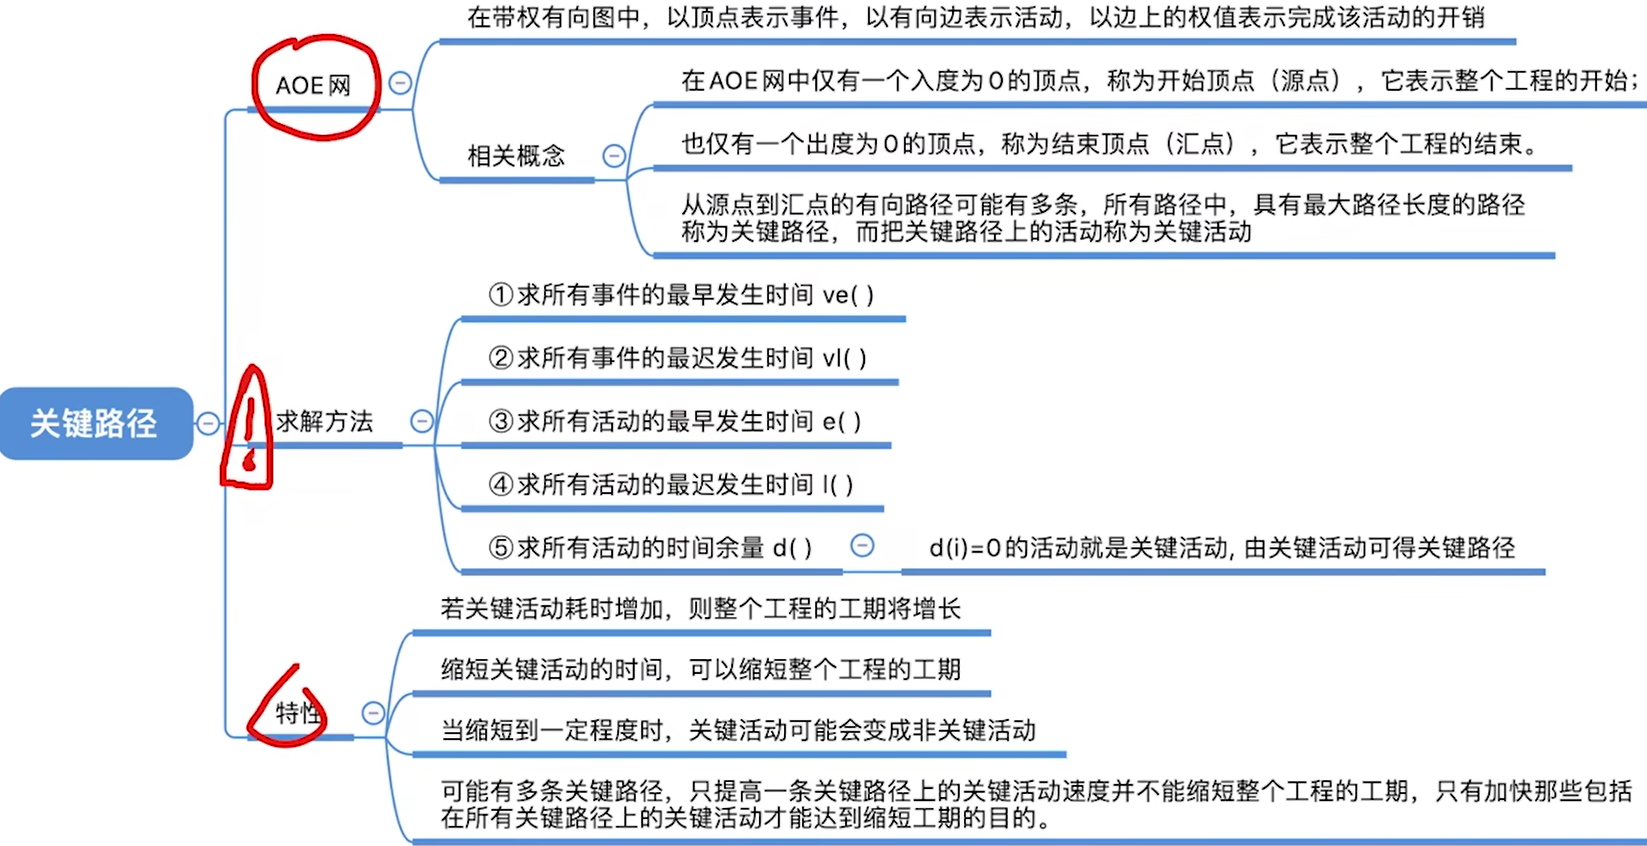
6.4.5关键路径
1、定义
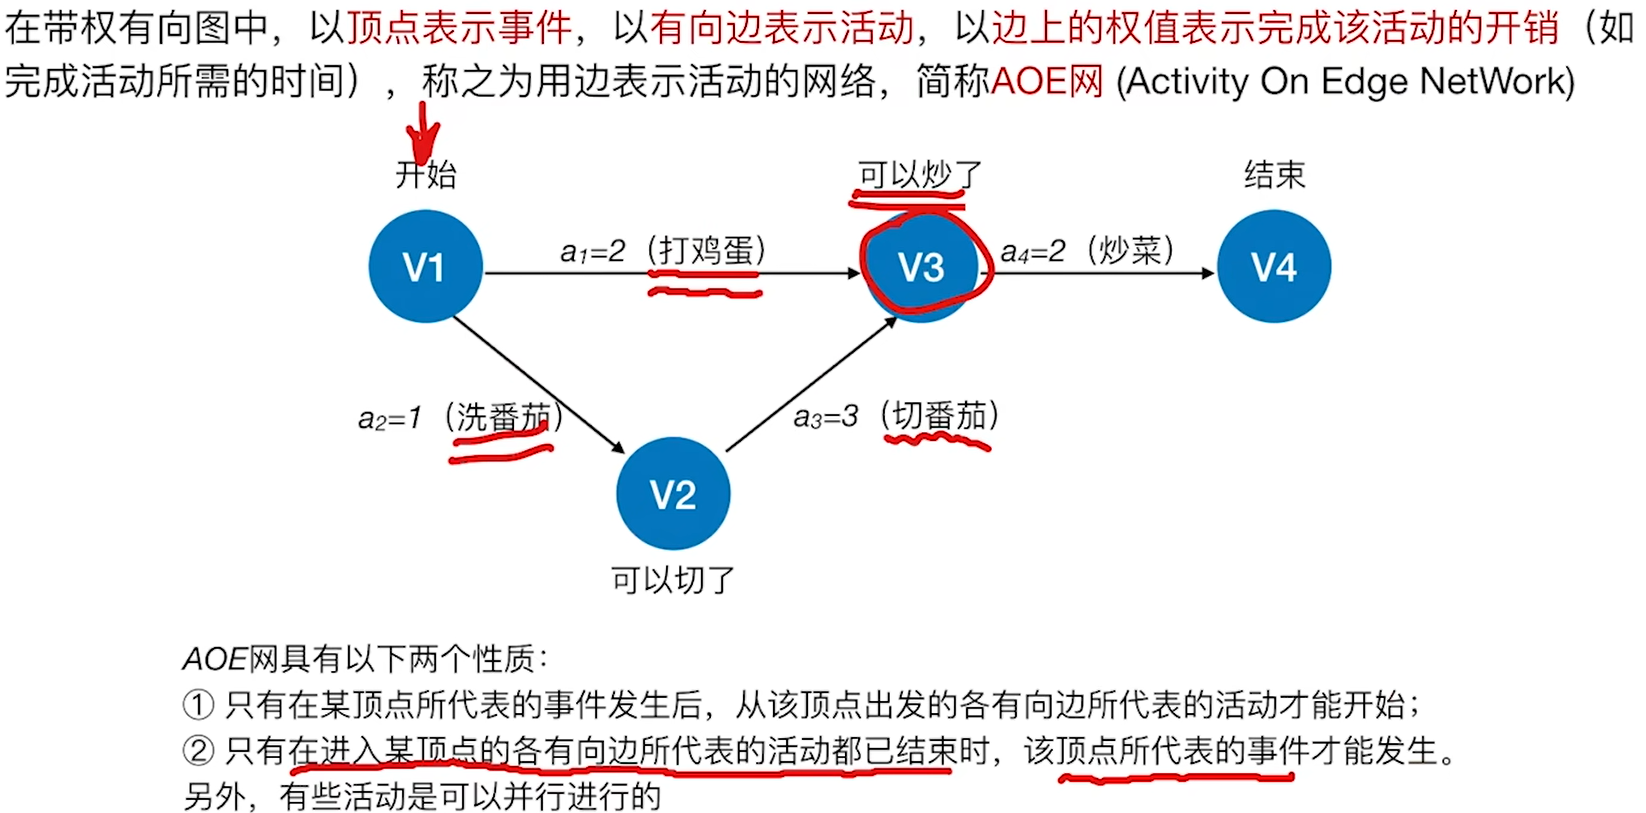
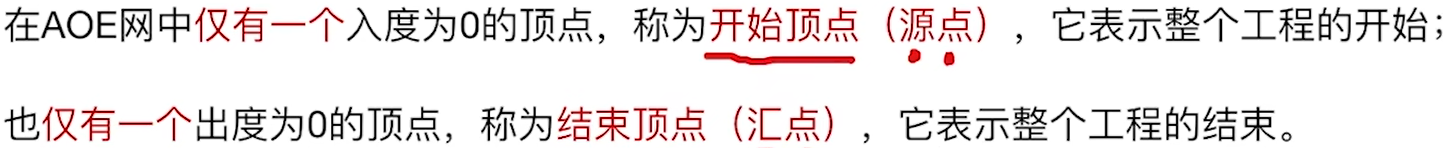
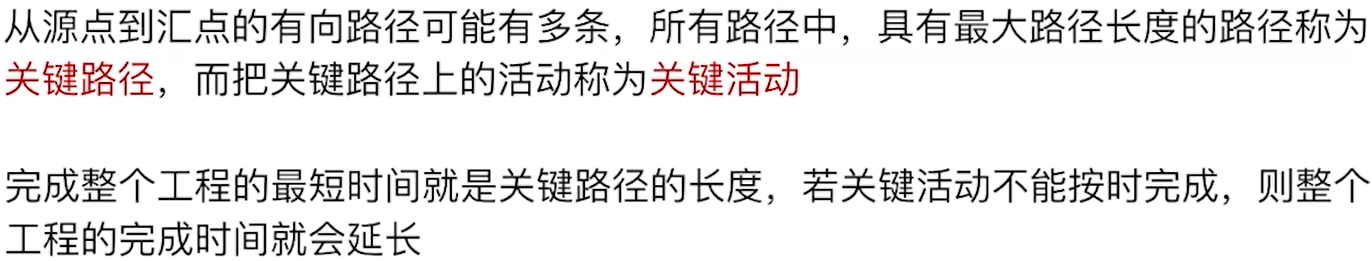
2、求解方法
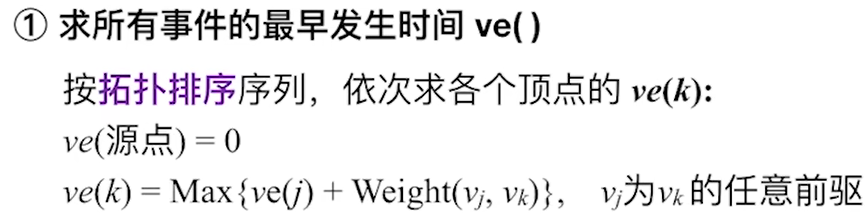
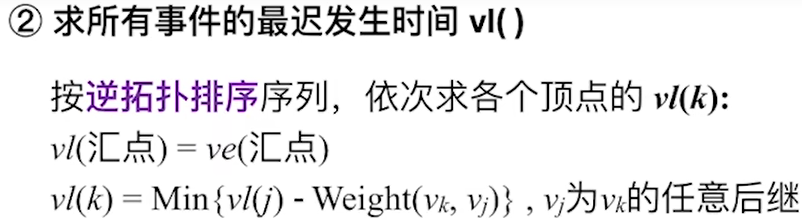
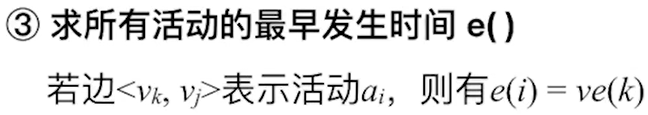
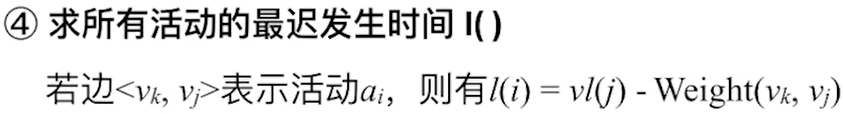
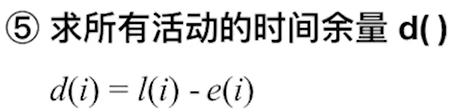
3、知识回顾
第七章 查找
7.1查找的基本概念
1、定义
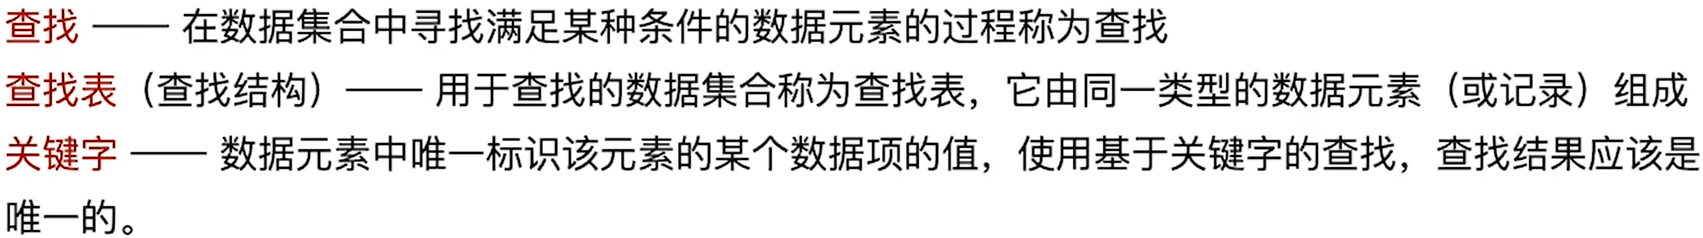
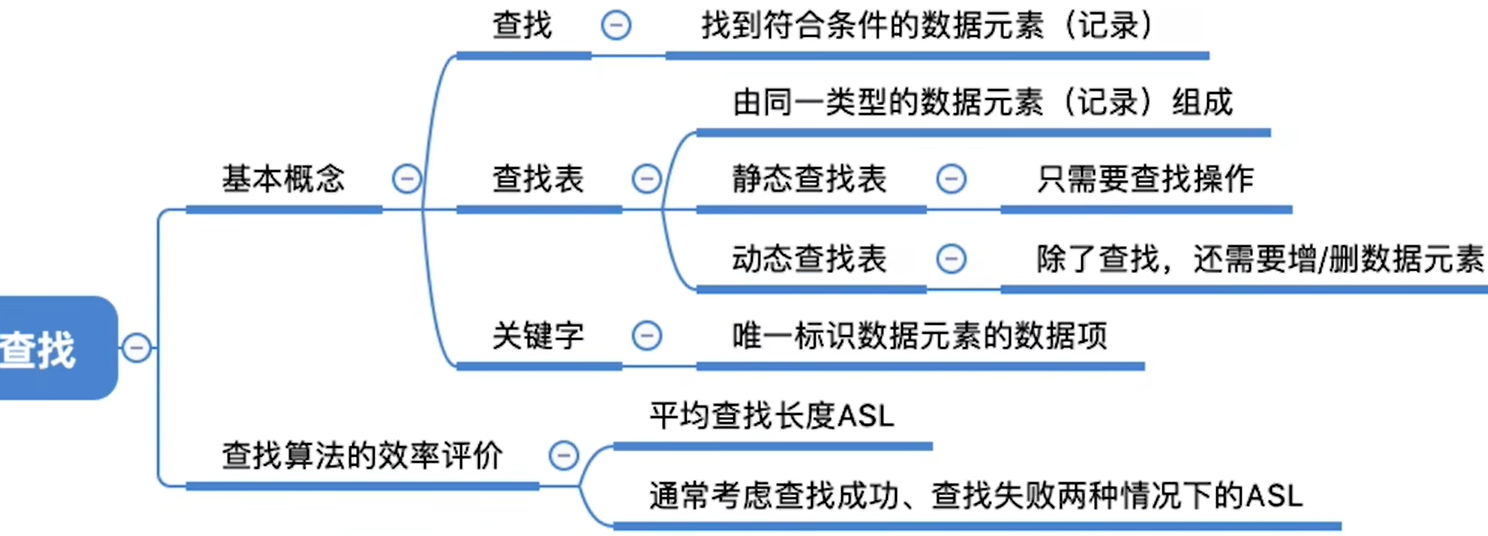
2、常见操作
(1)、查找符合条件的数据元素
静态查找表:仅关注查找速度即可
(2)、插入、删除某个数据元素
动态查找表:除了查找速度,也要关注插/删操作是否方便实现
3、评价指标

4、知识回顾
7.2顺序查找和折半查找
7.2.1顺序查找
1、定义
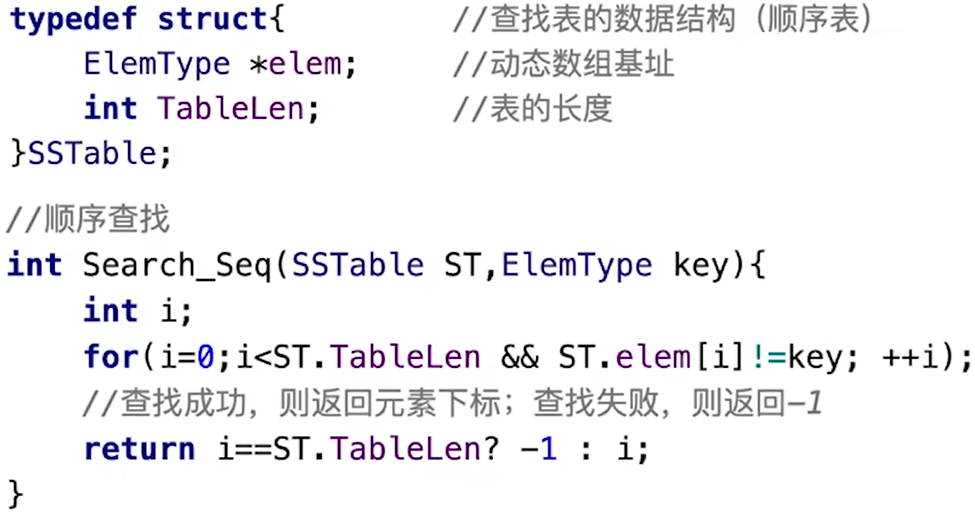
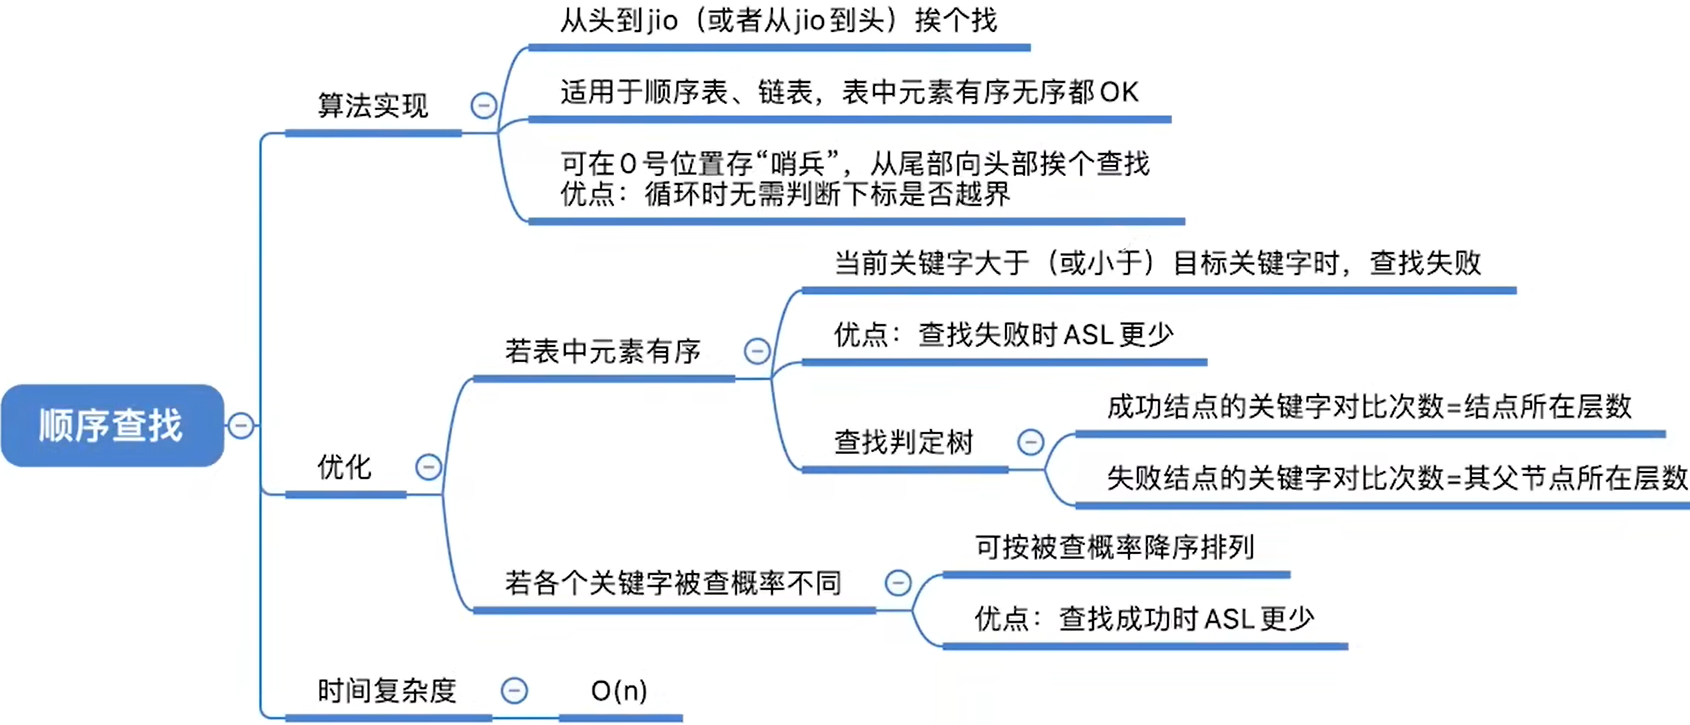
顺序查找,又叫“线性查找”,通常用于线性表
算法思想:从头到尾挨个对比(或者反过来)
2、实现
3、知识回顾
7.2.2折半查找
1、定义
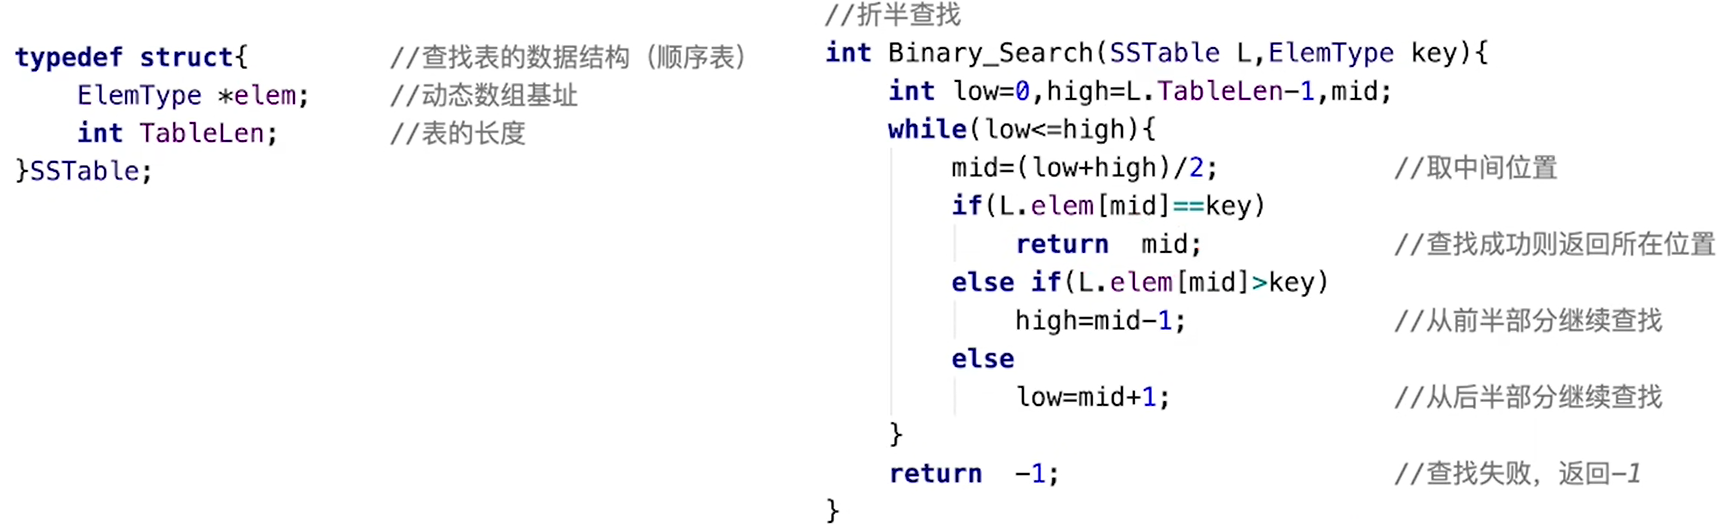
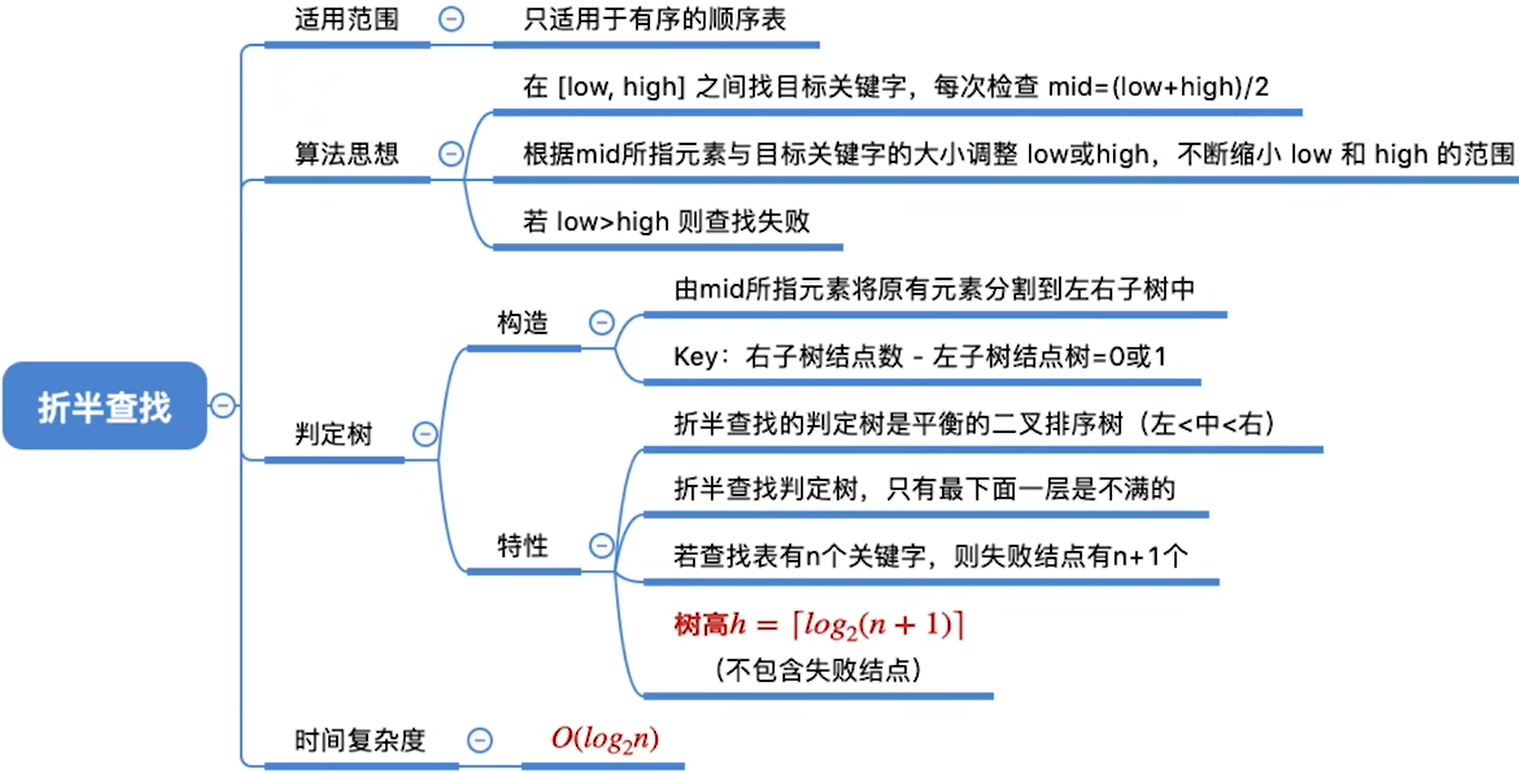
折半查找,又称“二分查找”,仅适用于有序的顺序表
2、实现
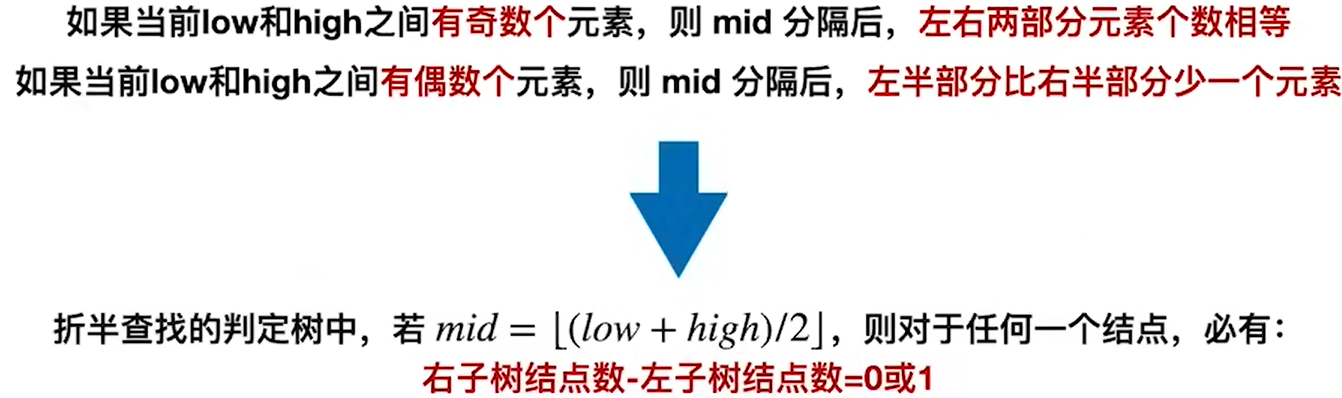
3、折半查找判定树的构造
4、知识回顾
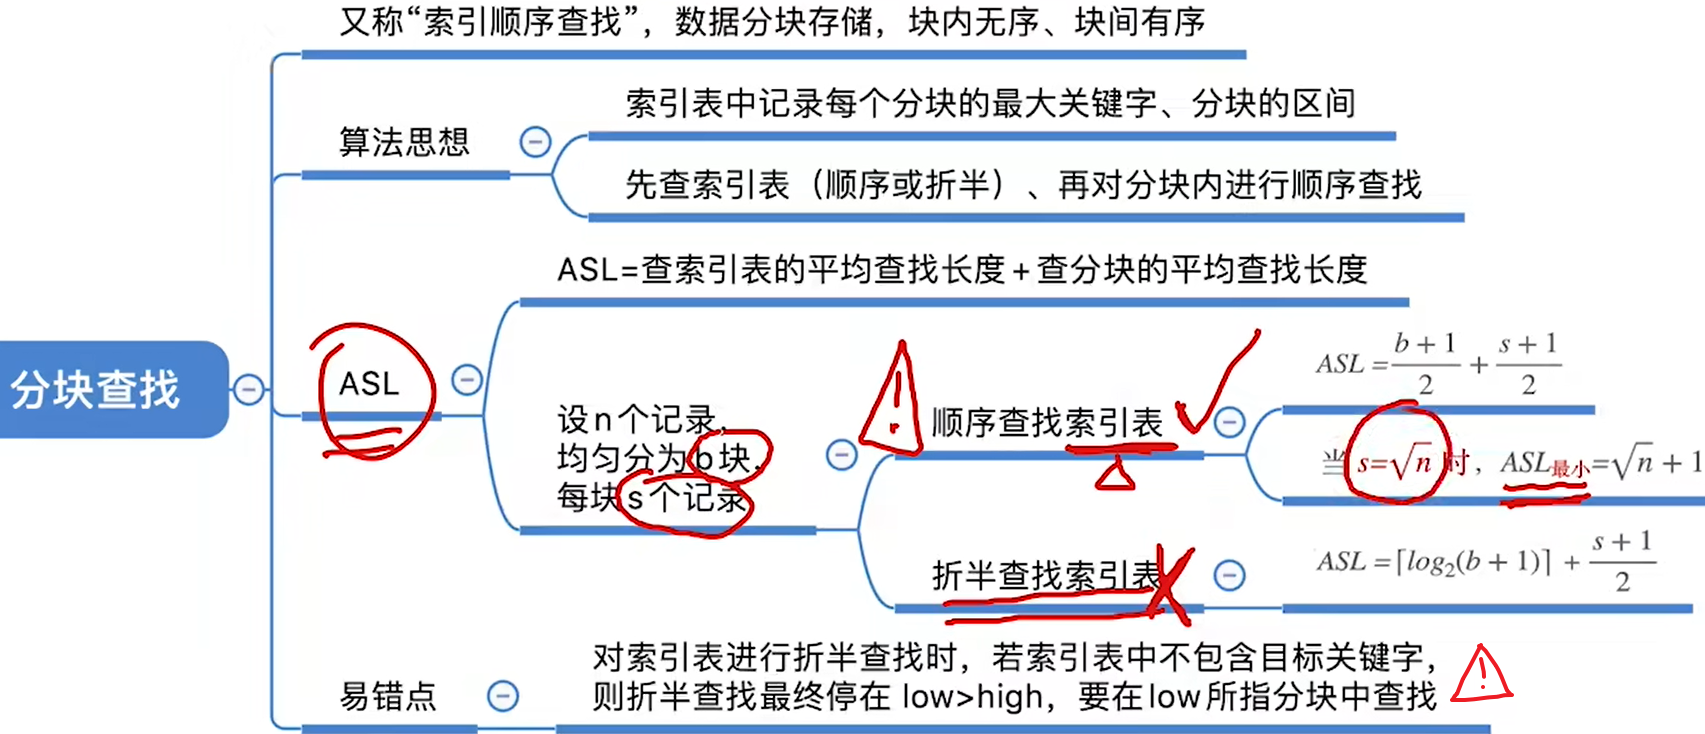
7.2.3分块查找(不考察代码)
1、定义
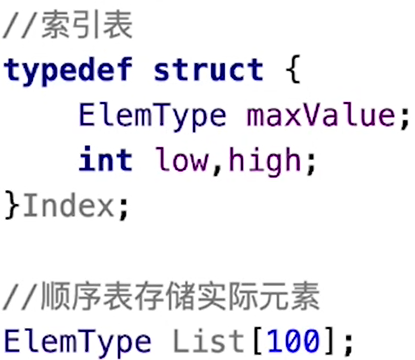
“索引表”中保存每个分块的最大关键字和分块的存储区间
特点:块内无序、块间有序
超出分块范围,查找失败
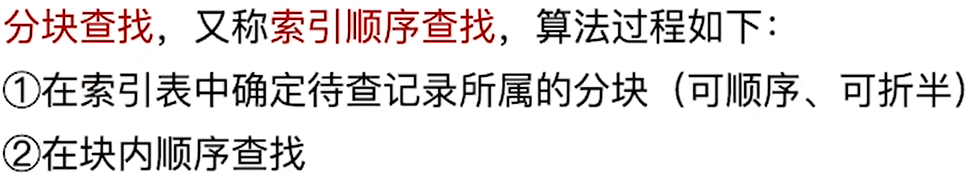
若索引表中不包含目标关键字,则折半查找索引表最终停在low>high,要在low所指分块中查找
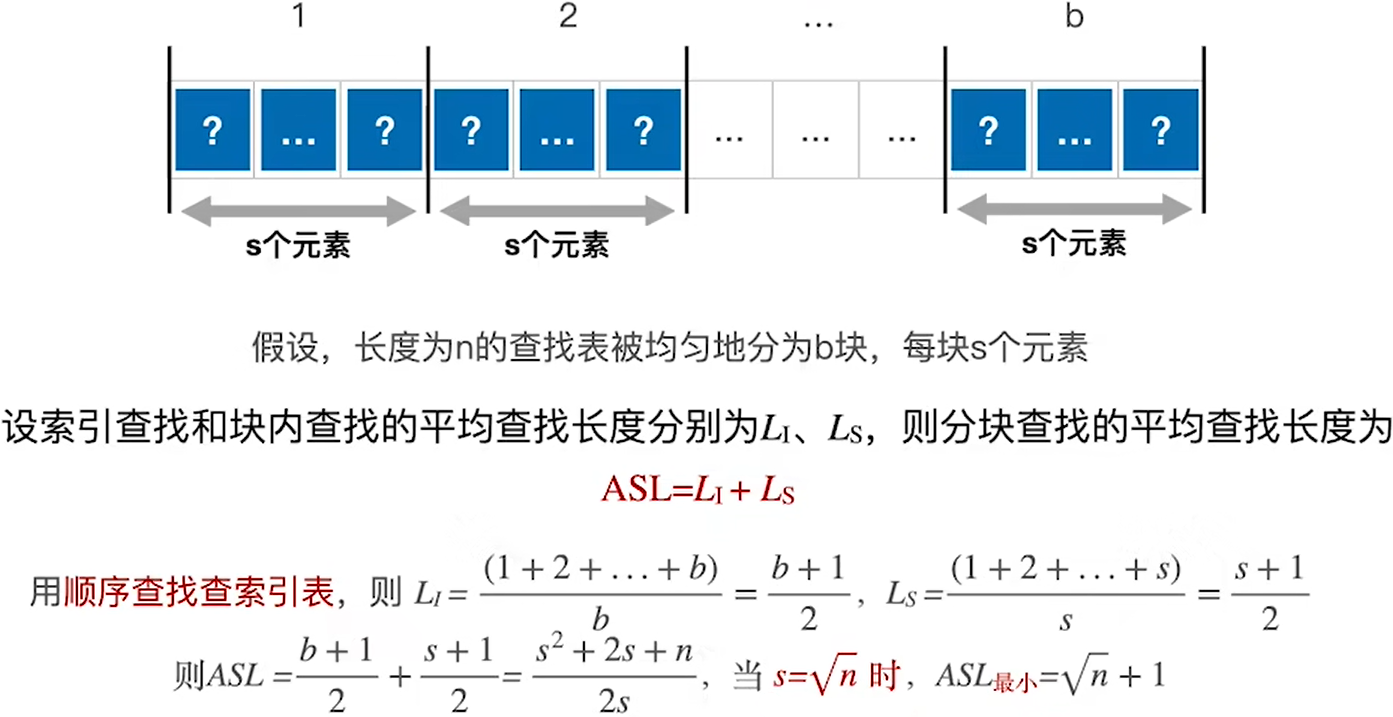
2、查找效率分析
3、知识回顾
7.3B树和B+树
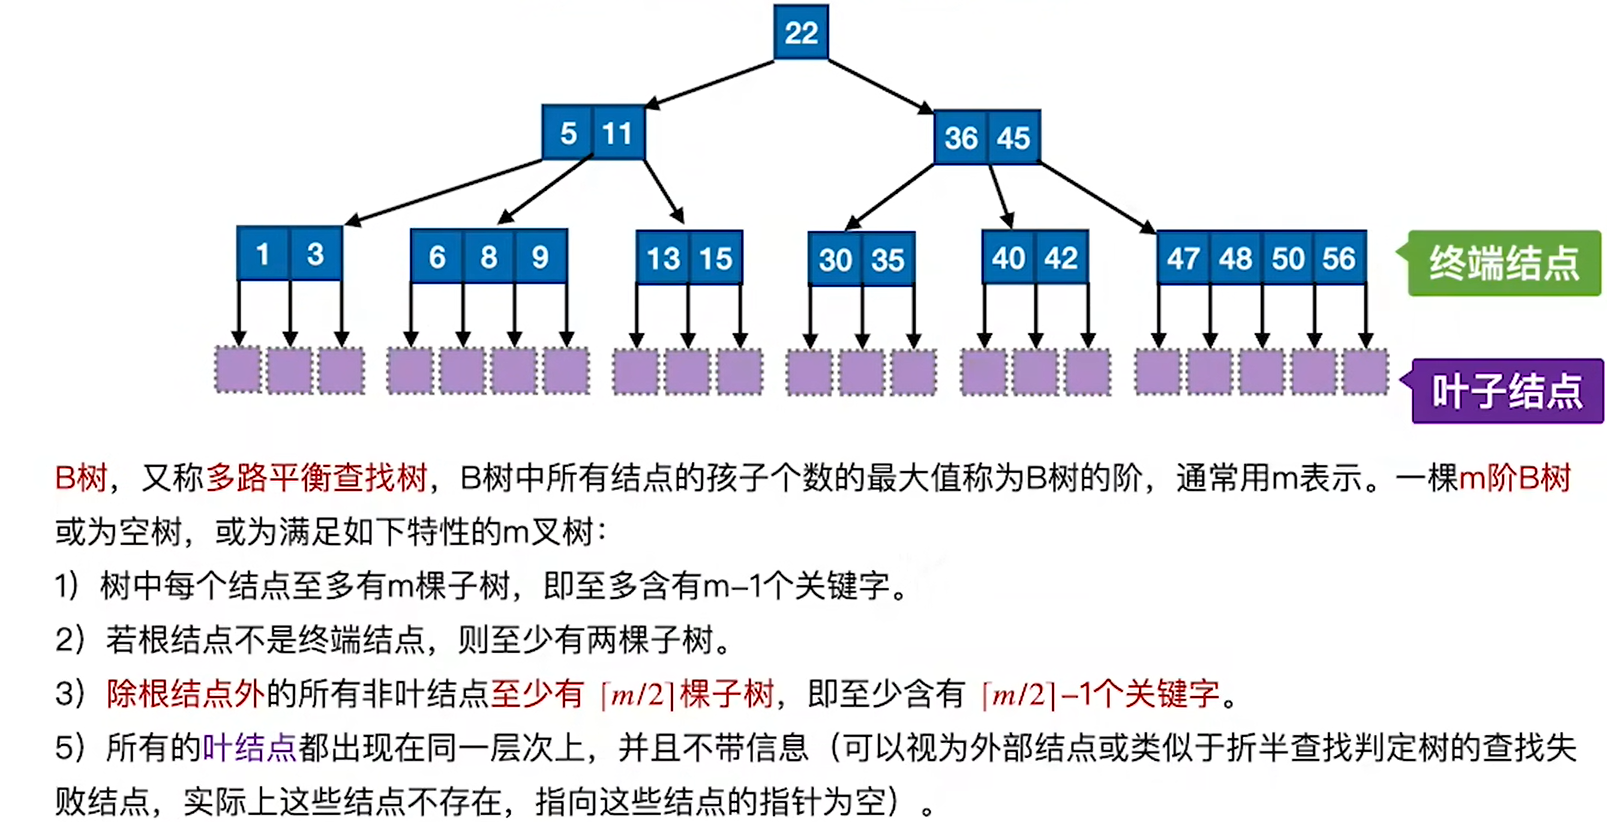
7.3.1B树
1、定义

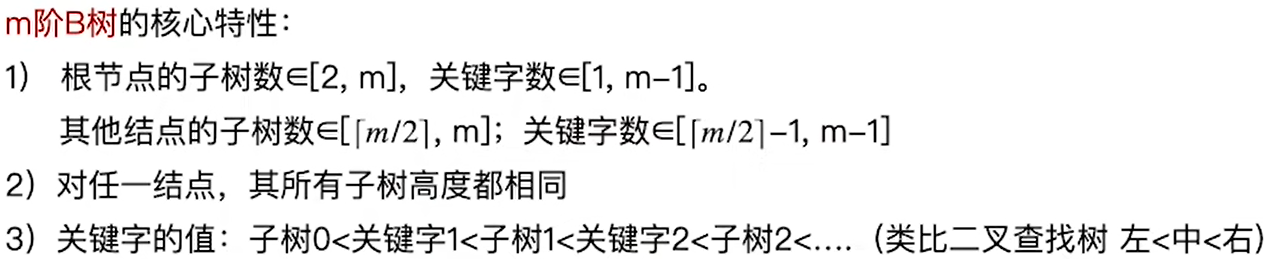
m阶B树的核心特性:
保证效率:


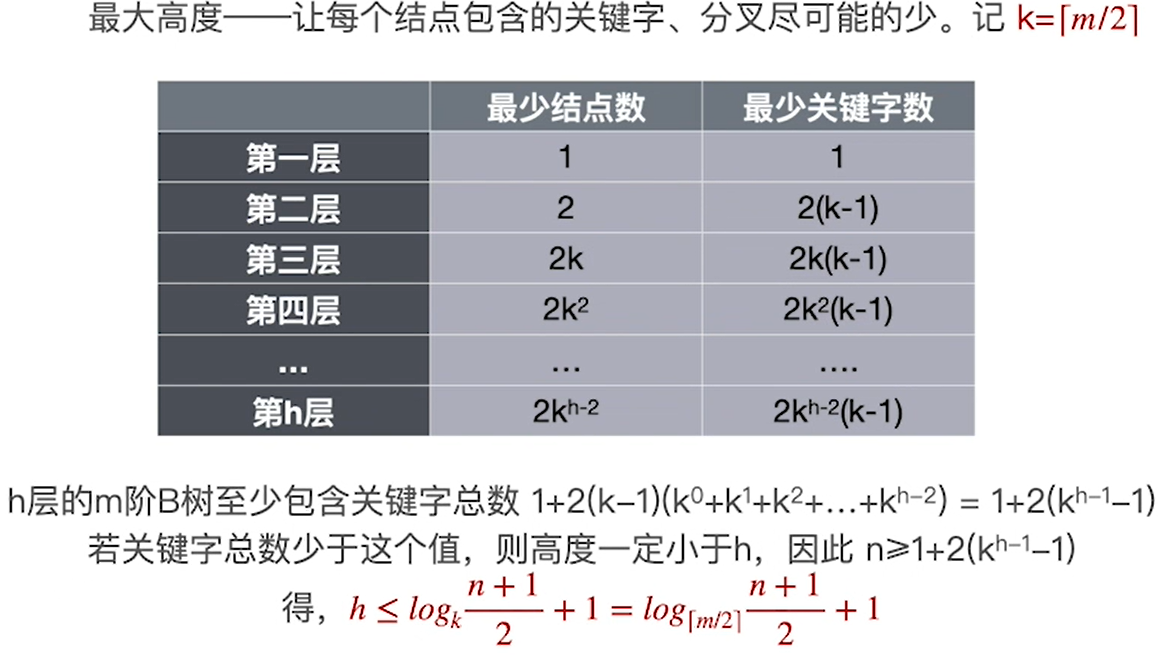
2、B树的高度
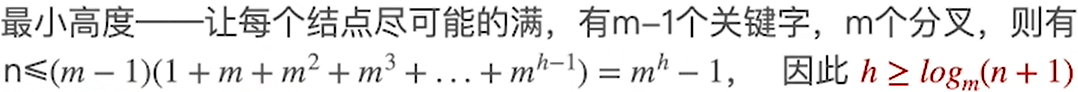
7.3.2B树的插入删除
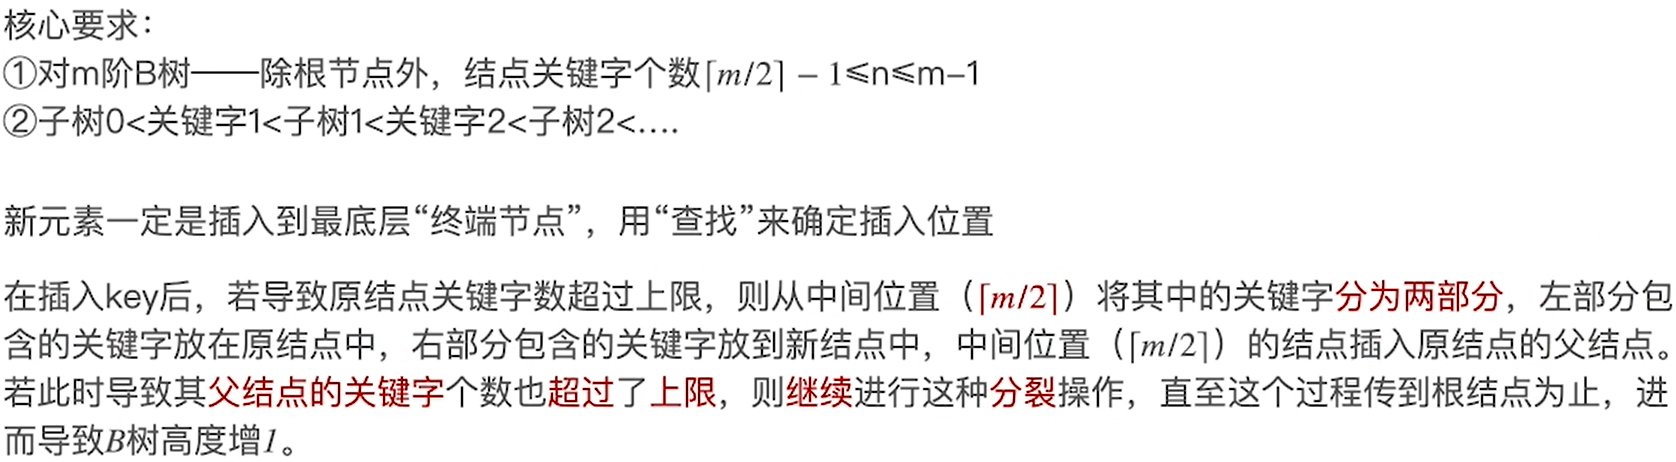
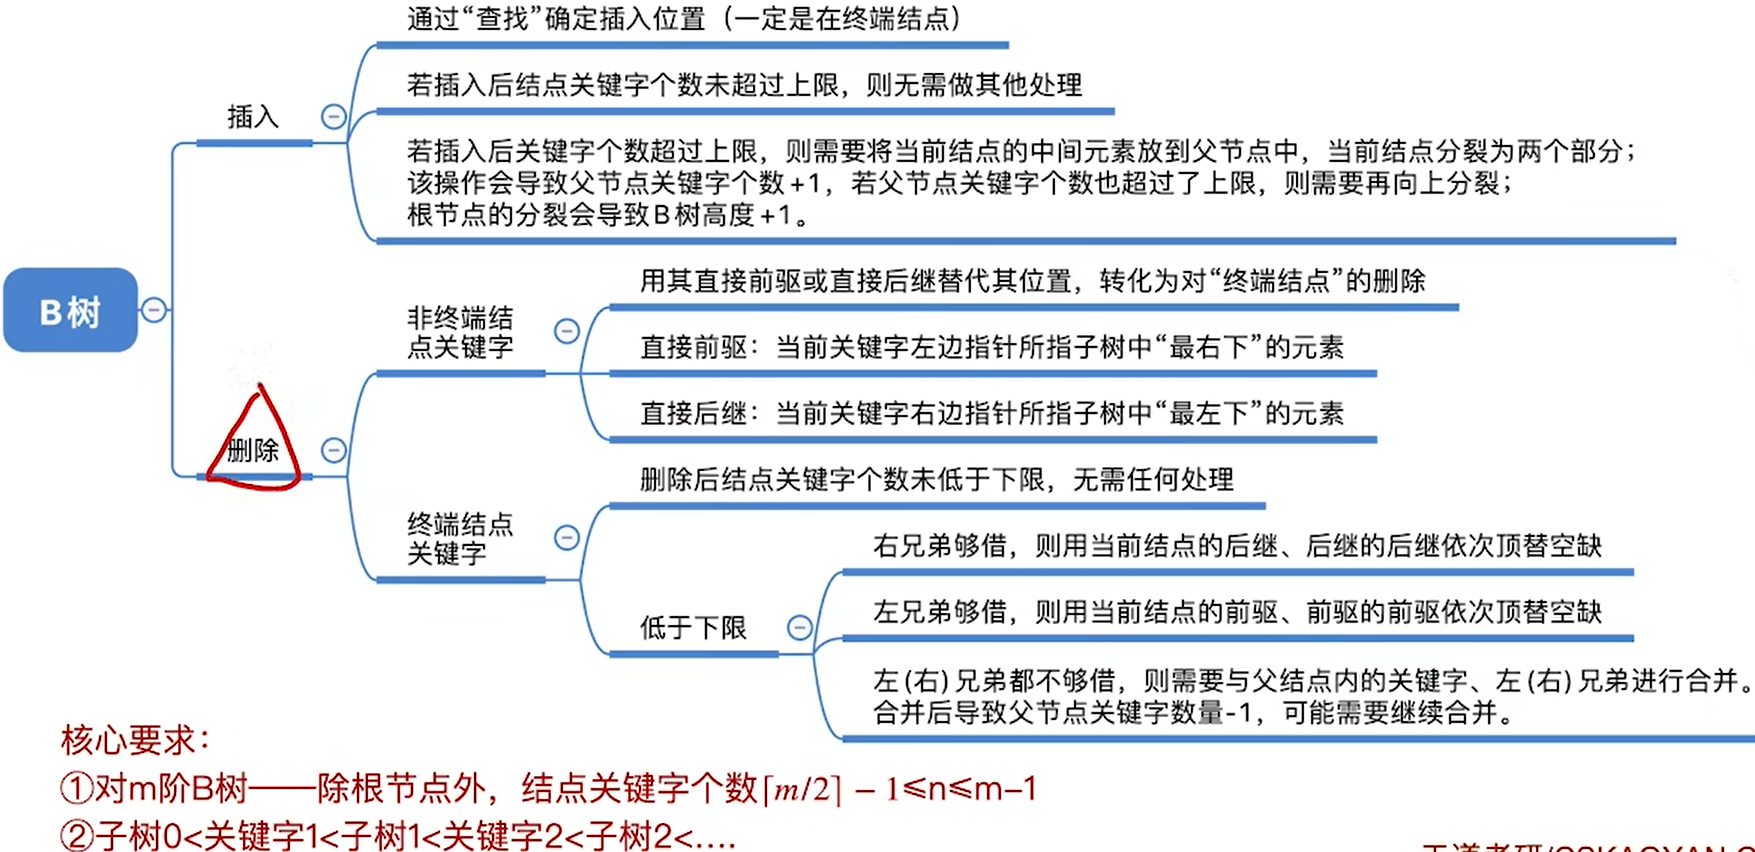
1、插入
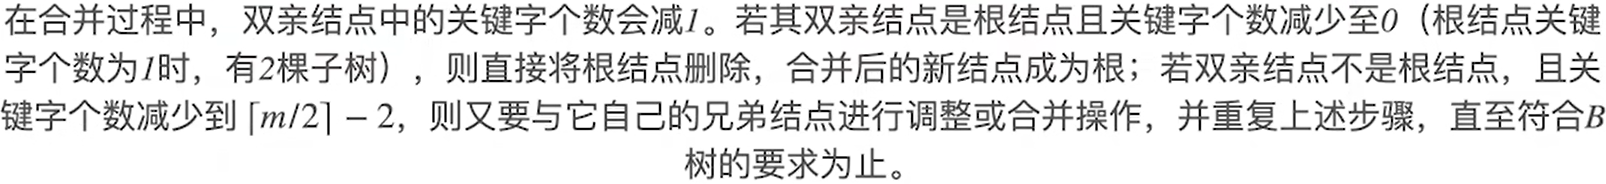
2、删除
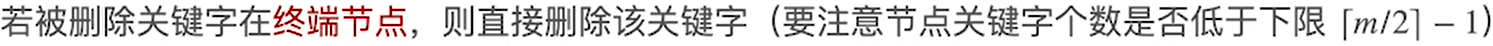



3、知识回顾
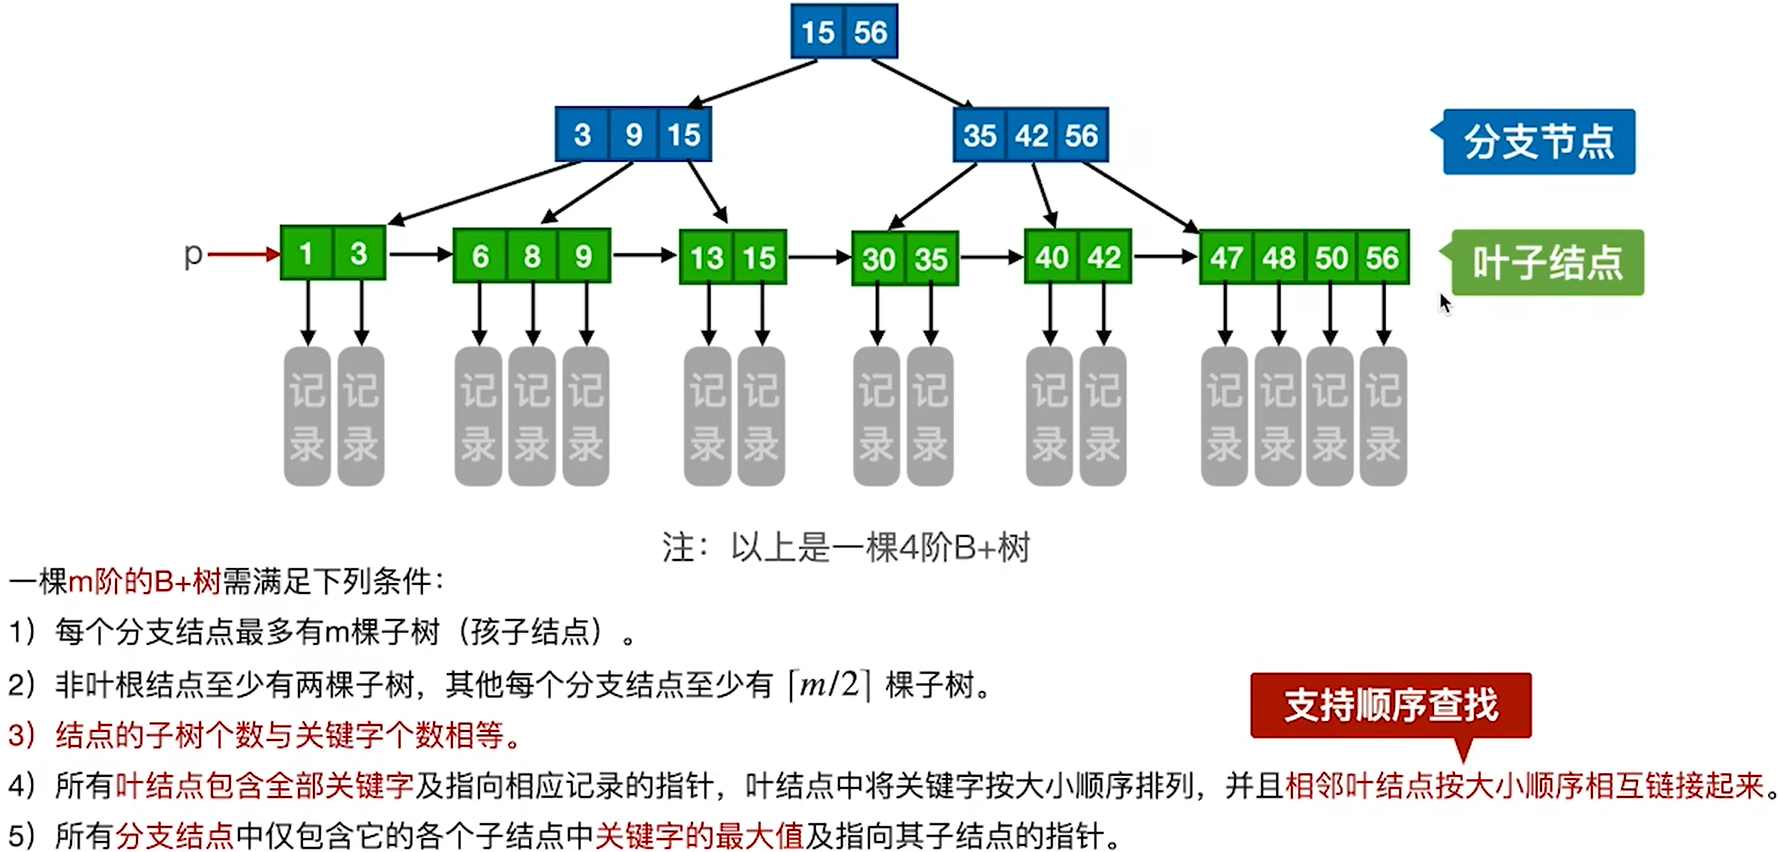
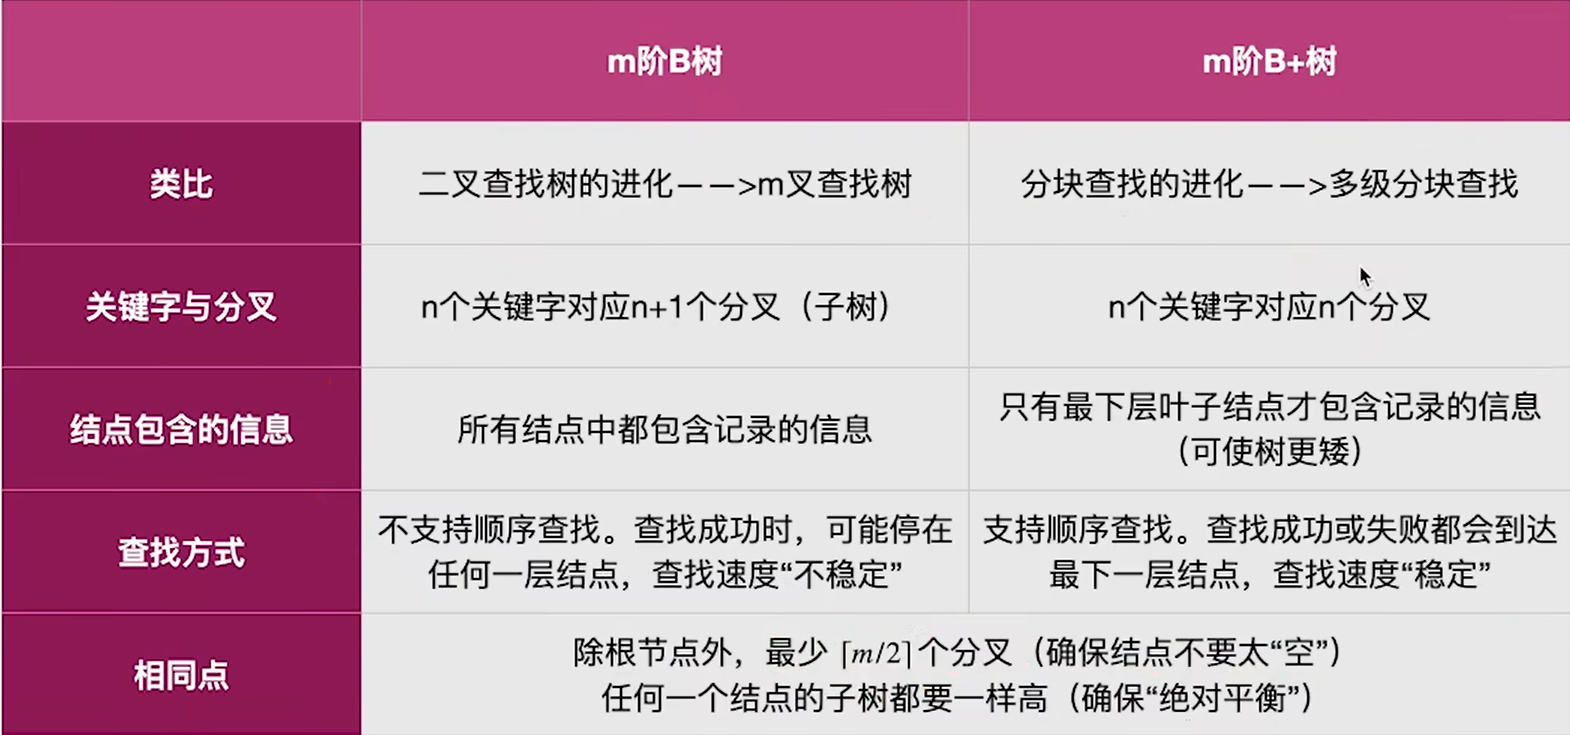
7.3.3B+树
7.4散列查找
1、定义
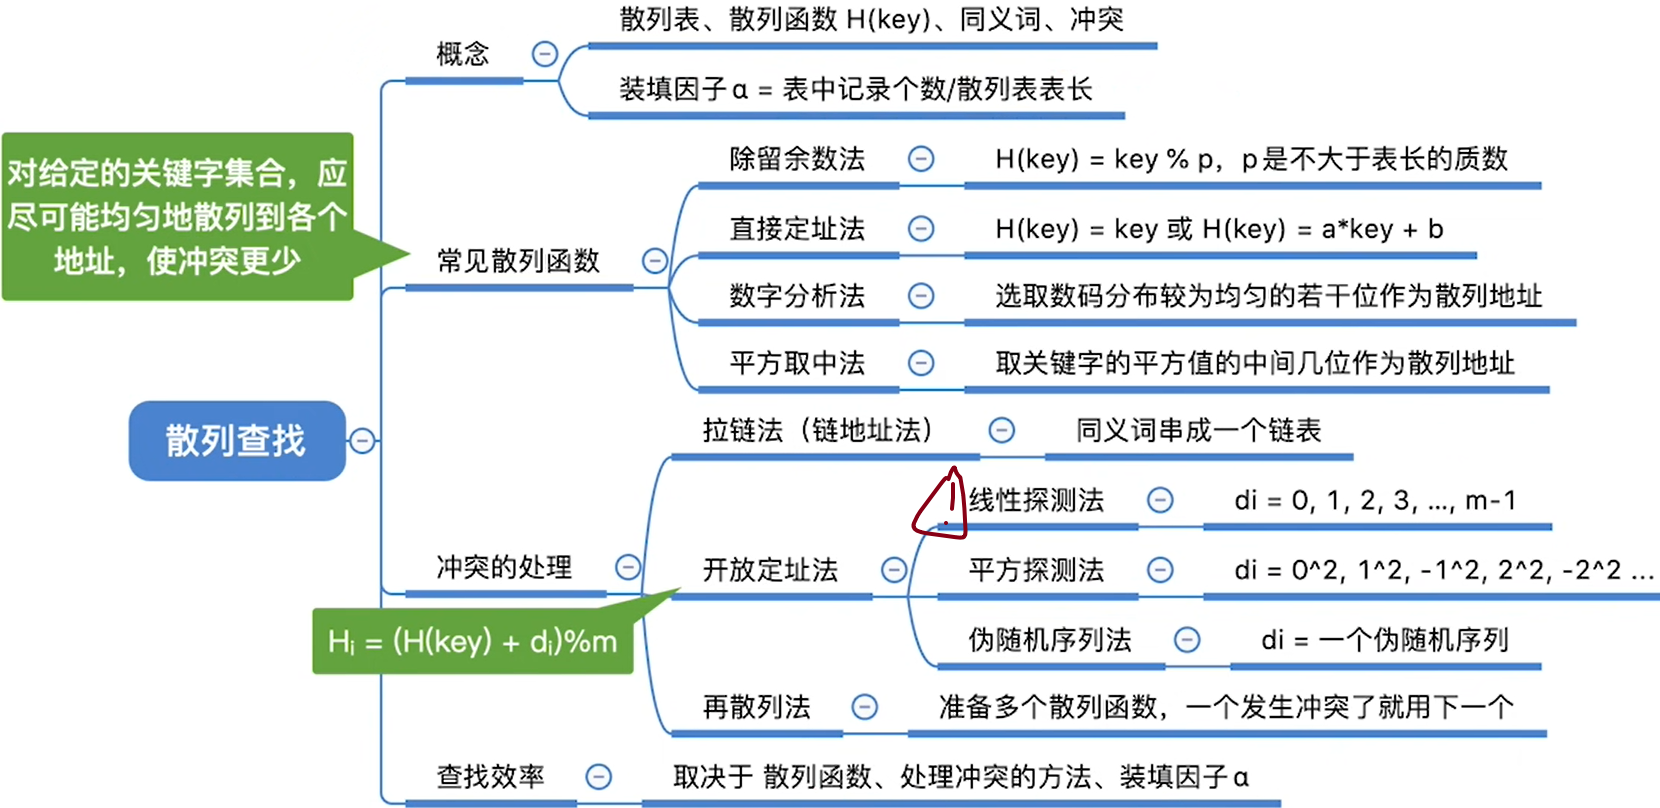
散列表,又称哈希表,是一种数据结构,特点是:数据元素的关键字与其存储地址直接相关
装填因子α=表中记录数/散列表长度
2、常见的散列函数
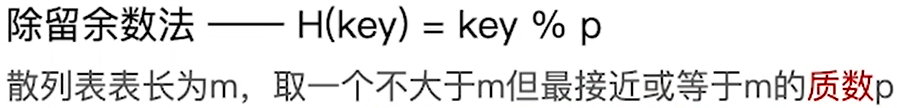
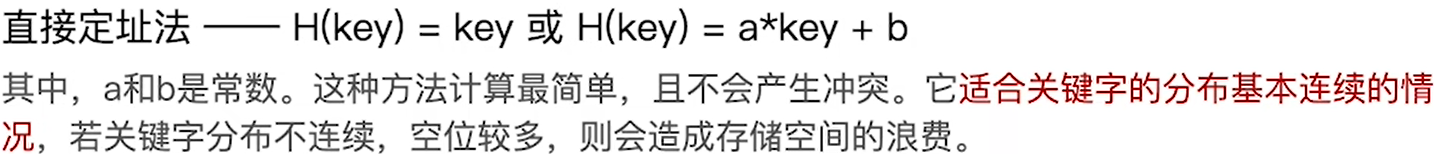
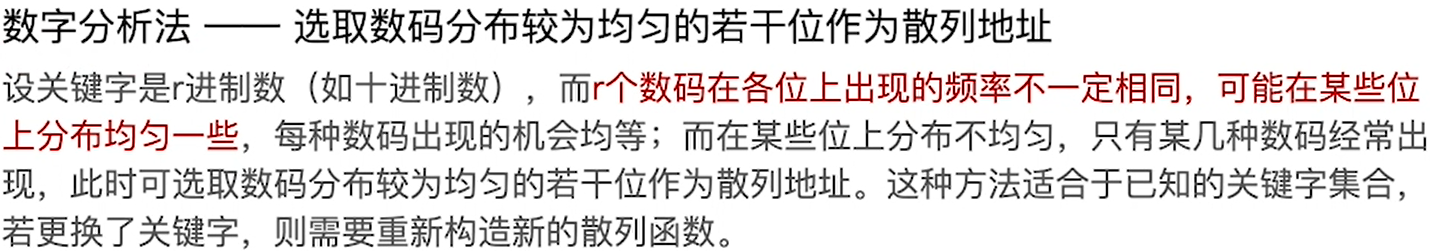
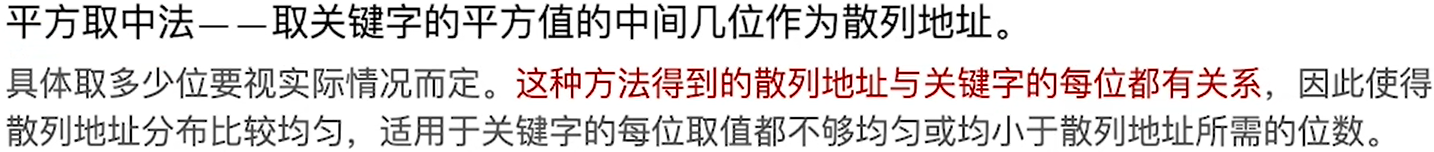
3、处理冲突的方法
3.1、拉链法
把所以“同义词”存储在一个链表中
3.2、开放地址法
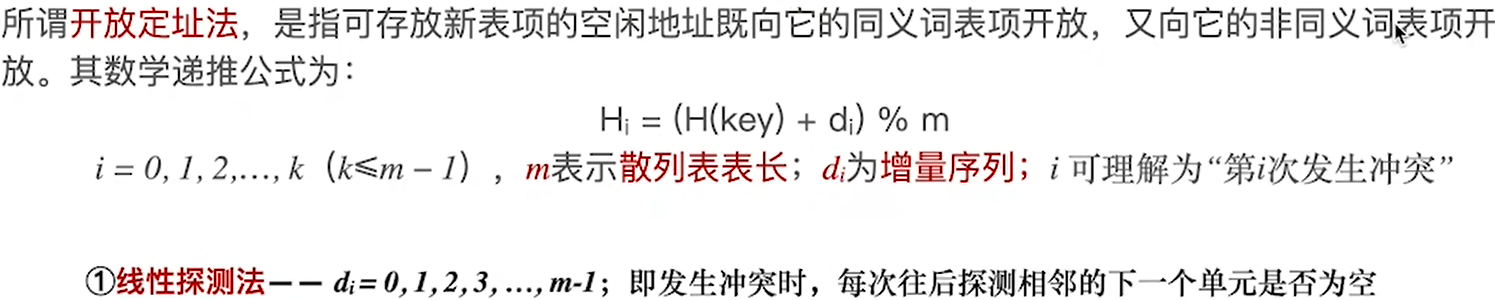
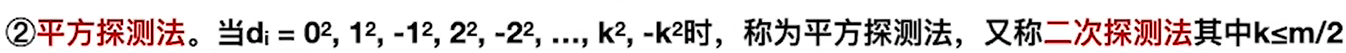

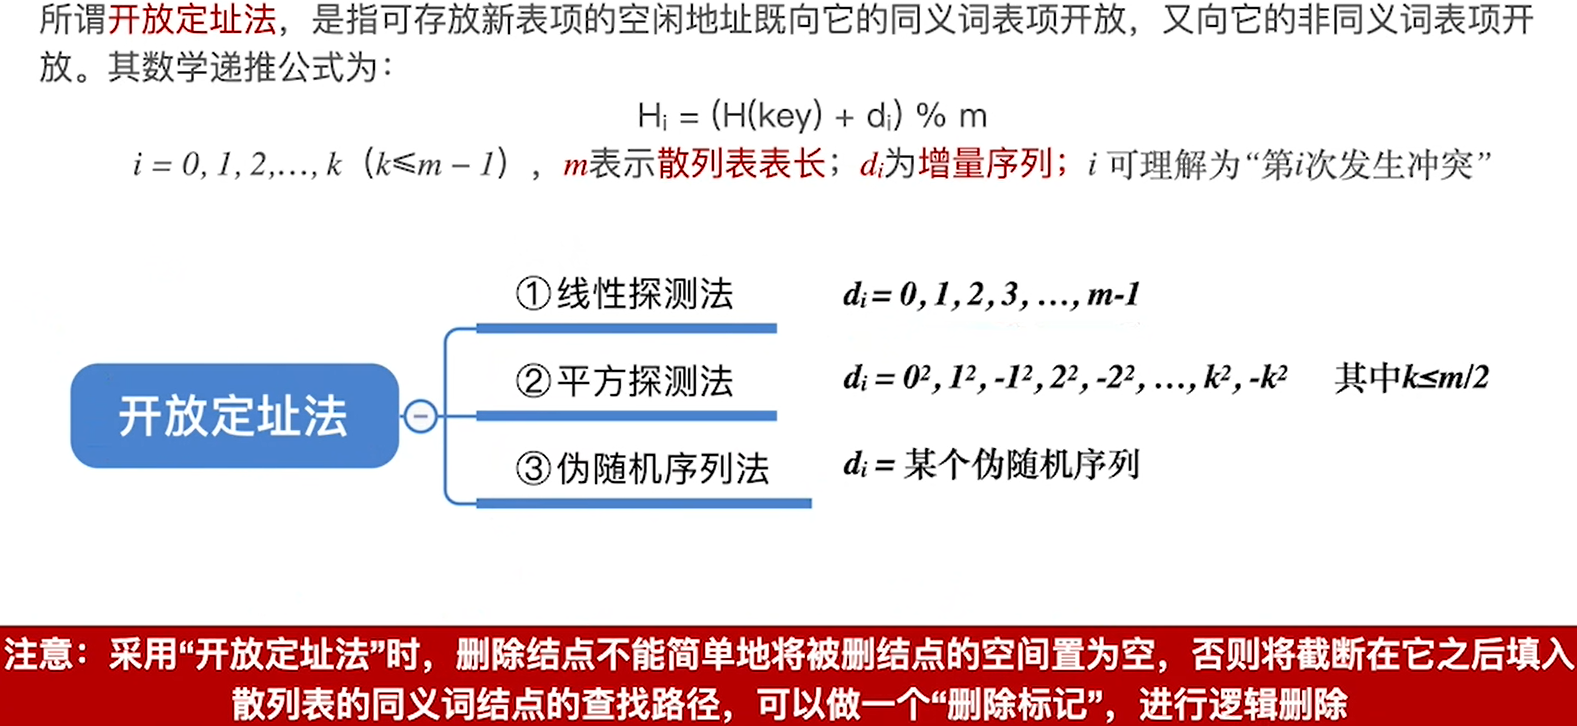
4、知识回顾
第八章 排序
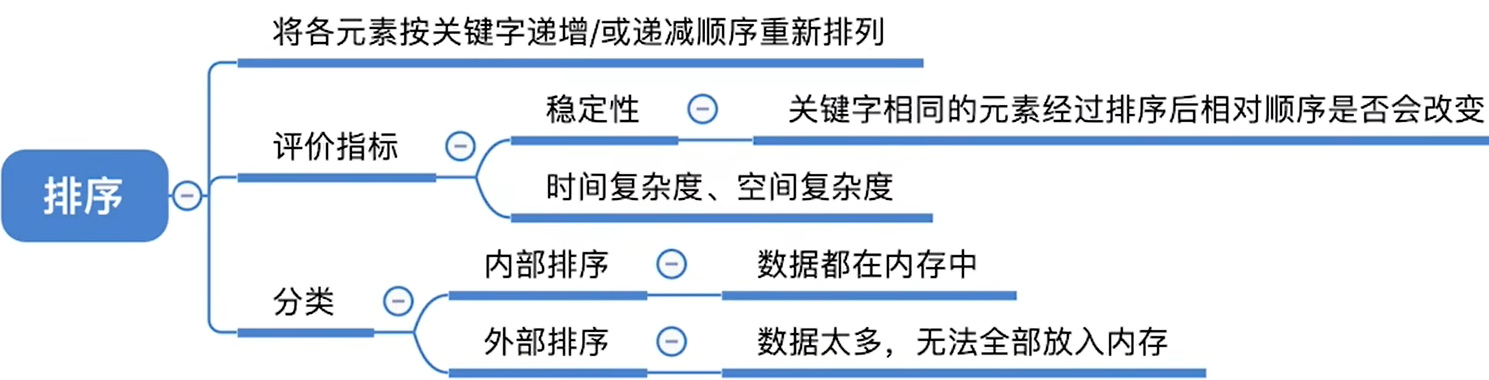
8.1排序的基本概念
8.2插入排序
8.2.1插入排序
1、算法思想

2、算法实现
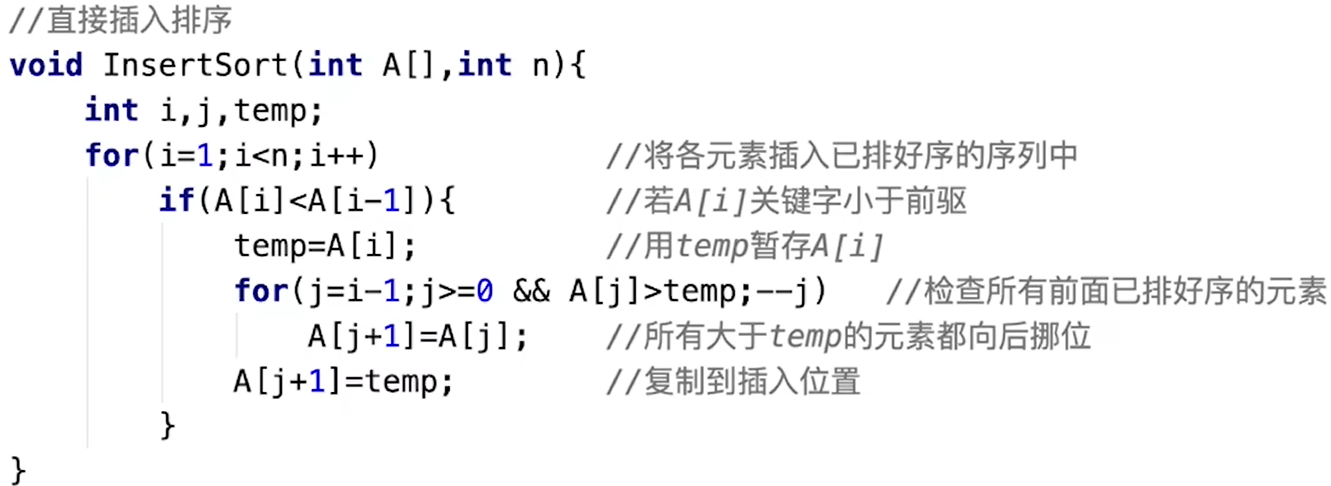
3、算法效率分析
最好——O(n)
最坏——O(n^2)
4、折半插入排序
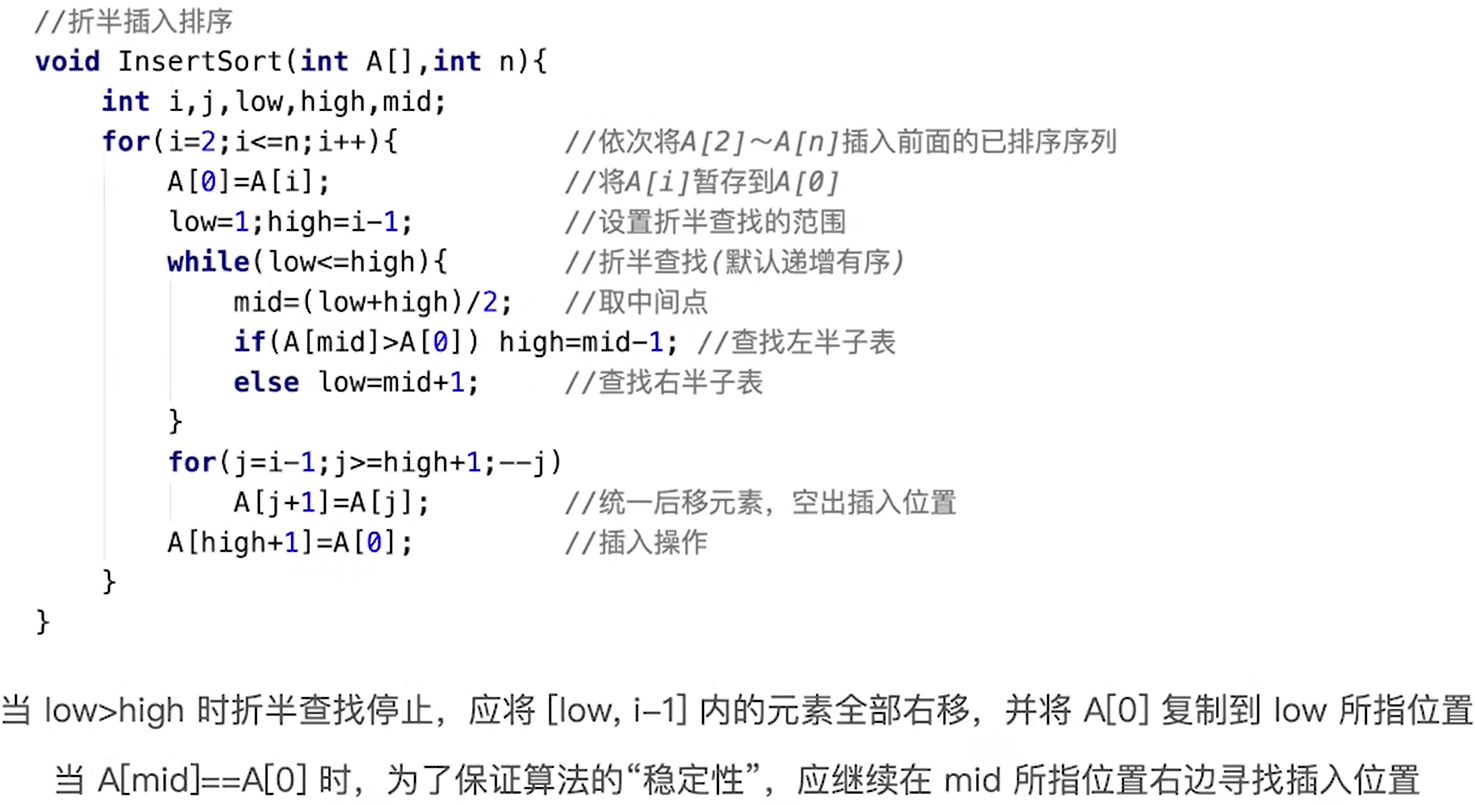
5、知识回顾
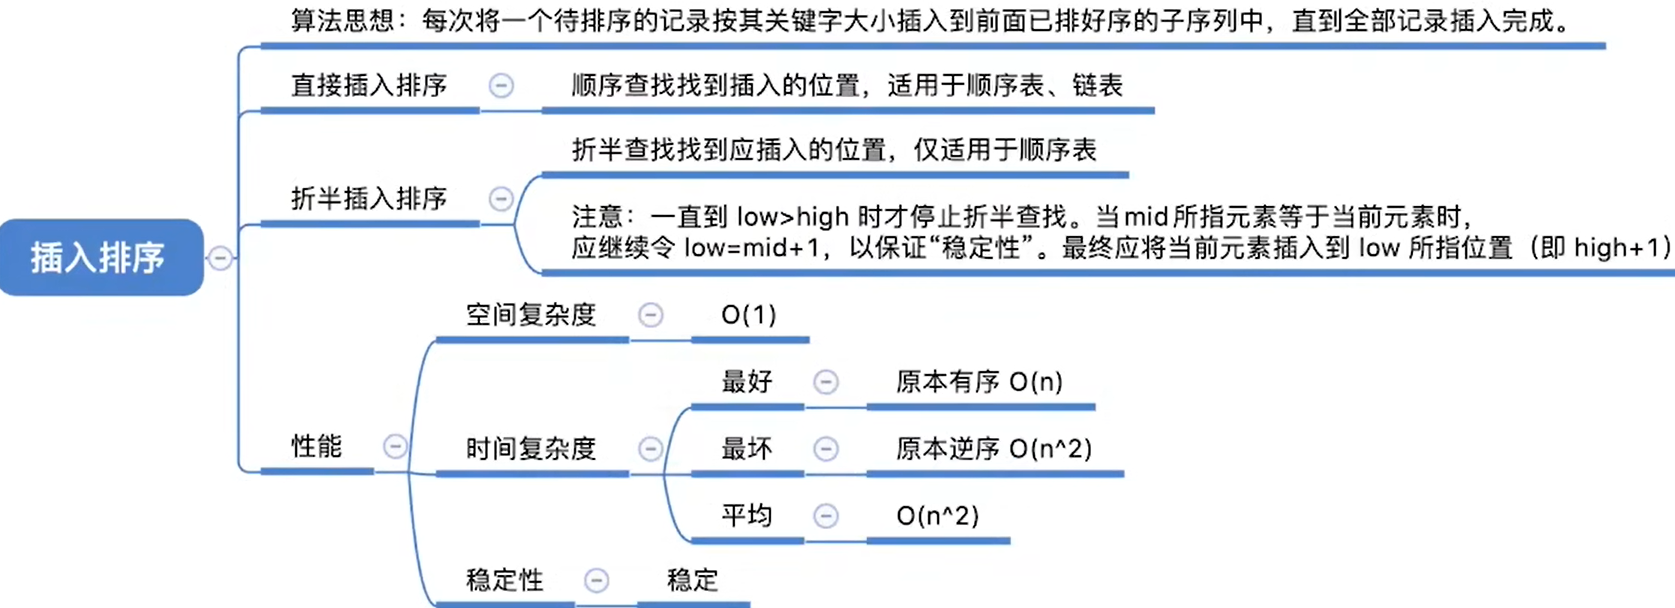
8.2.2希尔排序
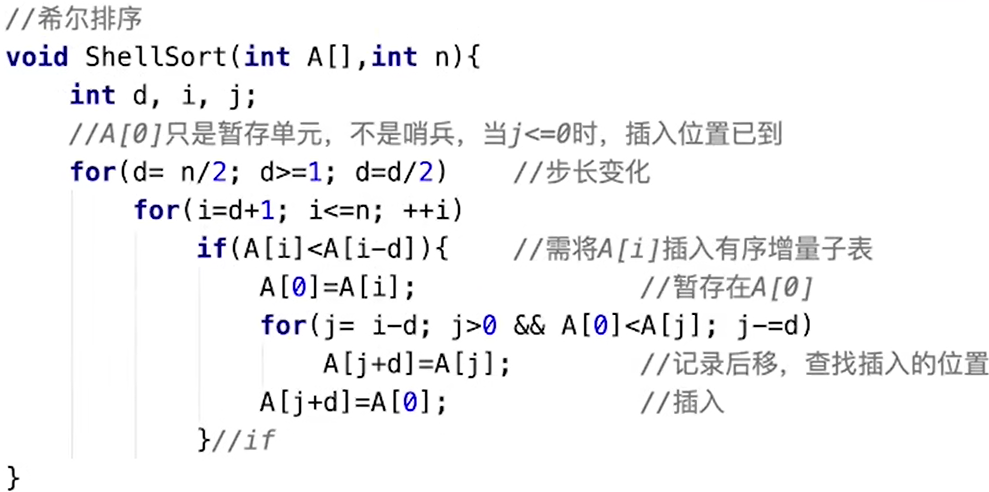
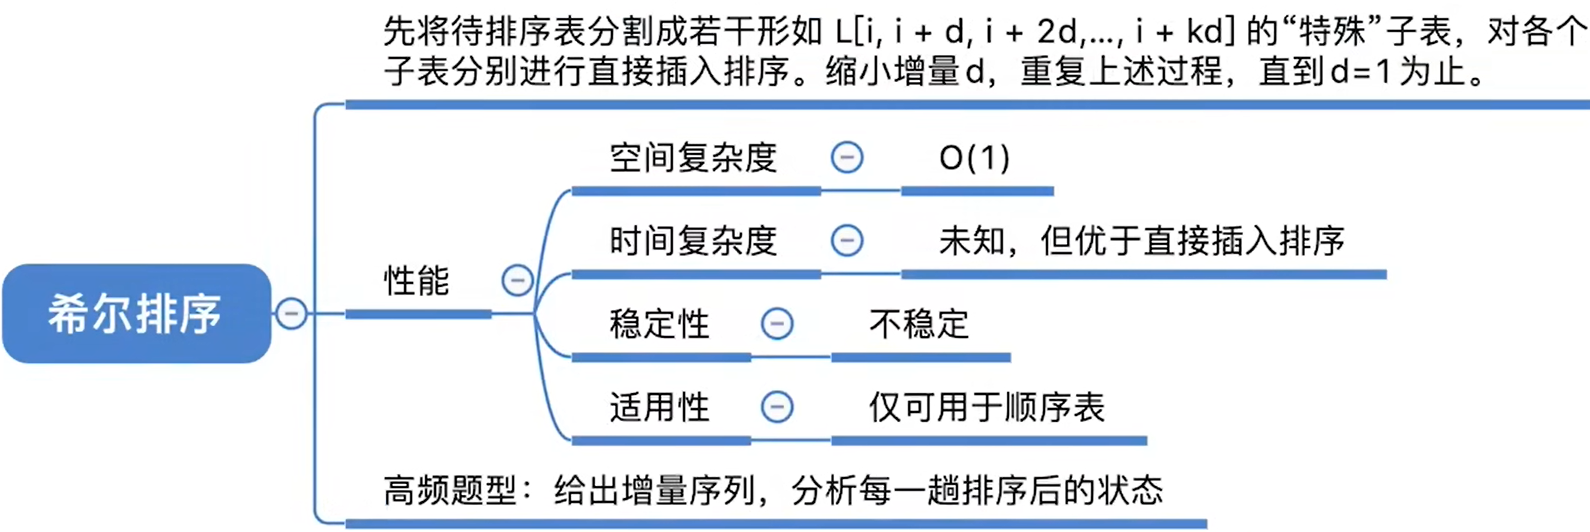
1、算法思想
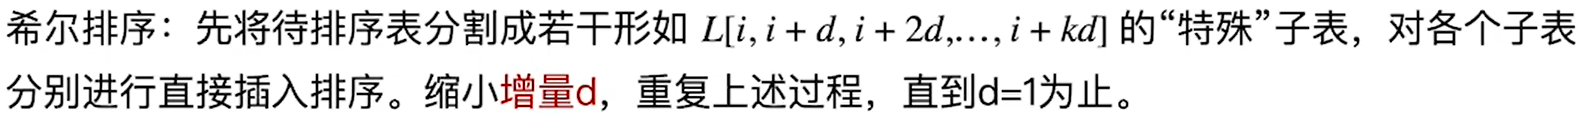
2、代码实现
3、算法效率分析

4、知识回顾
8.3交换排序
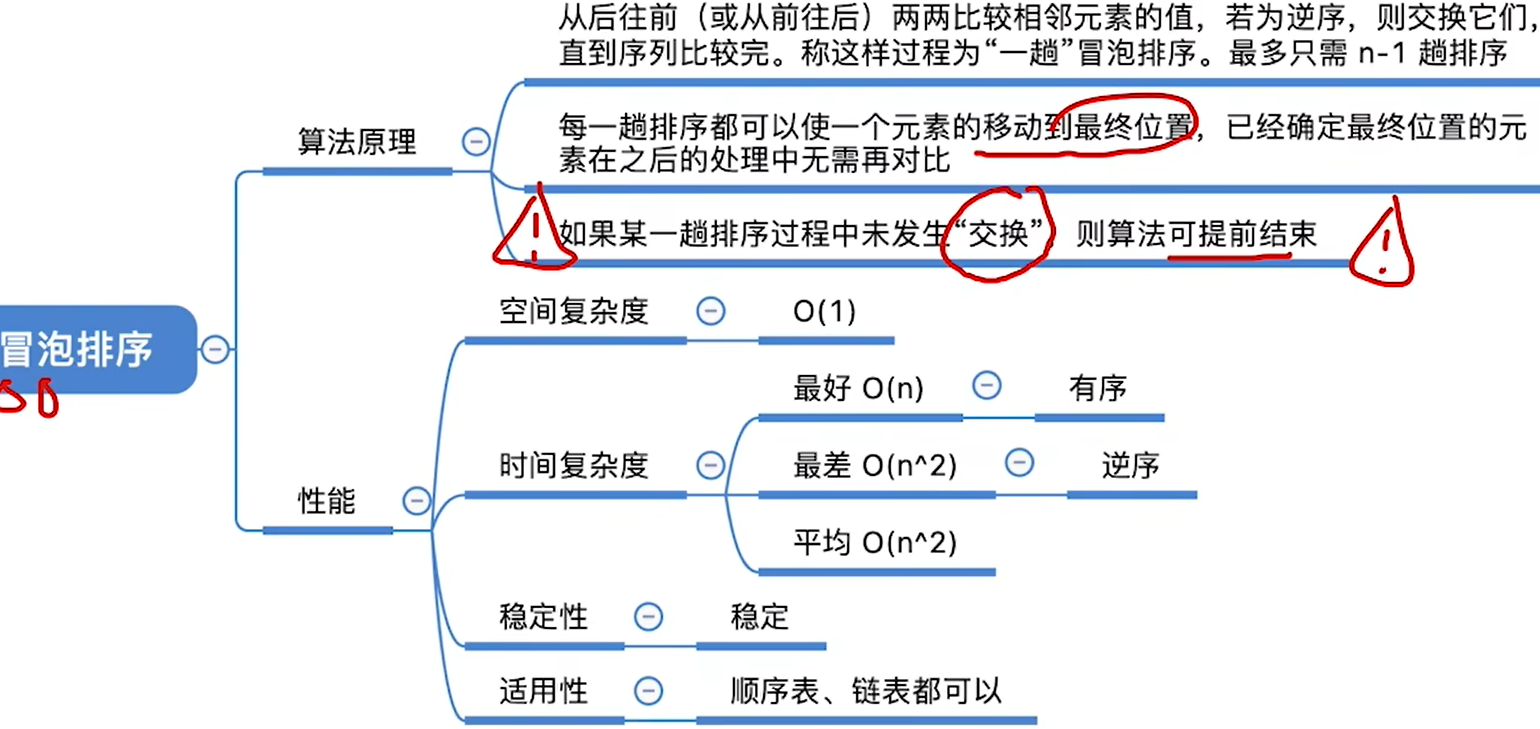
8.3.1冒泡排序
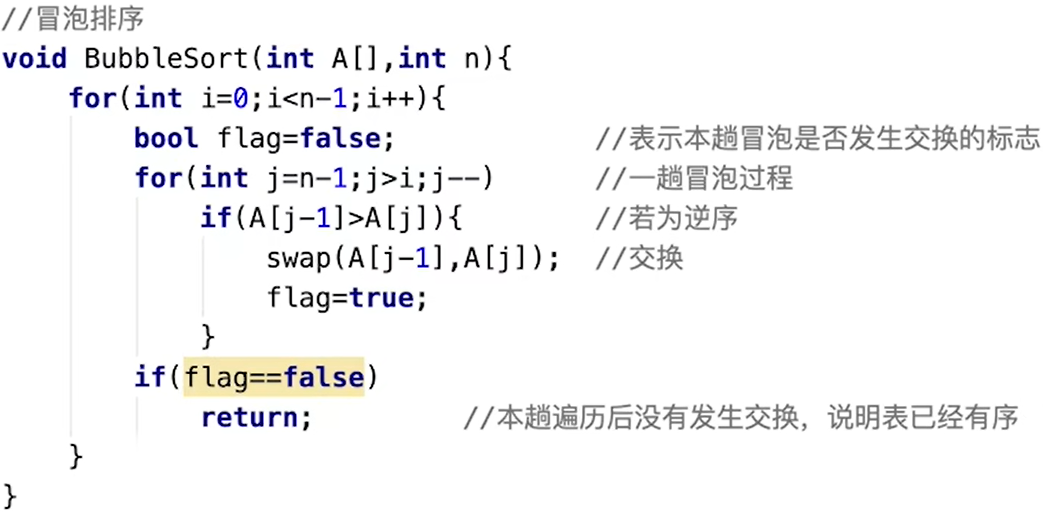
1、算法思想

2、代码实现
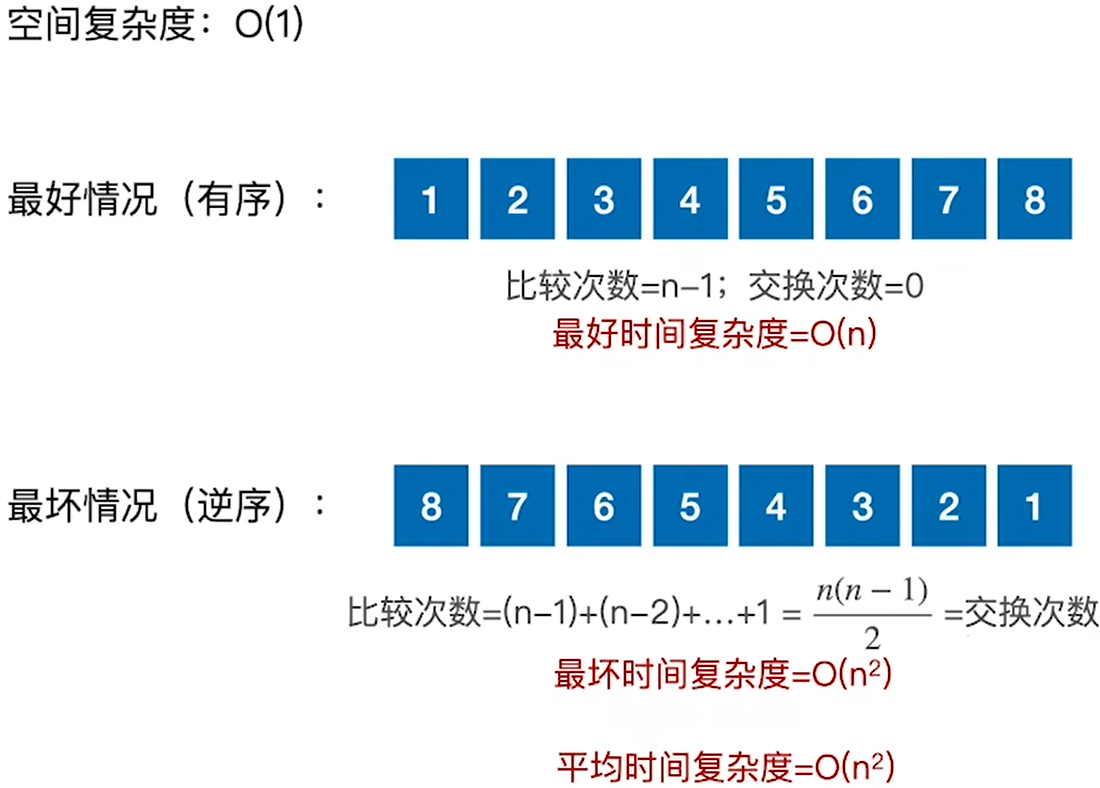
3、算法效率分析
4、知识回顾
8.3.2快速排序★
1、算法思想
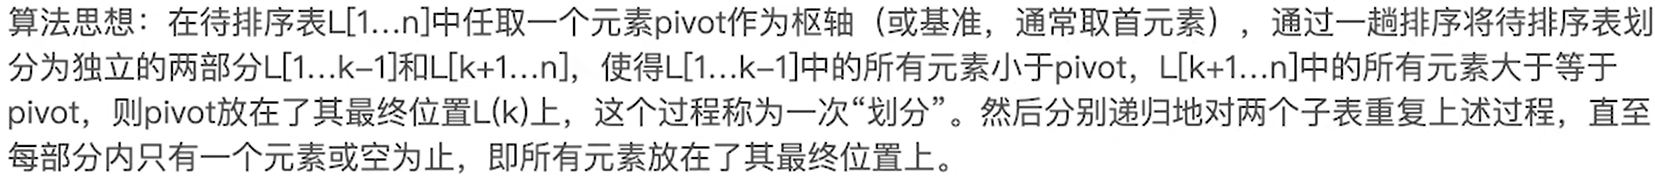
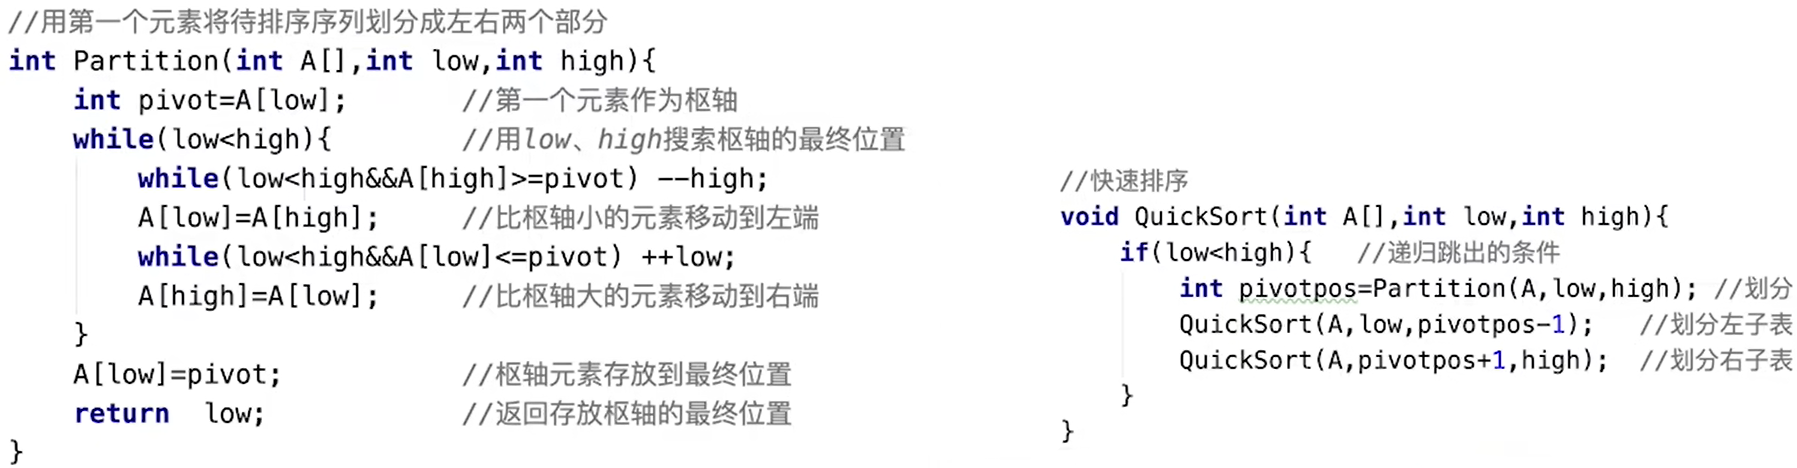
2、代码实现
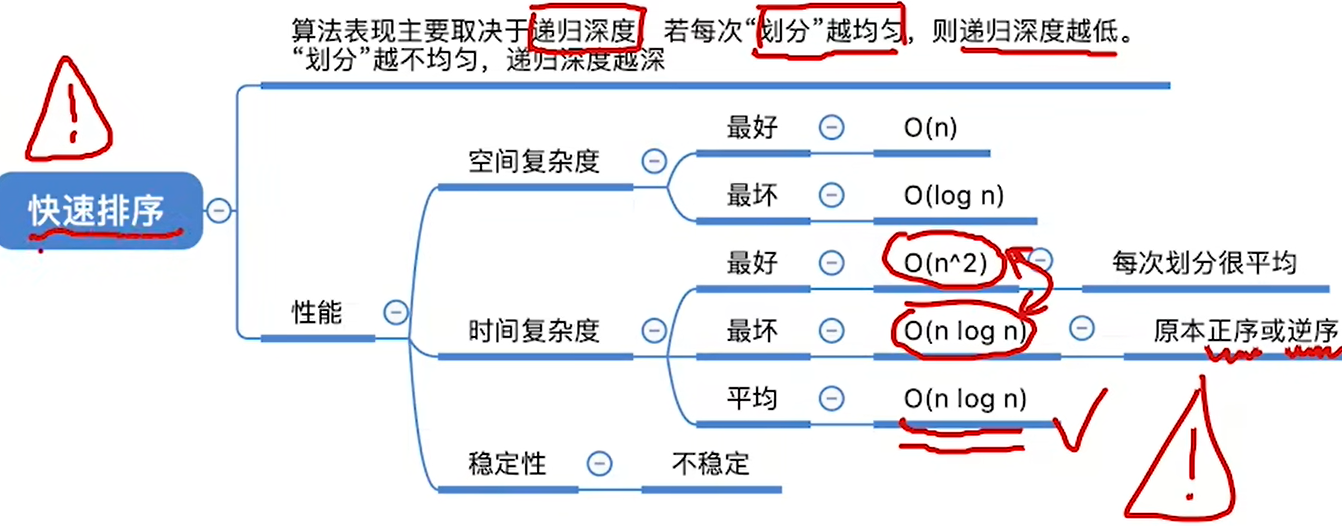
3、算法效率分析
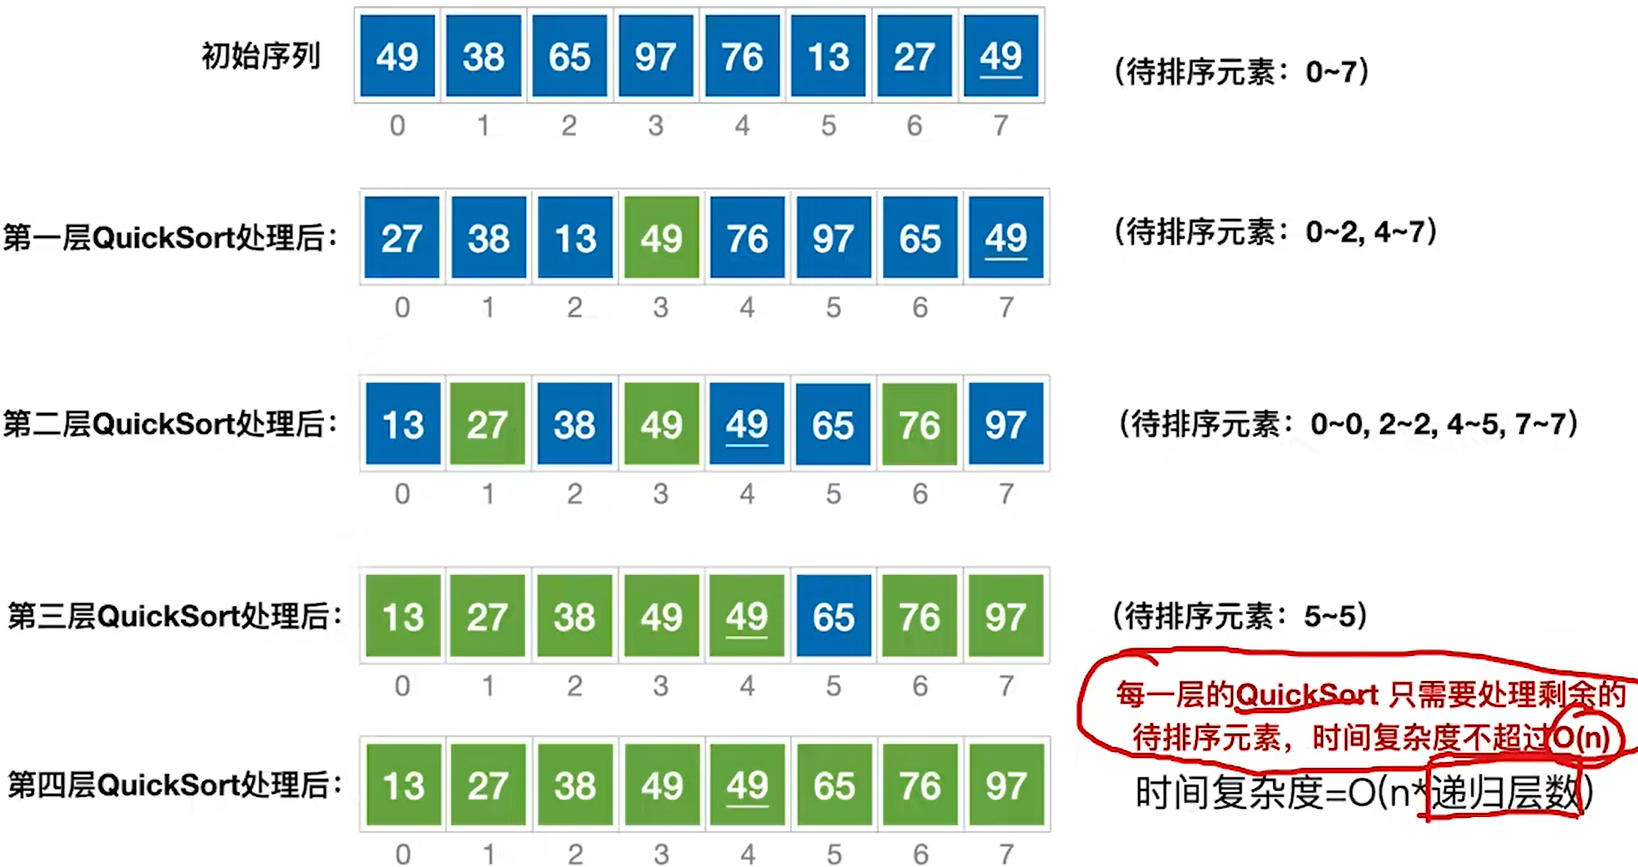
空间复杂度=O(递归层数)
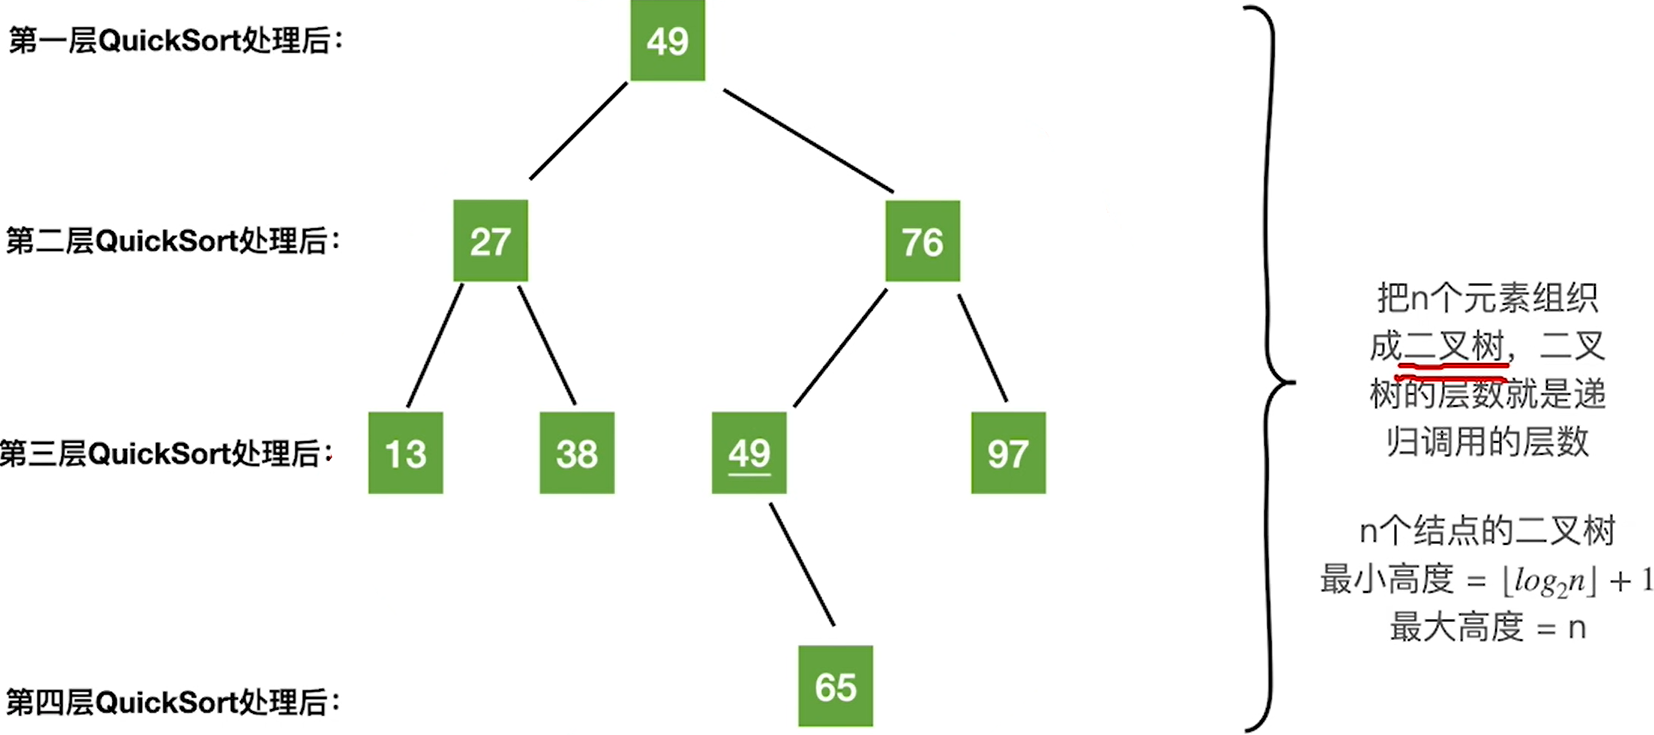
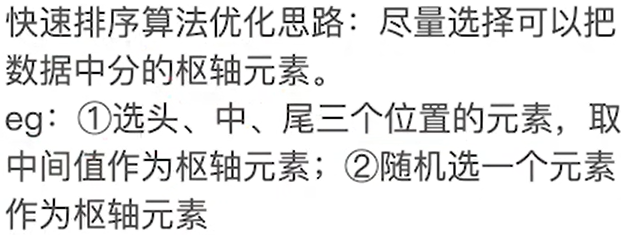
4、知识回顾
8.4选择排序
8.4.1简单选择排序
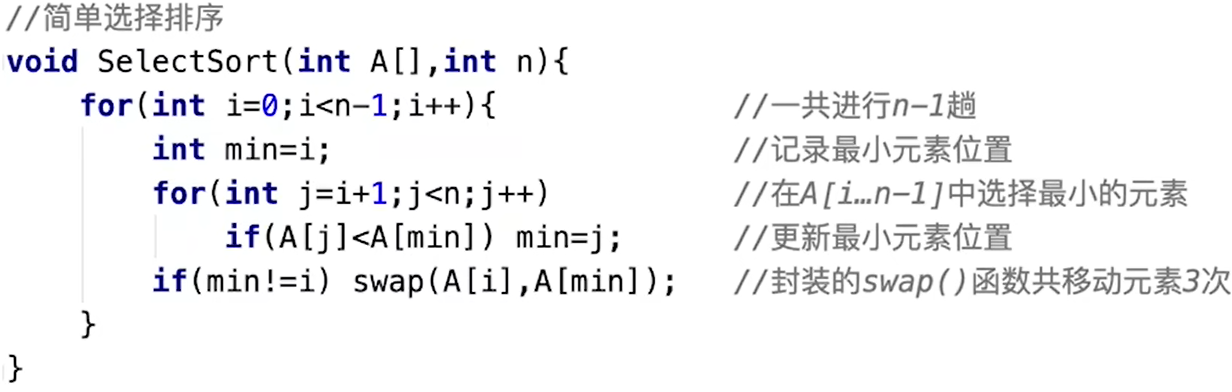
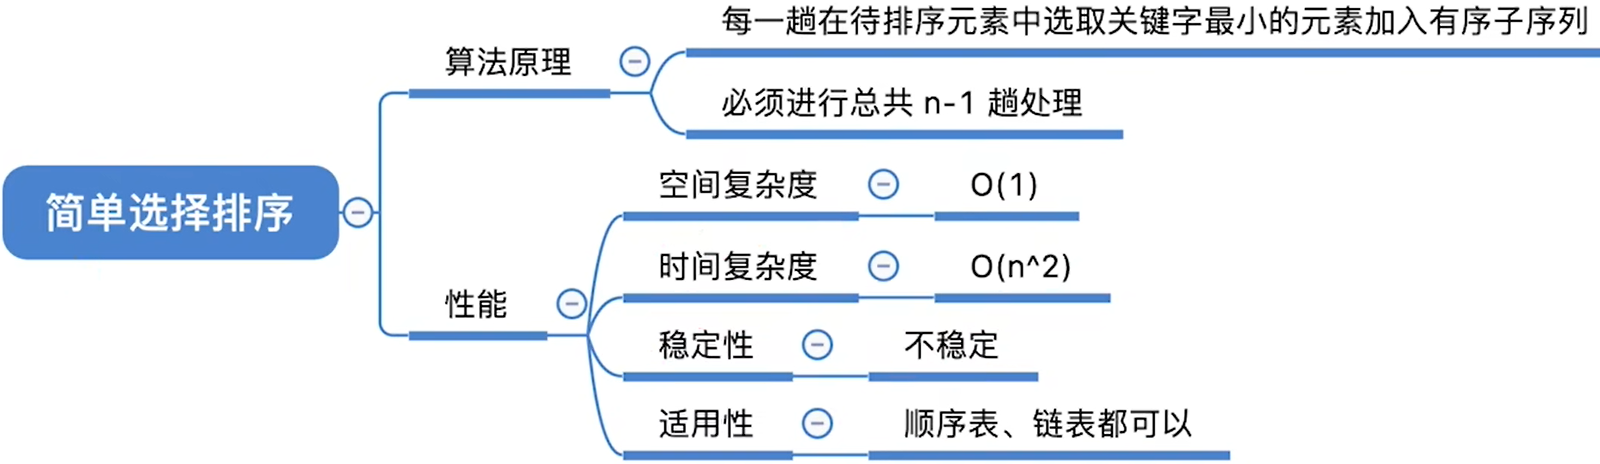
1、算法思想
选择排序:每一趟在待排序元素中选取关键字最小(或最大)的元素加入有序子序列
2、代码实现
3、知识回顾
8.4.2堆排序
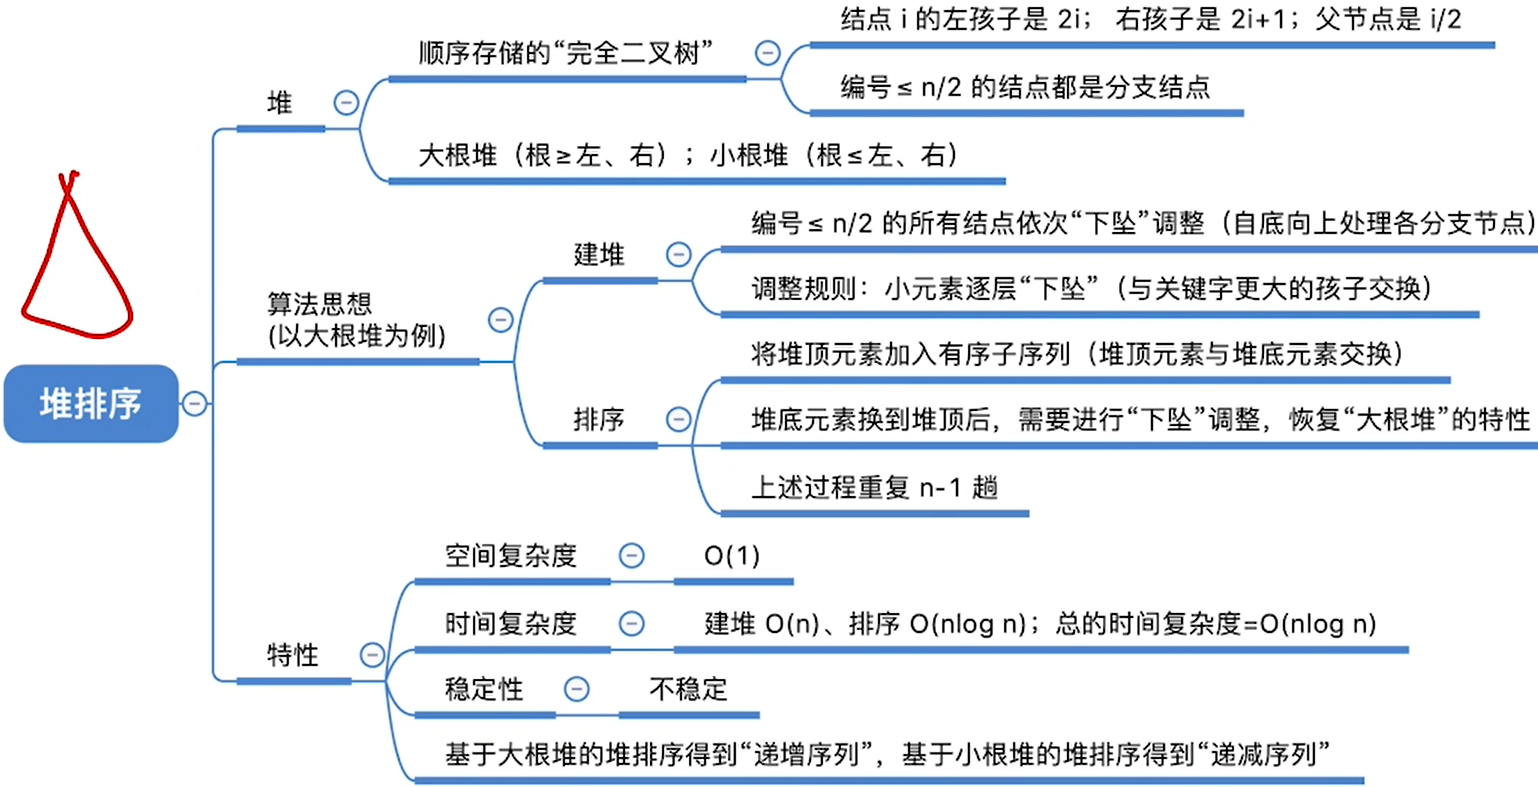
1、算法思想
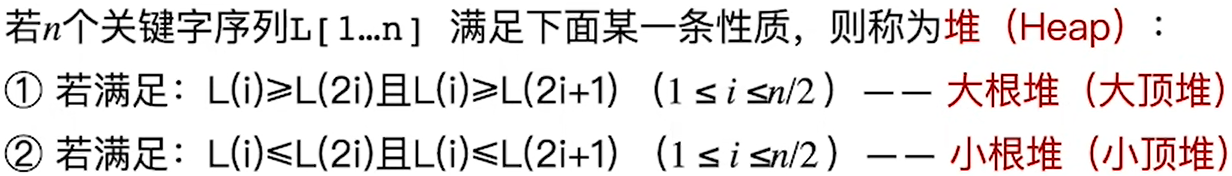
根≥(或≤)左右孩子称为大(或小)根堆
建立大根堆
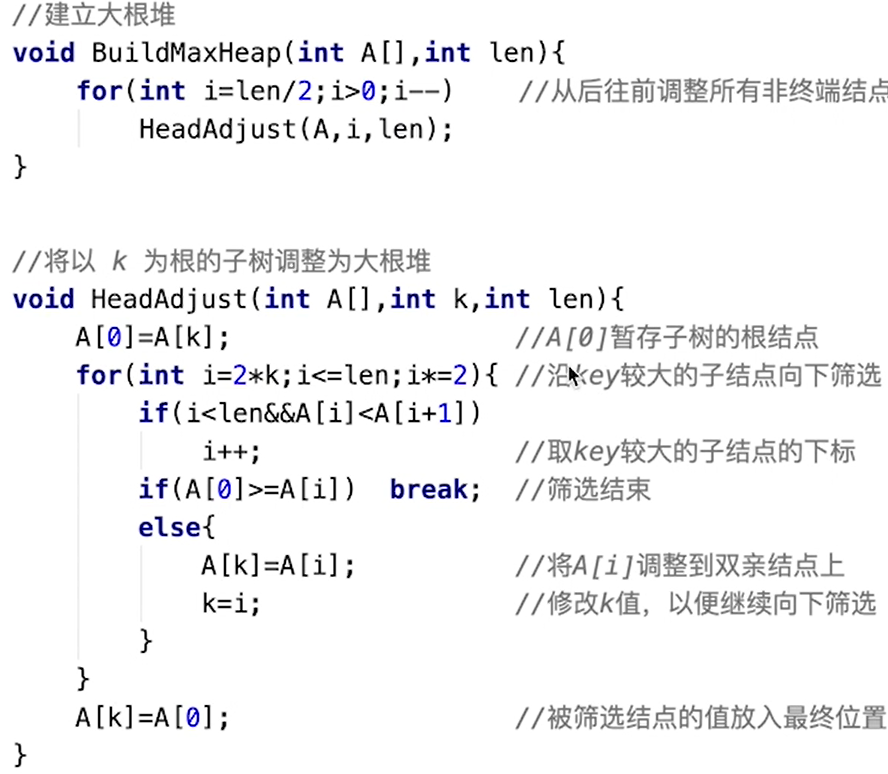
思路:把所有非终端结点都检查一遍,是否满足大根堆的要求,如果不满足,则进行调整。检查当前结点是否满足根≥左、右,若不满足,将当前结点与更大的一-个孩子互换。若元素互换破坏了下一级的堆,则采用相同的方法继续往下调整(小元素不断“下坠”)
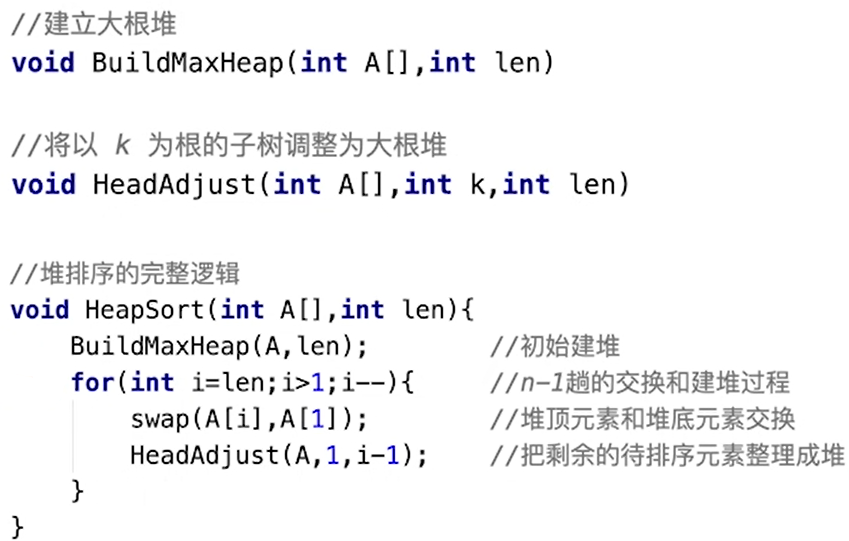
堆排序:每一趟将堆顶元素加入有序子序列(与待排序序列中的最后一个元素交换)并将待排序元素序列再次调整为大根堆
2、代码实现
3、知识回顾
8.4.3堆的插入删除
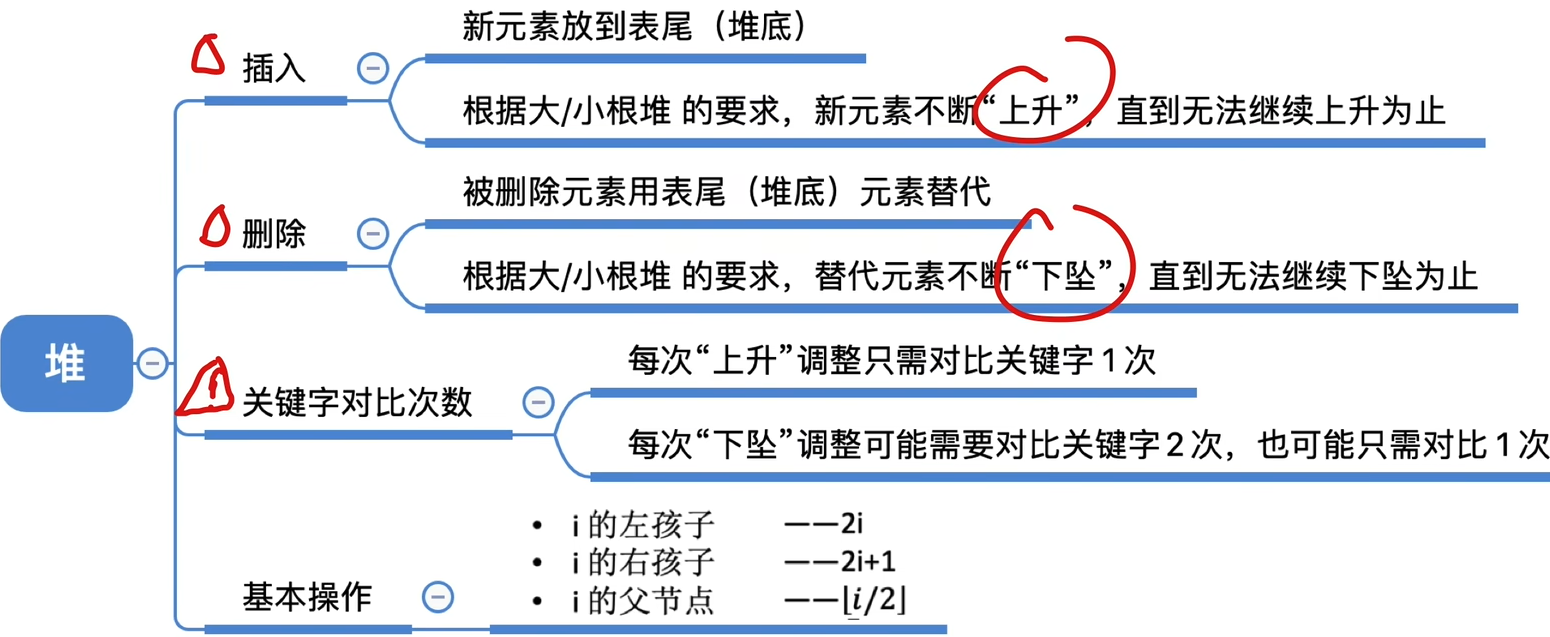
1、插入删除
1.1、插入
对于小根堆,新元素放到表尾,与父节点对比,若新元素比父节点更小,则将二者互换。新元素就这样一路“ 上升”,直到无法继续上升为止
1.2、删除
被删除的元素用堆底元素替代,然后让该元素不断“下坠”,直到无法下坠为止
2、知识回顾
8.5归并排序和基数排序
8.5.1归并排序
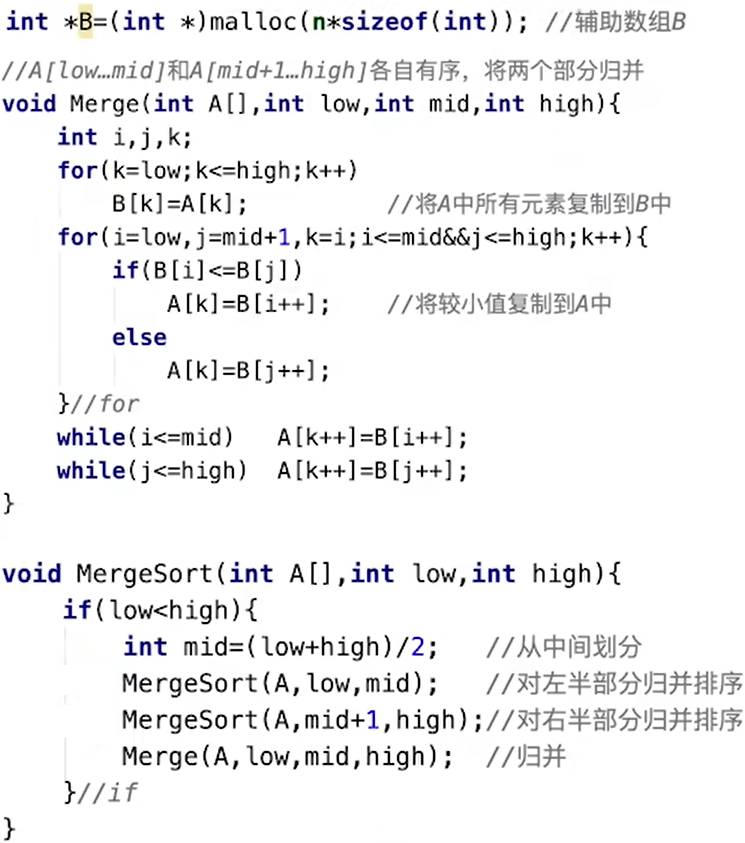
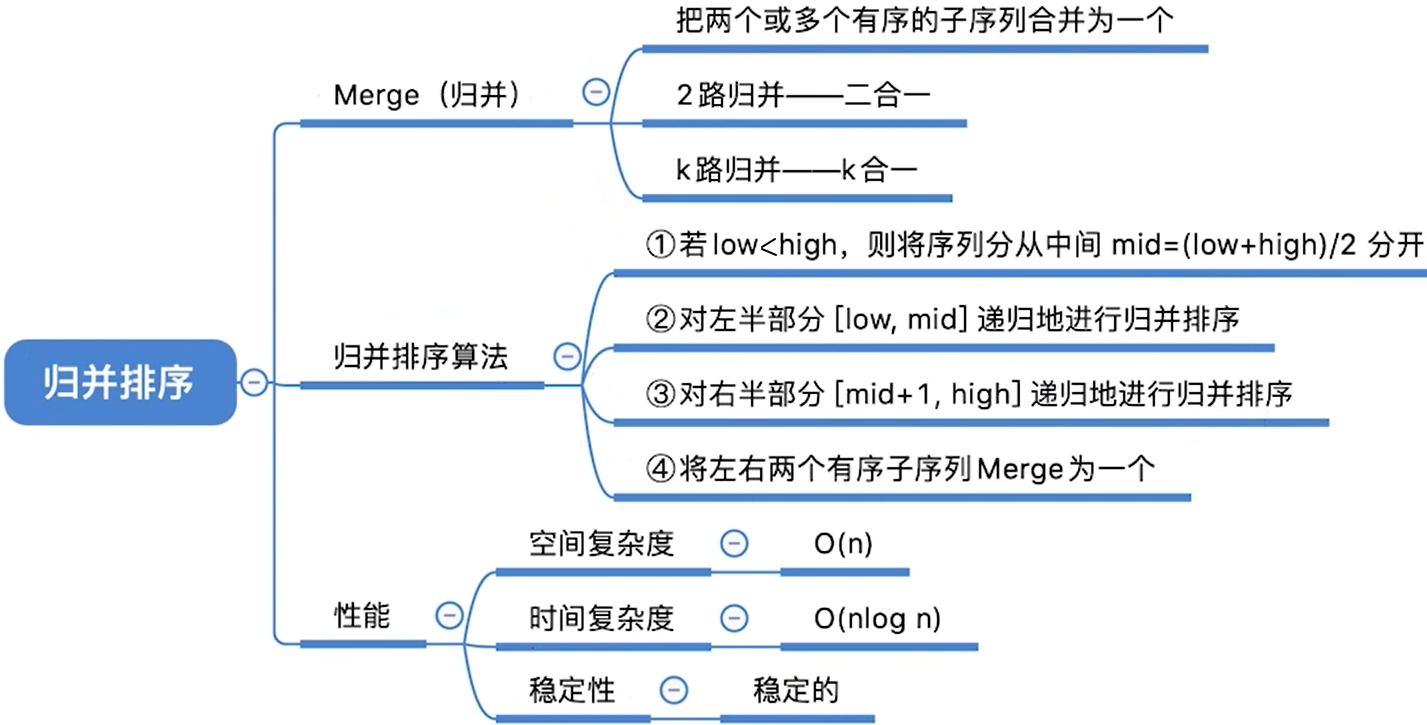
1、代码实现
2、知识回顾
8.5.2基数排序(手动模拟)
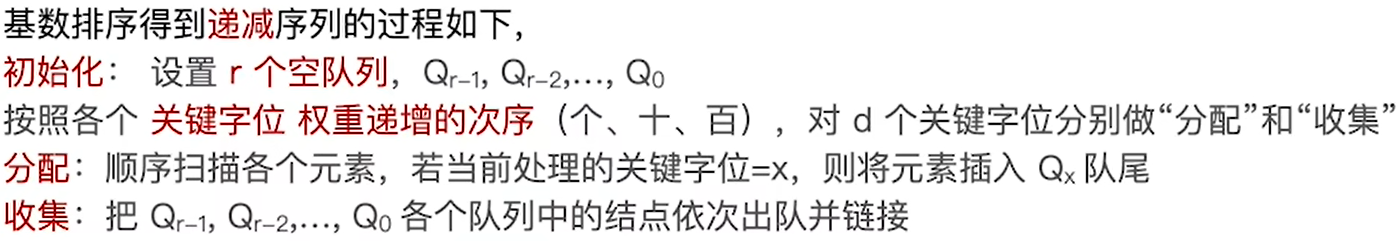
1、算法思想
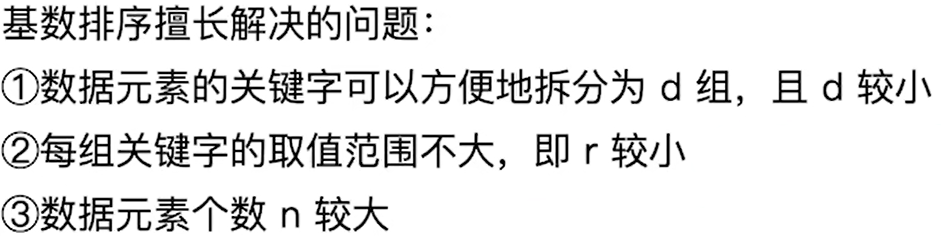
2、算法效率分析
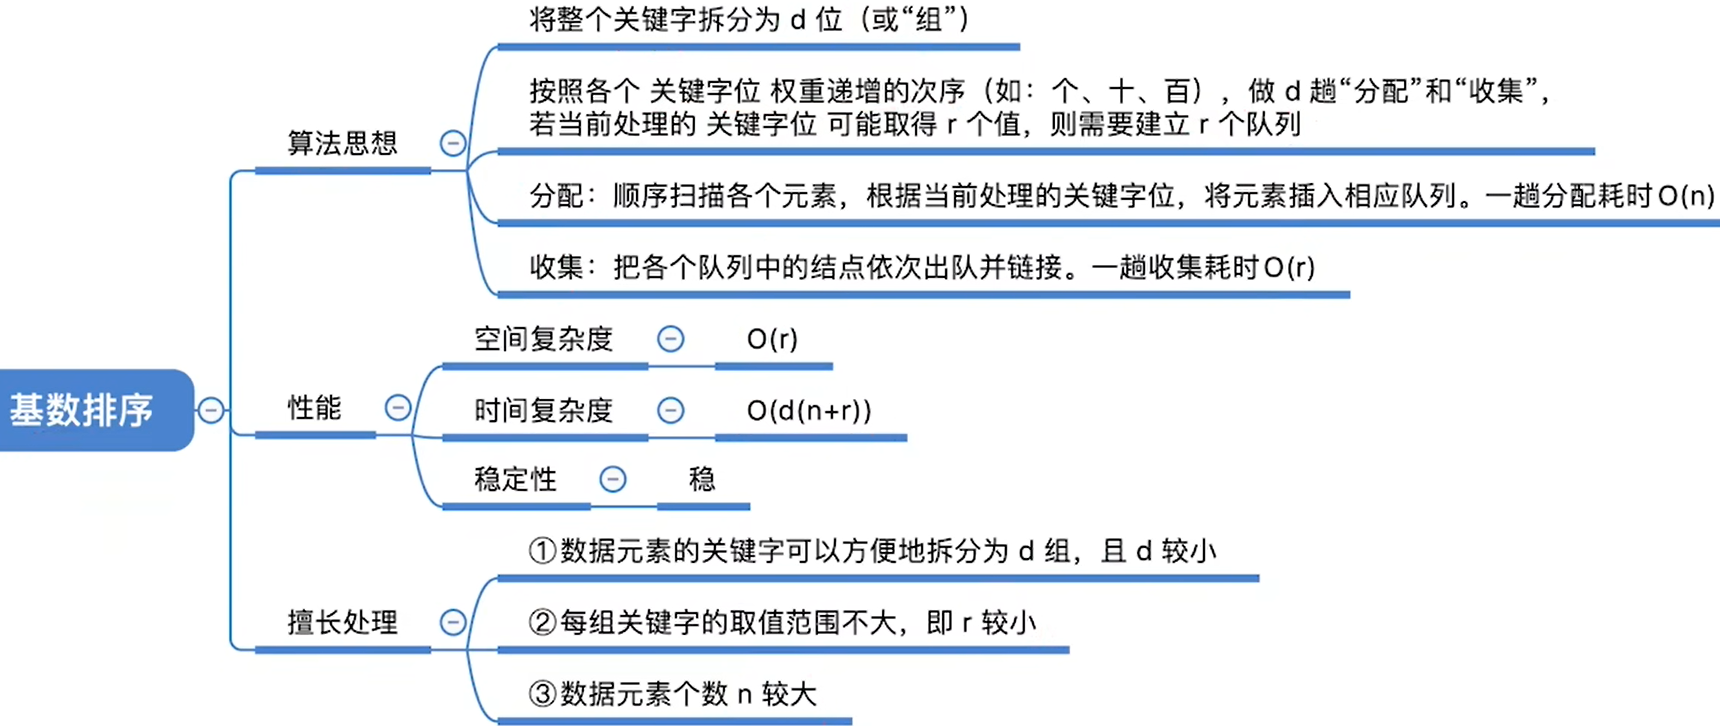
3、知识回顾
8.6外部排序
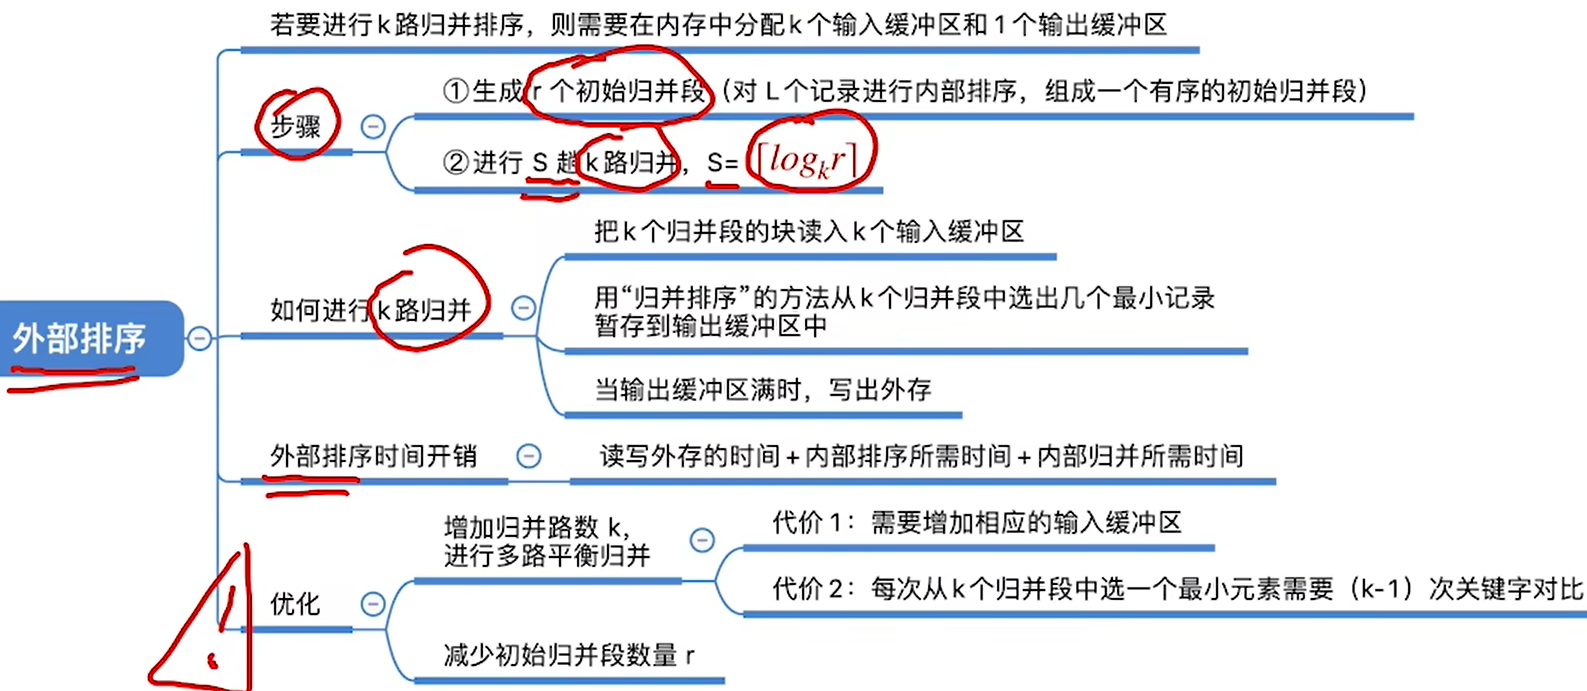
8.6.1外部排序
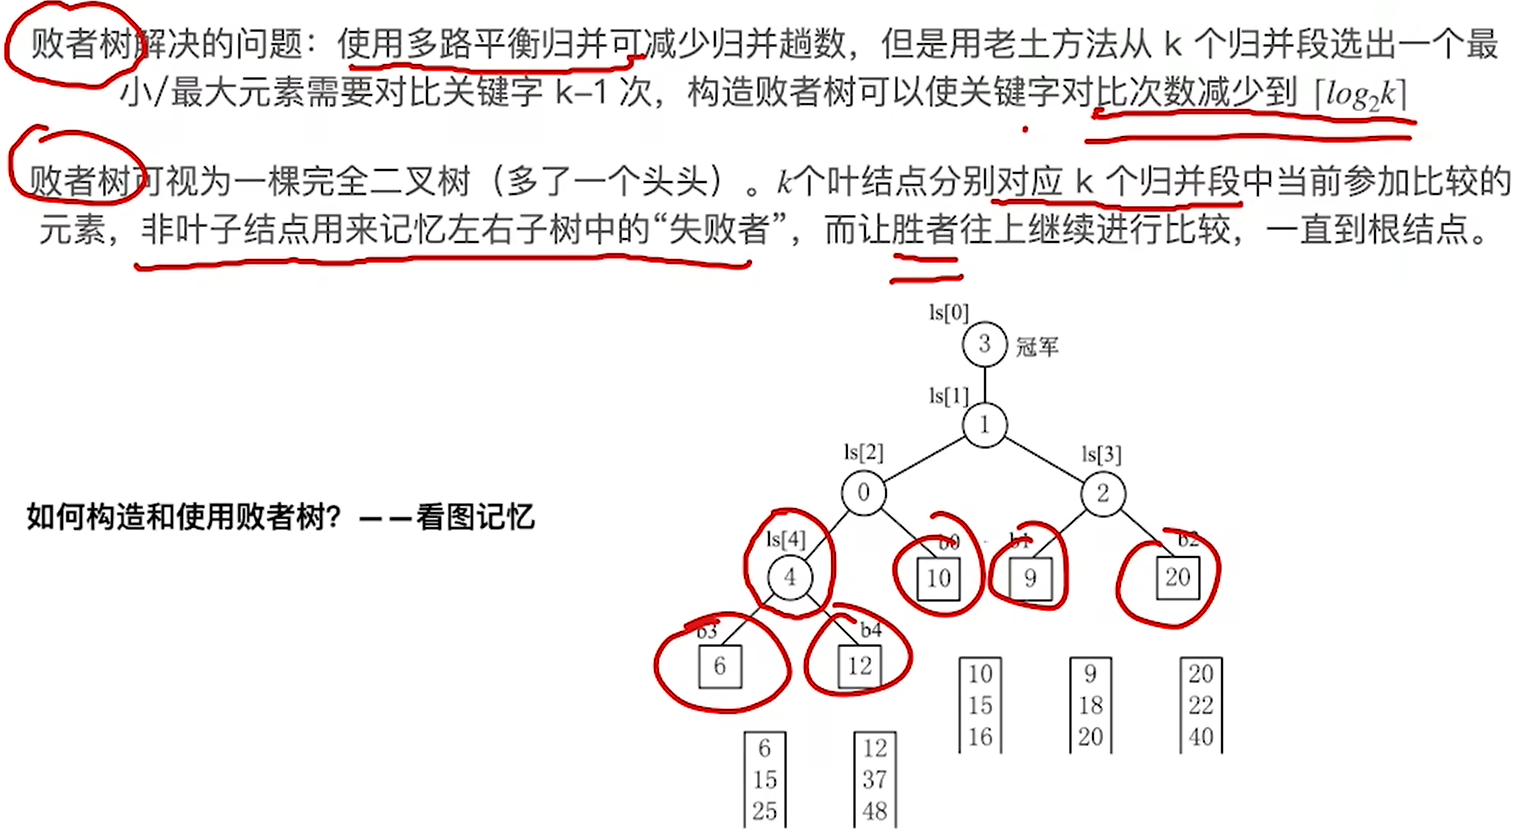
8.6.2败者树(手动模拟)
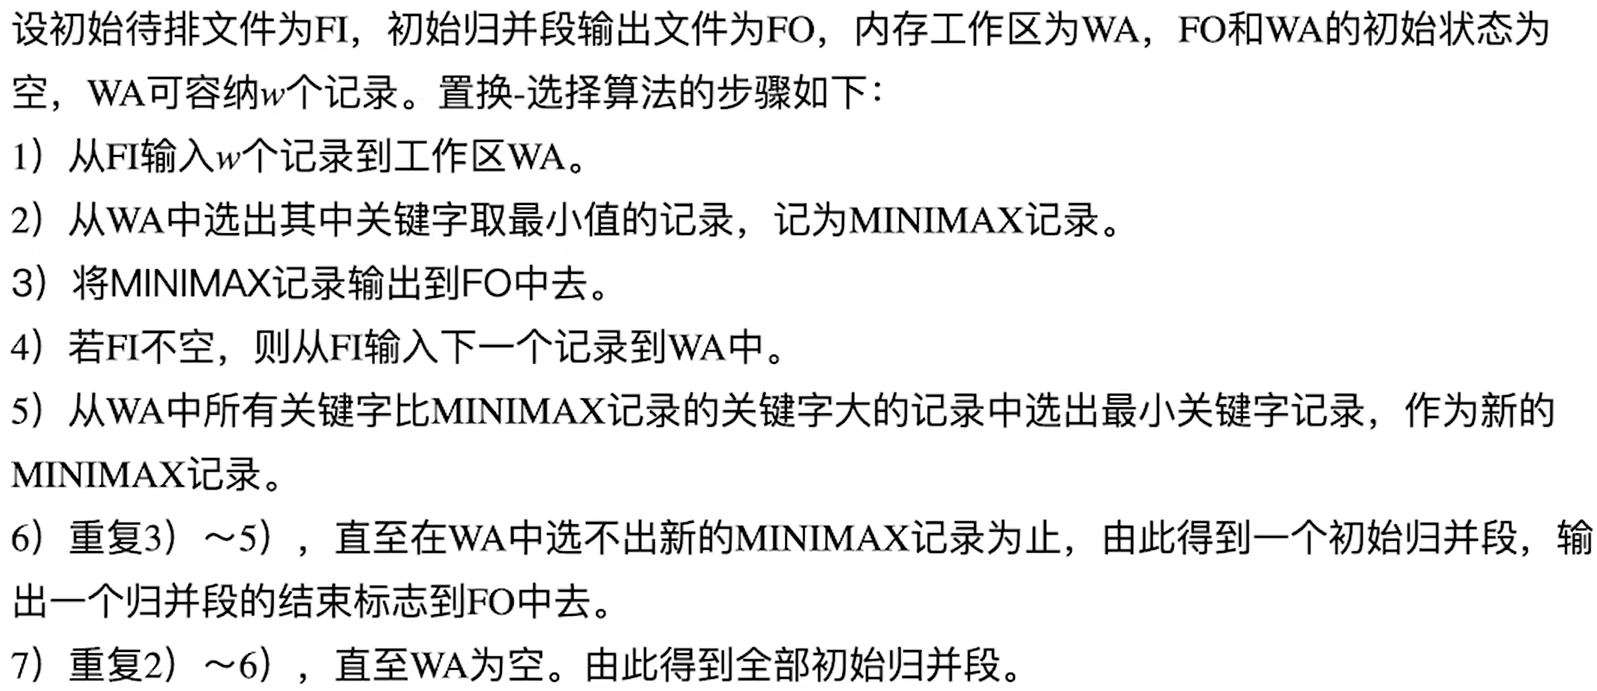
8.6.3置换-选择排序
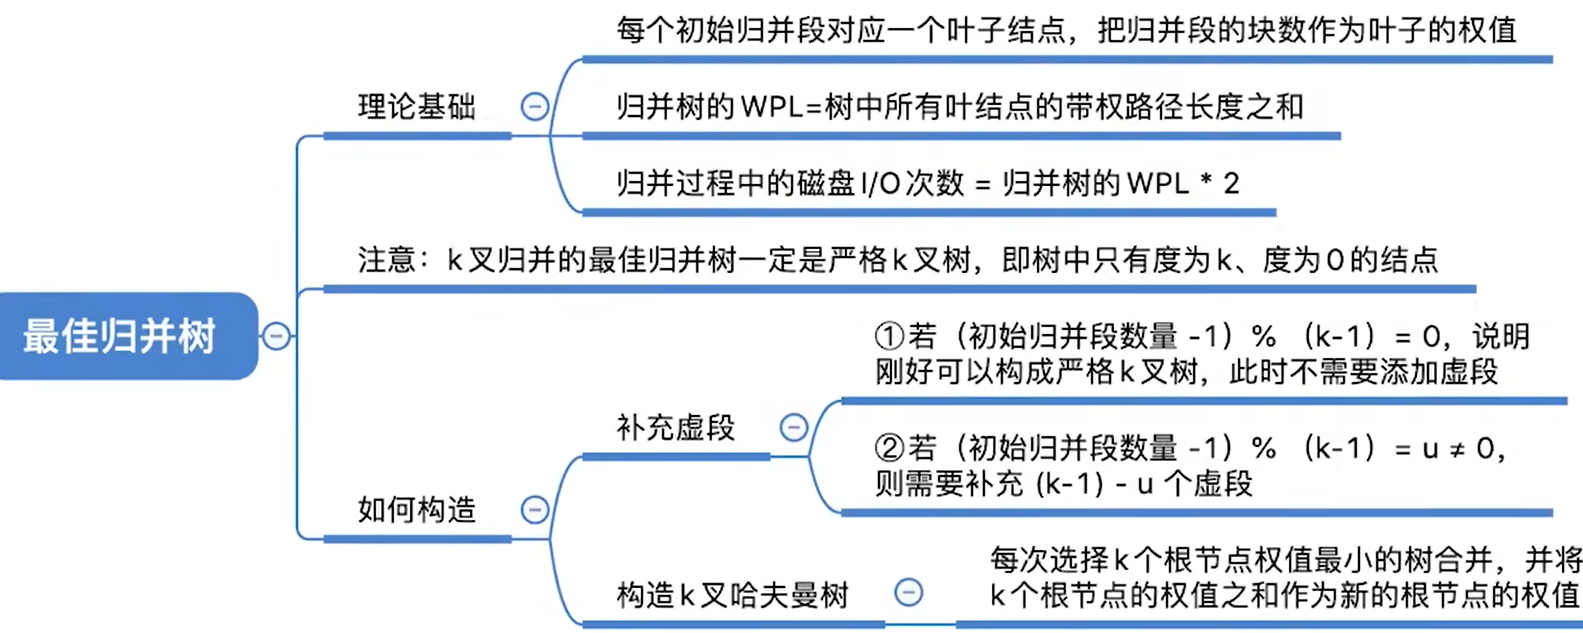
8.6.4最佳归并树