Data Structure - 题库
1 绪论
【计算机算法】
计算机算法是指 解决问题的步骤序列,它必须具备 可执行性、确定性、有穷性 这 3 个特性
【连续存储】
连续存储设计时,存储单元的地址 一定连续
【习题】

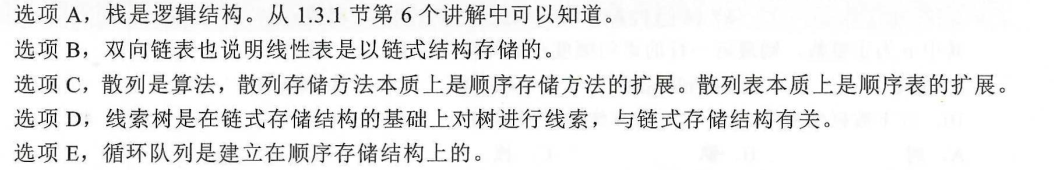
【解析】A
【习题】
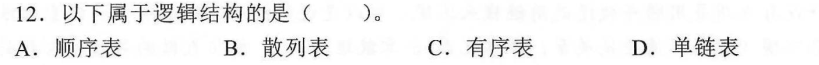
【解析】C,有序表指出了表中数据是根据一定逻辑结构顺序排列的,是一种逻辑结构
【习题】
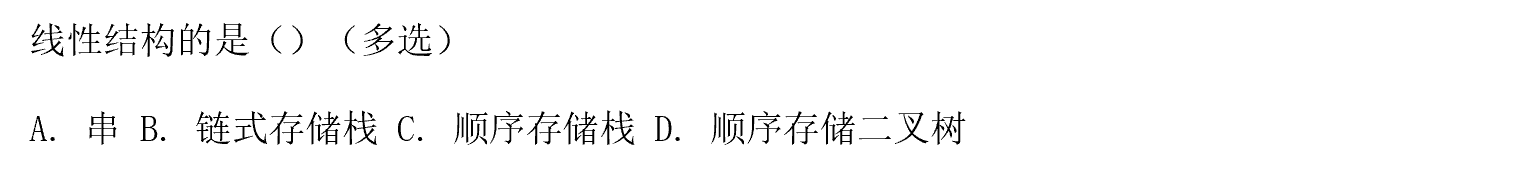
【解析】ABC
线性是逻辑结构,顺序是存储结构,两者不是一个概念,线性是指一个元素后继只有唯一的一个元素或节点,非线性是一个元素后面可以有多个后继或前继节点
顺序是指存储结构连续,例如数组是顺序的,链表不是顺序的,但它们都是线性的。当然顺序结构也可以是非线性的,例如顺序结构存储非线性结构的二叉树
【习题】
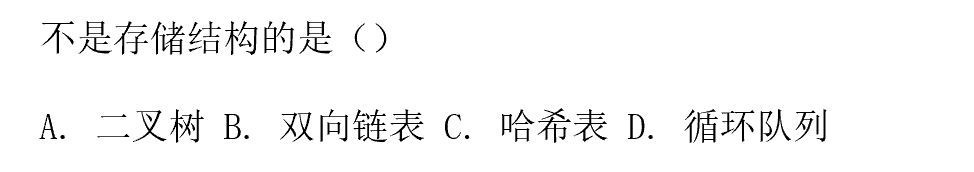
【解析】A,树只是表现数据的层次关系,不是一种存储结构,通常使用链表来存储树结构
【习题】
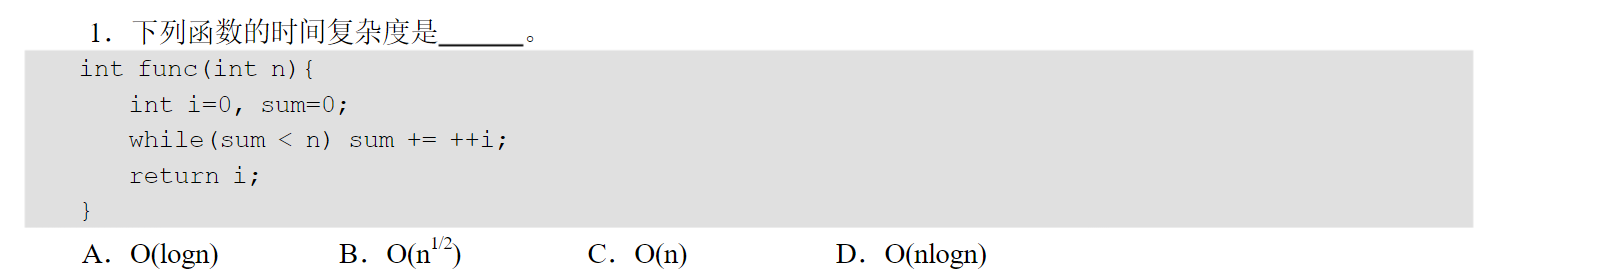
【解析】C,其实 s u m = 1 + 2 + 3 + ⋯ + k = ( k + 1 ) k 2 sum=1+2+3+\cdots+k=\frac{(k+1)k}{2}sum=1+2+3+⋯+k= (k+1)k/2
【习题】
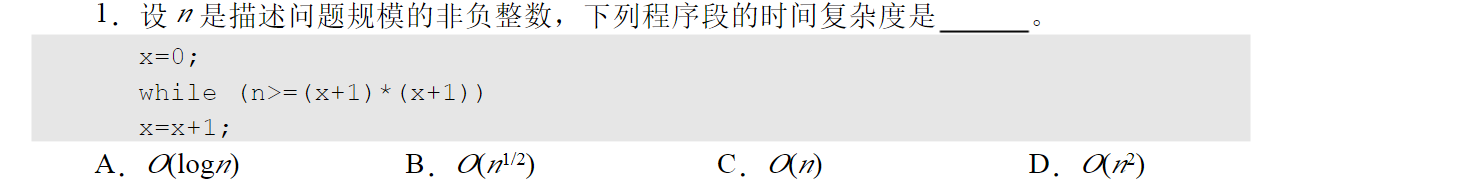
【解析】B,循环终止的条件
$$
循环终止的条件等价于 x^2 ≤ n,即 x ≤ n^{1/2},x是线性增长的,故复杂度为 O (n^{1/2})
$$
【习题】
【解析】
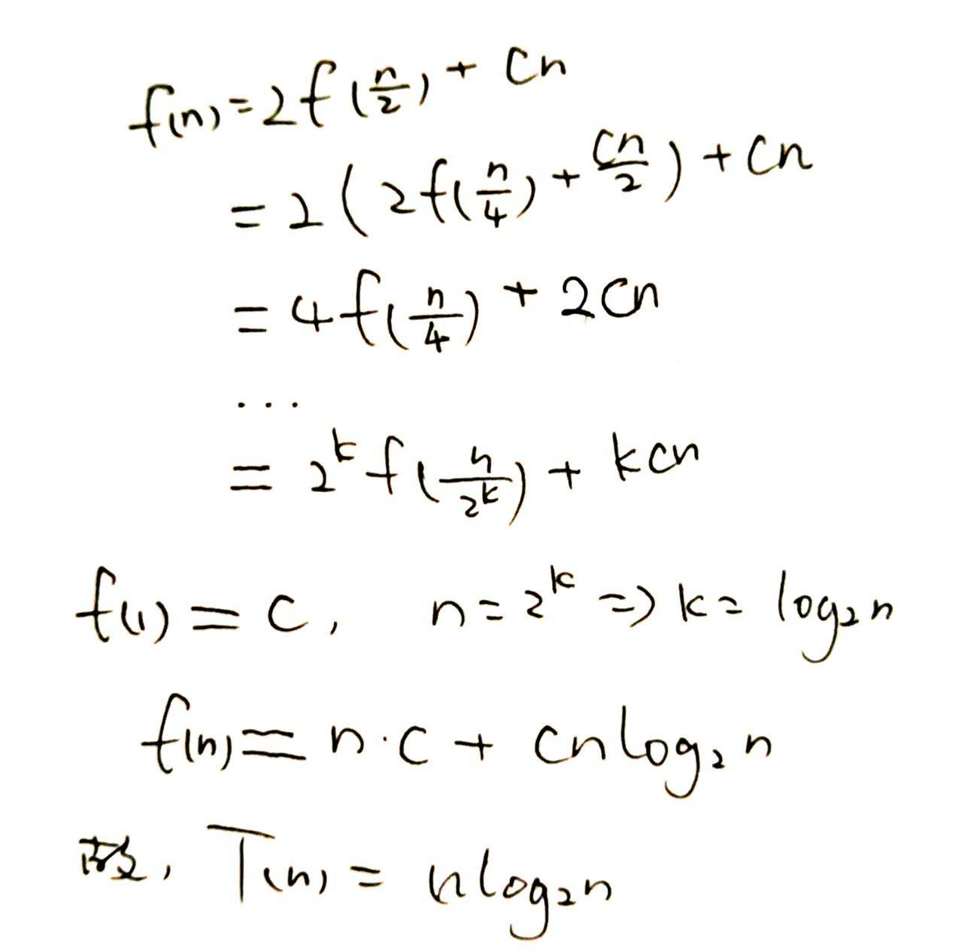
【习题】
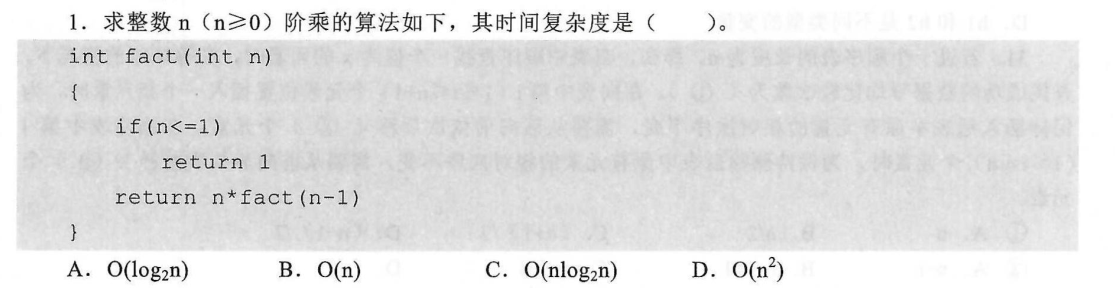
【解析】B
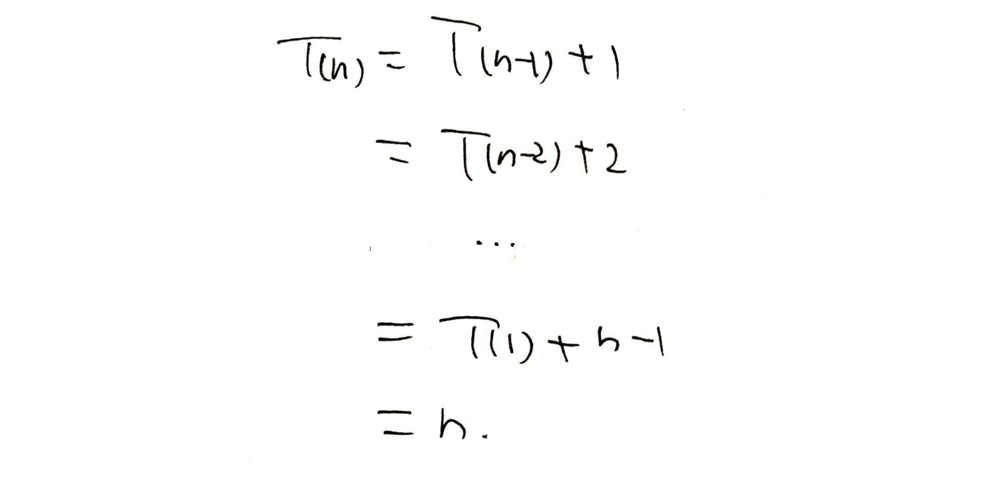
2 线性表
【线性表的定义】
线性表是具有 n 个相同特性 数据元素 的一个序列
【静态链表】

【习题】
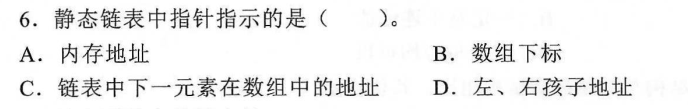
【解析】C,理论如上描述
【习题】
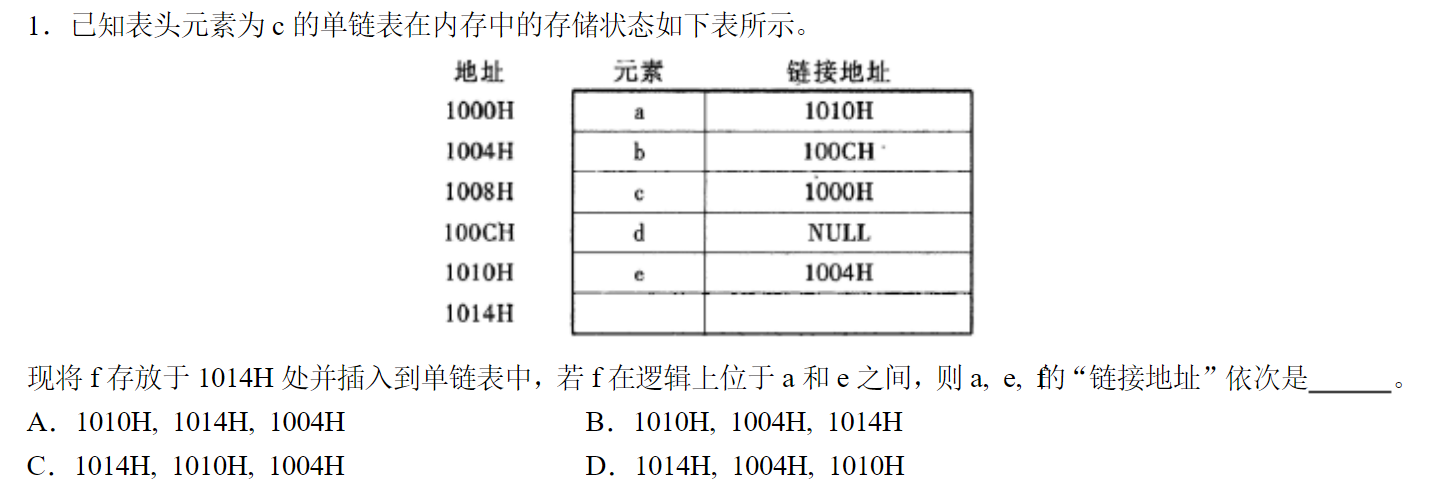
【解析】D,理论如上描述
【习题】
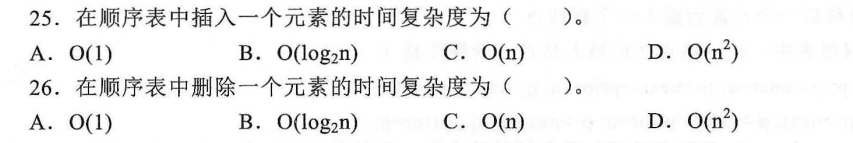
【解析】
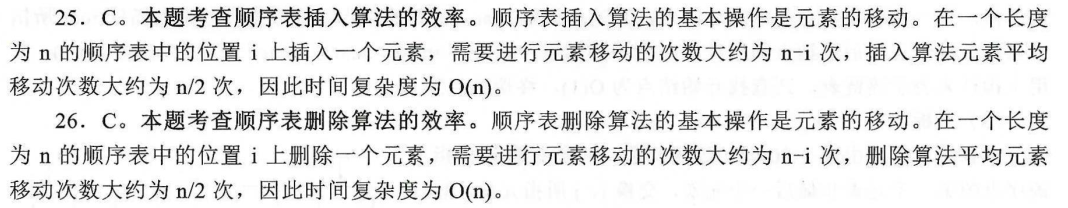
【习题】
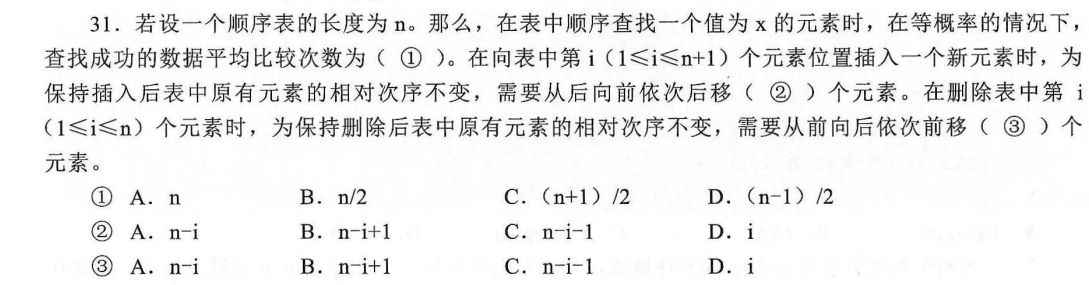
【解析】
【习题】
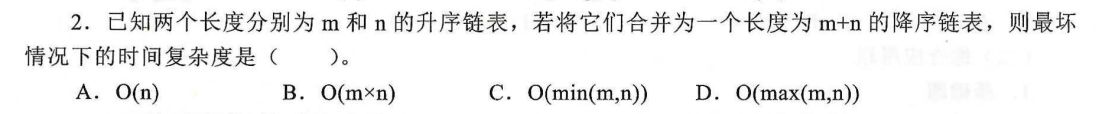
【解析】D,最好、最坏情况下都是 O(m+n)=O(max(m,n))
【习题】
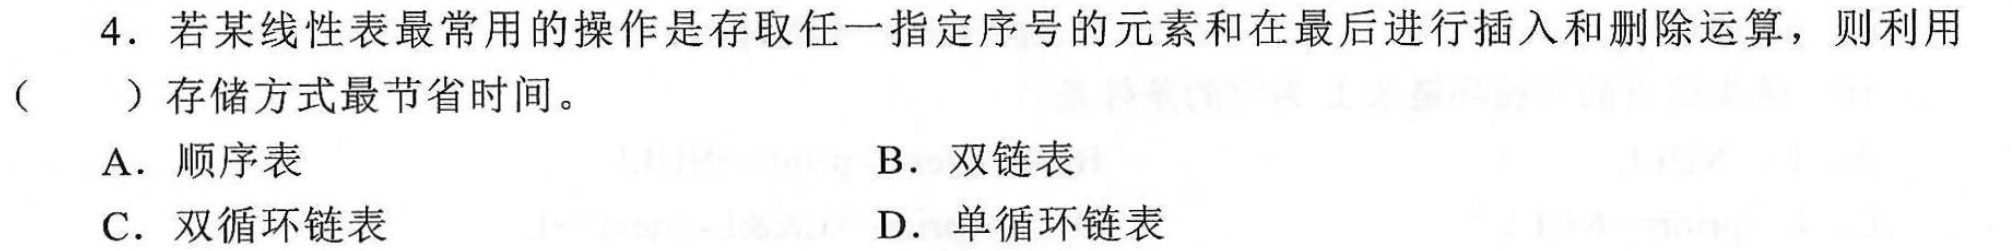
【解析】A,尾部插入和删除,且随机访问
【习题】
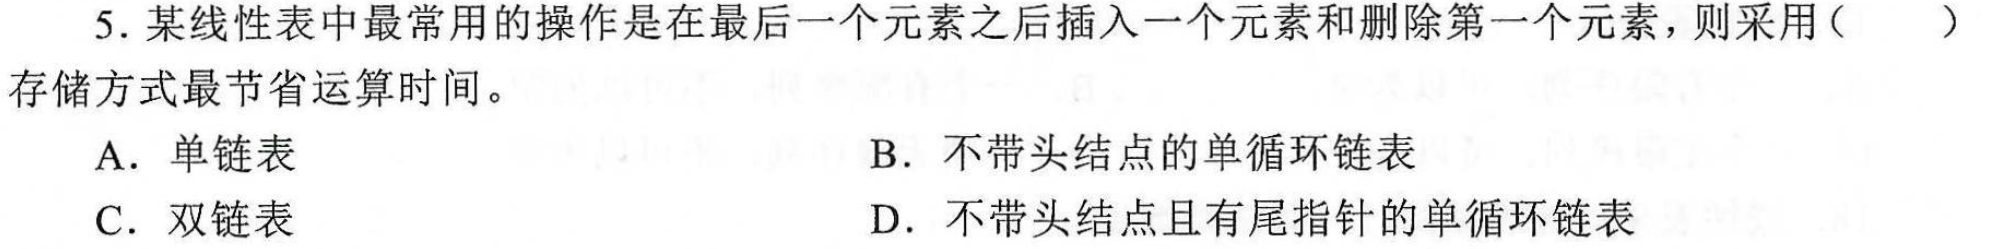
【解析】D,尾指针方便尾插入,单循环方便头删除
【习题】
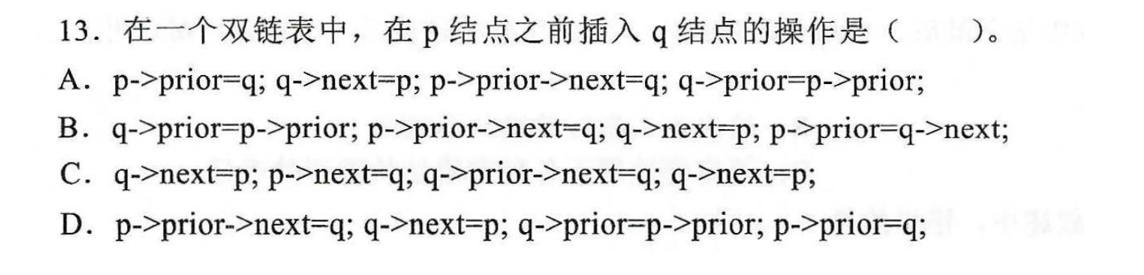
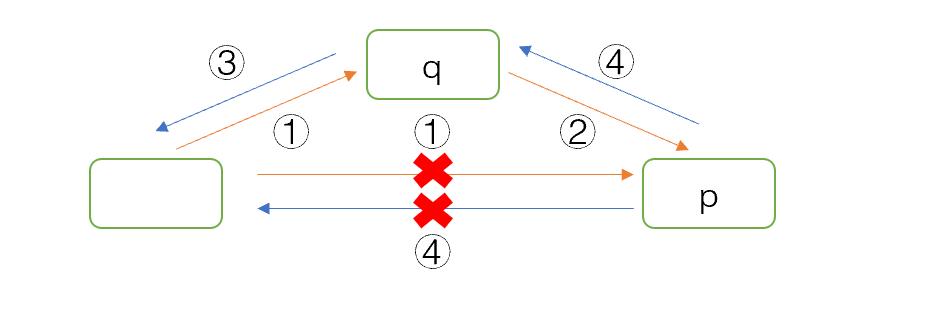
【解析】D,如下所示
【习题】
【解析】
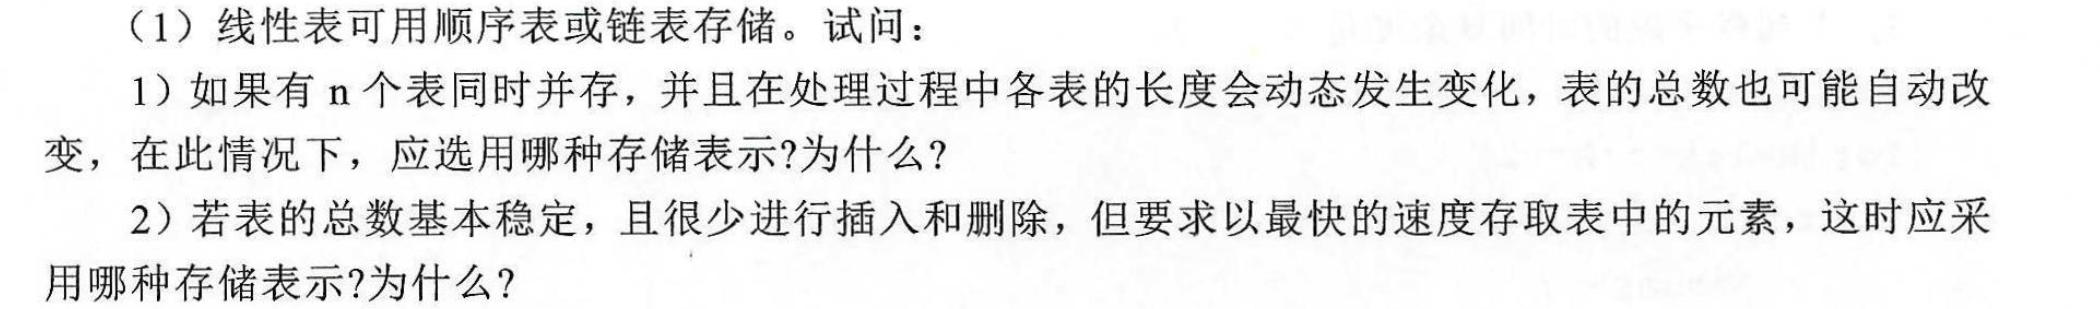
1)采用链表。如果采用顺序表,在多个表并存的情况下,在问题求解的过程中,一旦发现某个表有存满并溢出的情况,很可能需要移动其他表以腾出位置为其扩充空间,导致不断地把大片数据移来移去,不但时间耗费很多,而且操作复杂,容易出错。如果表的总数还要变化,则会带来需要在不影响其他表工作的情况下开辟新表空间或者释放就表空间的操作上的麻烦。如果采用链表就没有这些问题,一般在内存空间足够的情况下,各个表的空间分配或释放不受其他表的影响
2)采用顺序表。若表的总数基本稳定,且很少进行插入或删除,则顺序表可以充分发挥其存取速度快、存储效率高的优点
3 栈和队列
【栈的数学性质】
当 n个元素以某种顺序进栈,并且可以在任意时刻出栈(满足 FIFO 的前提下),所获得的元素排列的数目 N是卡特兰数,即
$$
N=\frac{C_{2n}^n}{n+1}
$$
【双端栈】
若栈采用顺序存储方式存储,现两栈共享空间,两栈栈底分别在顺序空间的两端,则栈满的条件 top[1]+1=top[2]
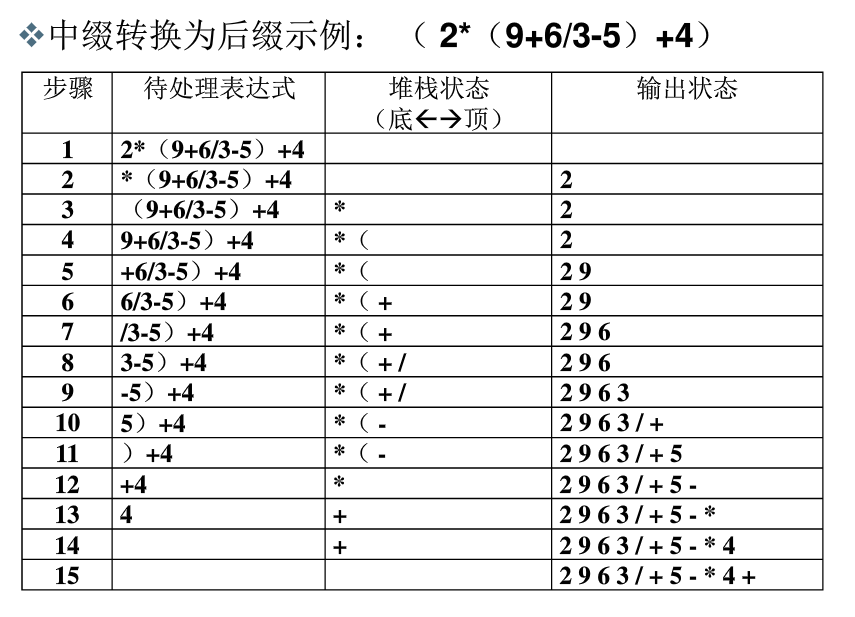
【中缀表达式转后缀表达式】
- 当前字符为数字,保存到后缀表达式字符串中
- 当前字符为 ( ,入栈
- 当前字符 ) ,弹出栈中 ( 前的所有运算符,包括 (
- 当前字符为普通运算符,依次弹出栈中优先级大于等于当前运算符的运算符,保存到后缀表达式字符串中,将当前运算符入栈
- 例如:
【循环队列】
队空:front==rear (少用一个元素空间,约定队列头指针在尾指针的下一位置为满)
队满:(rear+1)%maxsize==front
入队:rear=(rear+1)%maxsize
出队:front=(front+1)%maxsize
求长度:(rear−front+maxsize)%maxsize
【抽象数据类型】
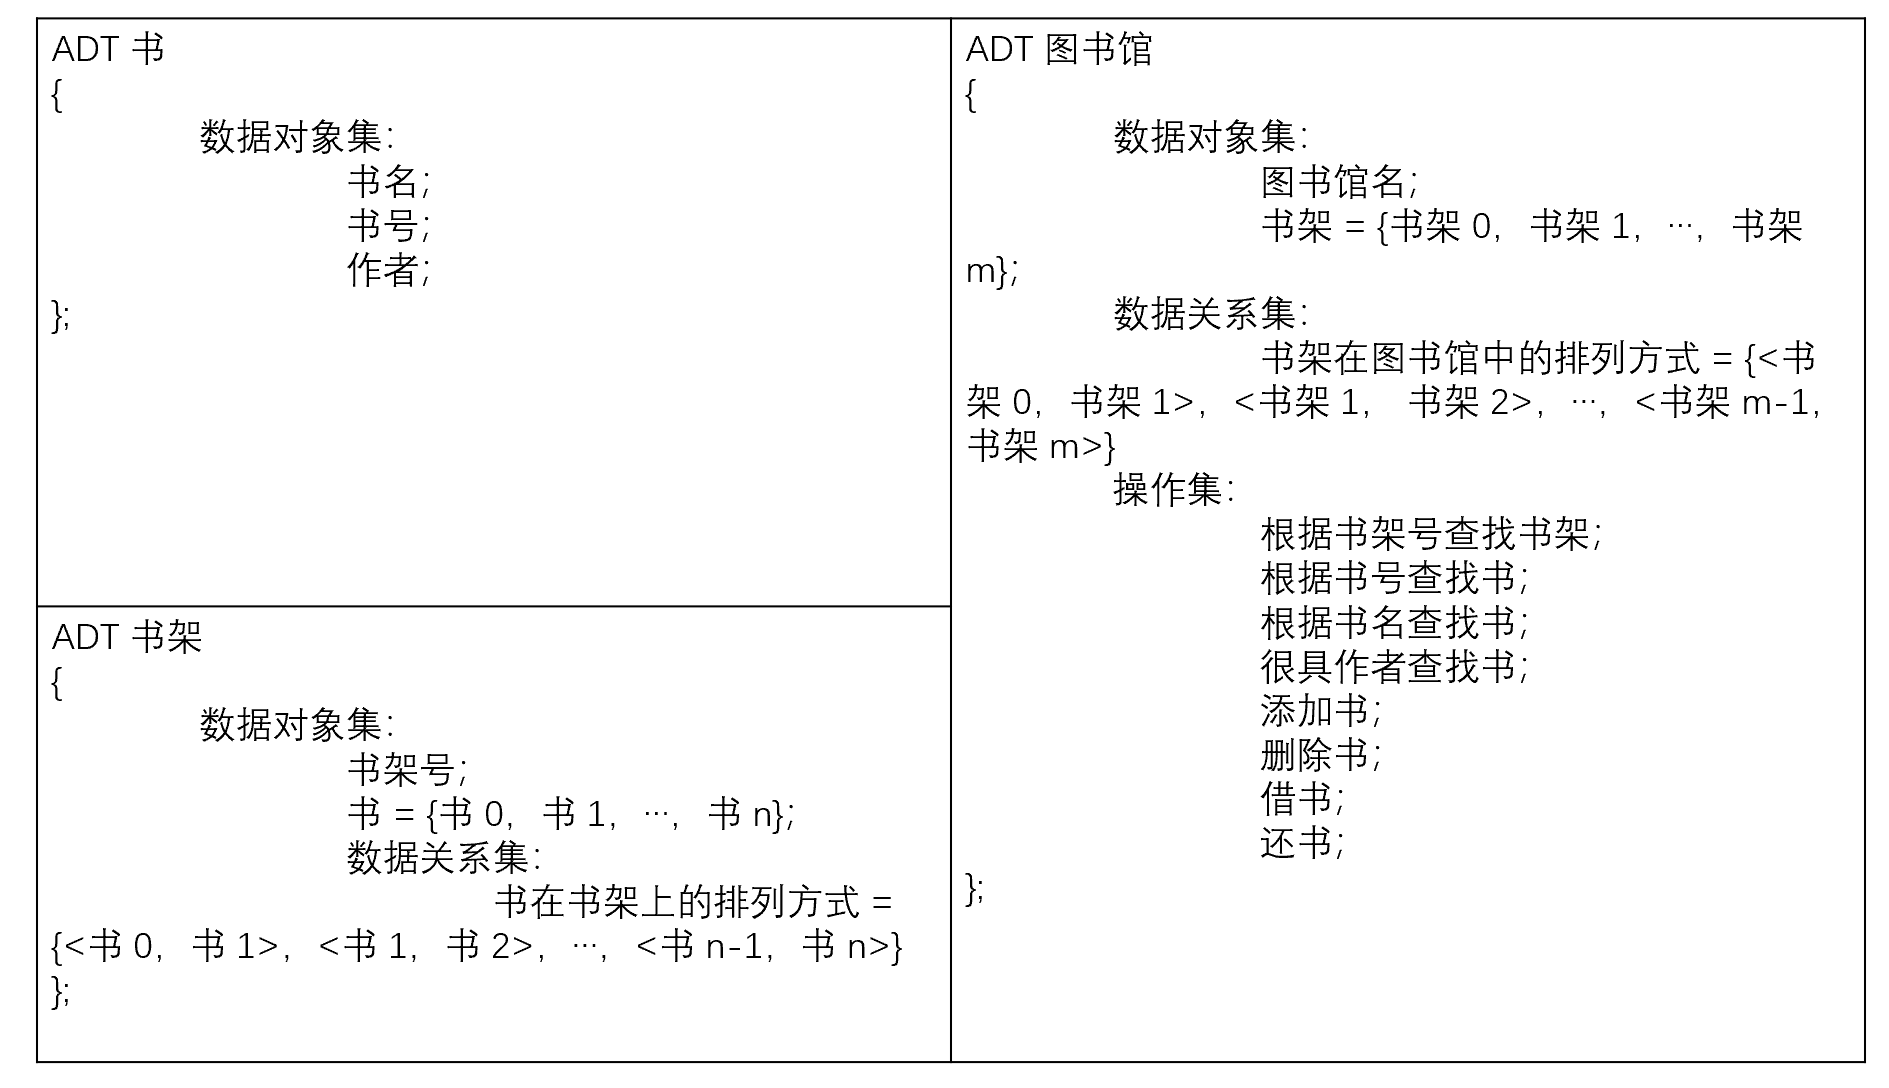
一个抽象数据类型(ADT),可以看作一些数据对象以及附加在这些数据对象上的操作的集合。ADT 重在对功能的描述而不关心具体实现
ADT 包括数据对象集、数据关系集合操作集
以一道题为例简单过一下 ADT 可能出考题的情况,例如. 设计一个图书馆 ADT
【习题】
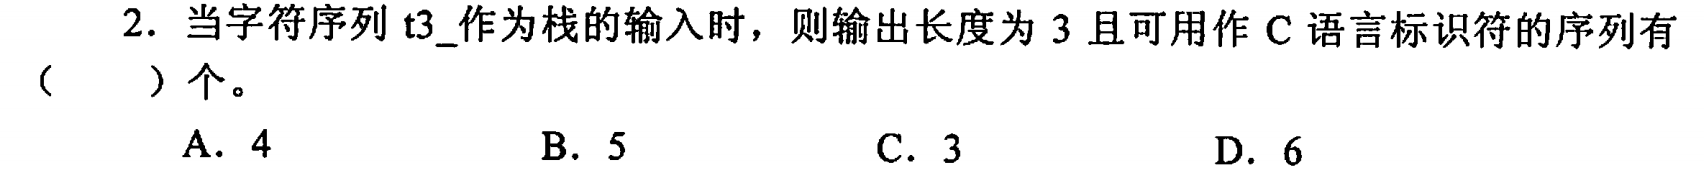
【解析】C,根据卡特兰数,3 个元素进栈,出栈有 5 种情况,标识符要求只能以字母或下划线开头,于是,去掉 3_t 和 3t_ 两种情况,故还剩下 3 种情况符合表示符的要求
【习题】
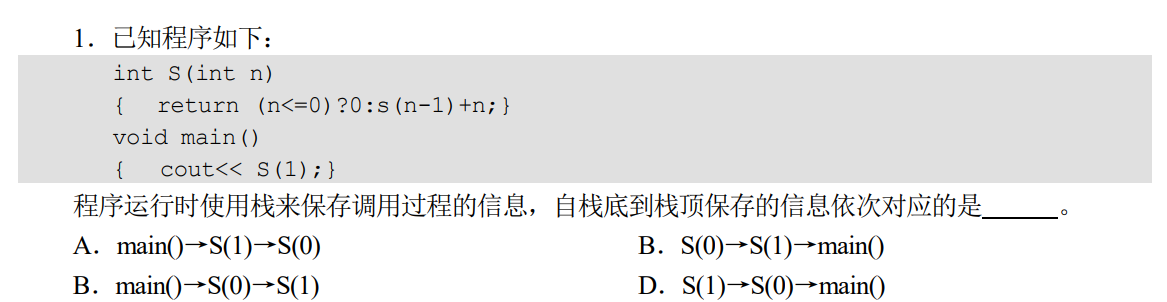
【解析】A,调用的顺序依次为 main()→ \rightarrow→S(1)→ \rightarrow→S(0),即进栈的顺序
【习题】
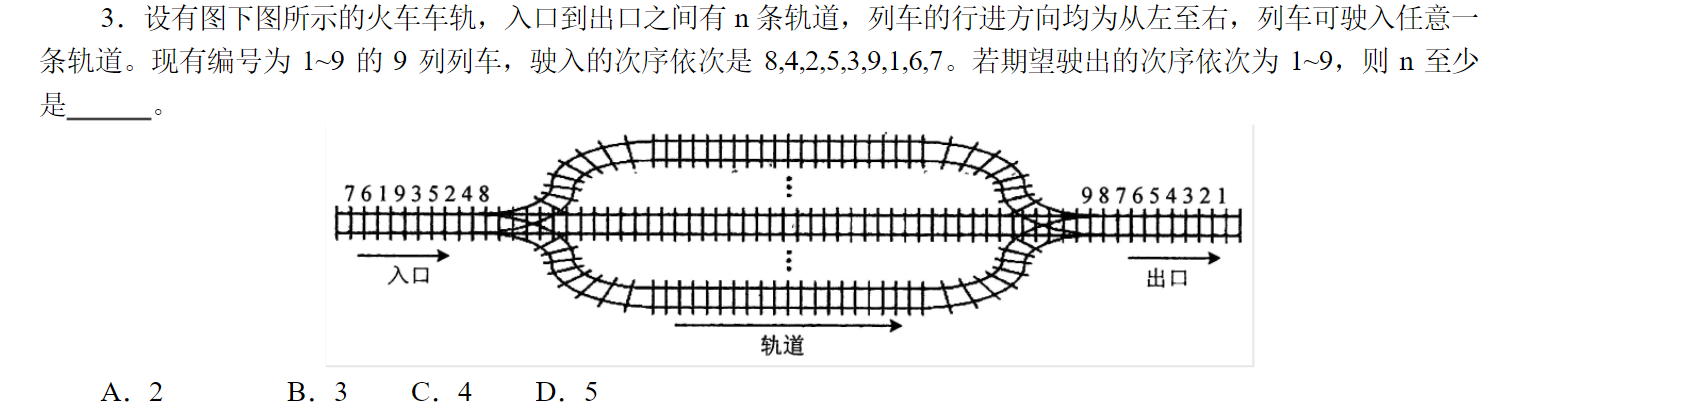
【解析】C,4 个轨道分别如下:保证队列中后进入的元素小于先进入的元素
| 队列 | 队列元素 |
|---|---|
| 队列 1 | 8,4,2,1 |
| 队列 2 | 5,3 |
| 队列 3 | 直通(9,7) |
| 队列 4 | 6 |
【习题】
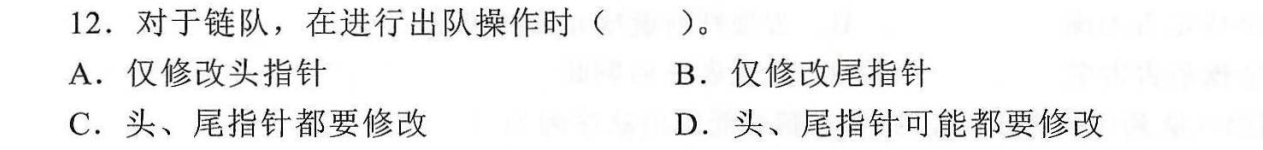
【解析】D
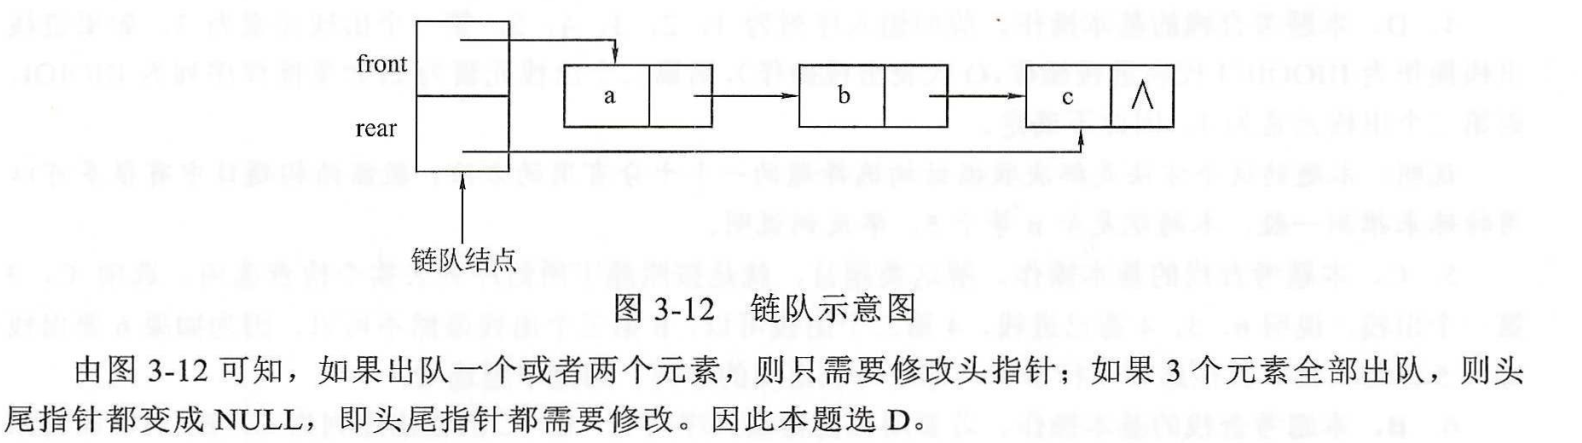
【习题】
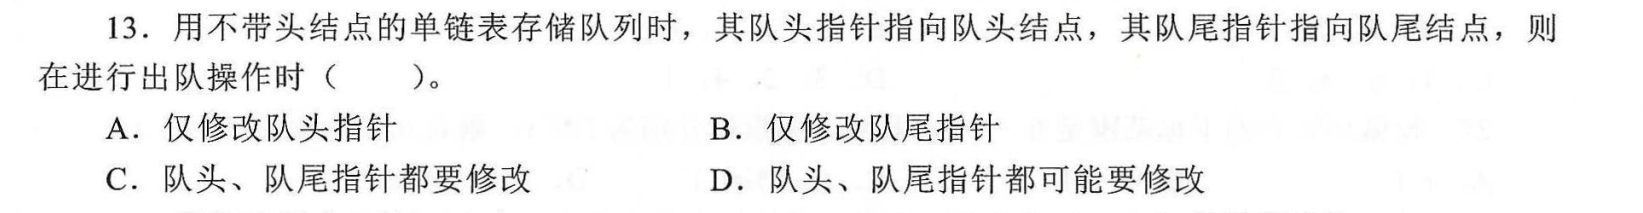
【解析】D,理由同上题所述
【习题】
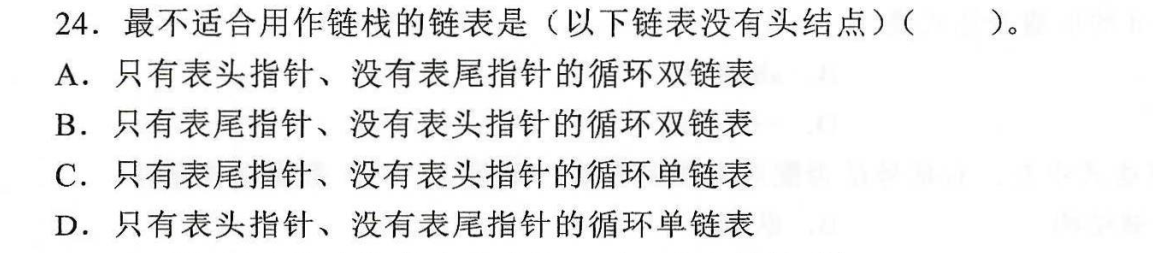
【解析】D,考虑出栈,因为链栈在链表的头部进行操作,需要很方便找到链表开始结点的前驱,而只有表头指针、没有表尾指针的循环单链表找前驱的时间复杂度是O(n)
【习题】

【解析】C,p3 = 1 且 1 是第一个出栈元素,p1,p2,p3这三个元素连续进栈,第二个出栈的是2,此时栈顶是p2,故只有 p2, …, pn 可能为2
【习题】
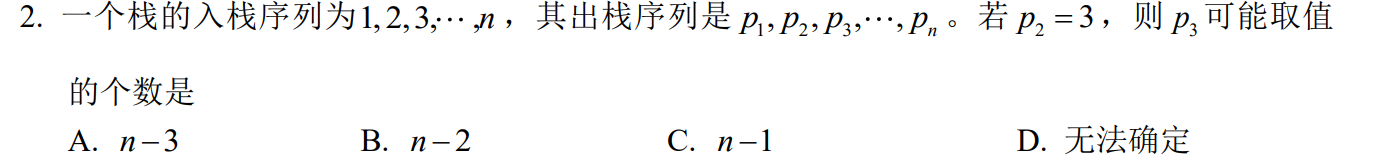
【解析】C,8除 3 之外,其他值是均有可能取到的
【习题】
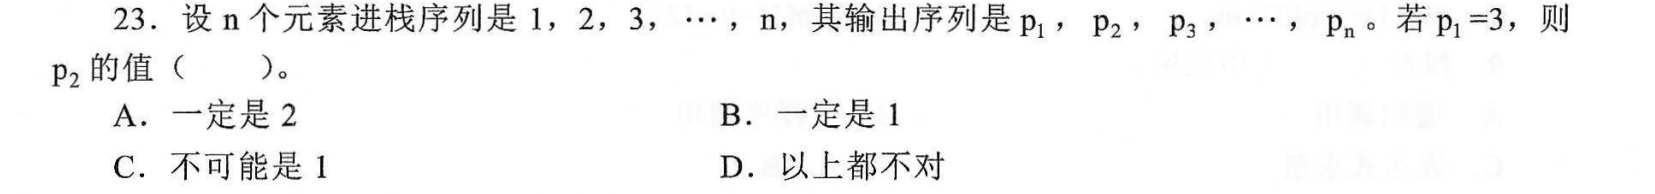
【解析】C,p1 是第一个出栈的,p1 = 3 的话,栈里面至少还存在 2、1(2 在 1 上)这样的部分,显然第二个出栈的元素不可能是 1
【习题】
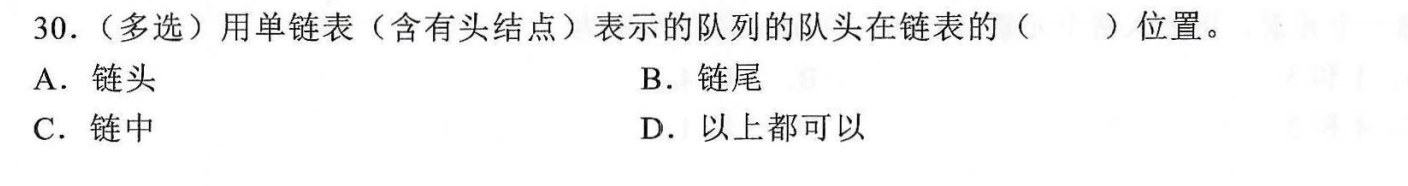
【解析】BC,当队列只有一个元素时,头指针指向尾结点;当队列中元素大于一个时,头指针指向链中(链中位置是指除去头节点、尾结点的位置)
【习题】

【解析】B,当带有头结点的单链表用作队列的存储结构时,链尾即队尾
【习题】
【解析】
【习题】
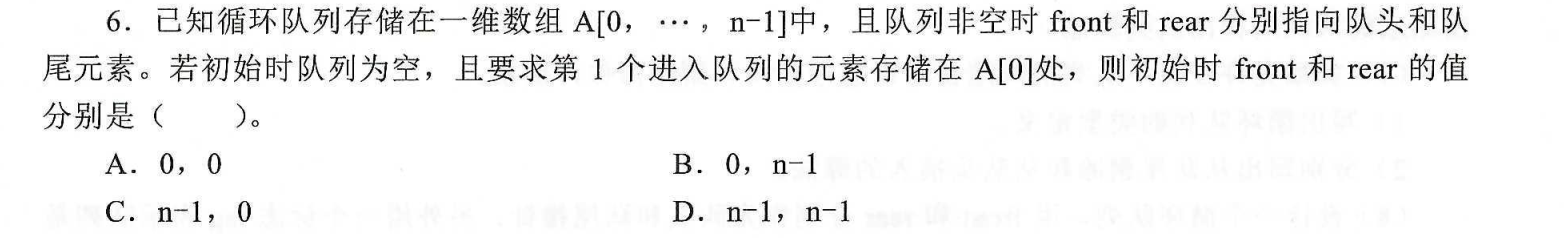
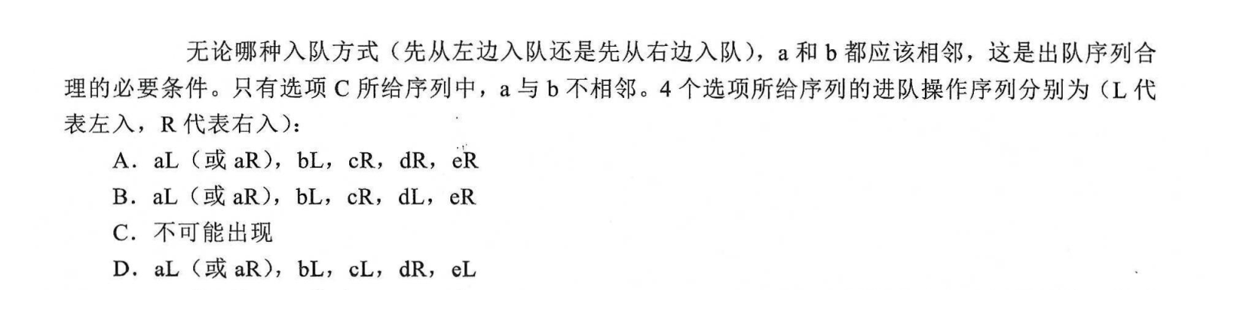
【解析】B
注意队列非空时 front 和 rear 分别指向队头和队尾元素,但这里并不满足我们说的 rear == front 表示对空,如果一定要这样认为选择 D 的话,则在进入一个元素后 front=n-1,rear=0,这时队列是 n 个元素
为什么会产生这样的差异呢?原因是在我们熟知的循环队列中,rear 所指向的位置应该视为一个空位置(即使有元素存在),即入队元素填在此位置上,然后 rear 再向后移动一次,而本题中,rear 指向的就是队尾元素,是一个实实在在队列中的元素
【习题】
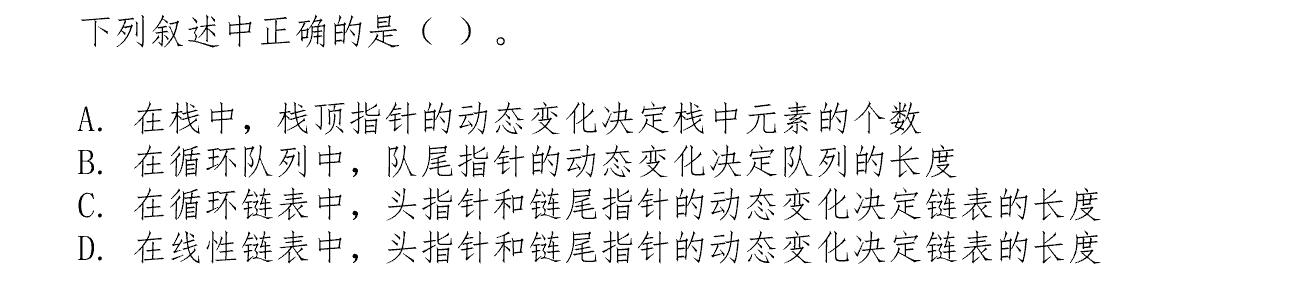
【解析】A,在栈中,栈底指针保持不变,有元素入栈,栈顶指针增加,有元素出栈,栈顶指针减少;在循环队列中,队头指针和队尾指针的动态变化决定队列的长度,故 B 错误;无论在循环链表还是线性链表中,要插入或删除元素,只需要改变相应位置的结点指针即可,头指针和尾指针无法决定链表长度,故 C、D 错误
【习题】

【解析】
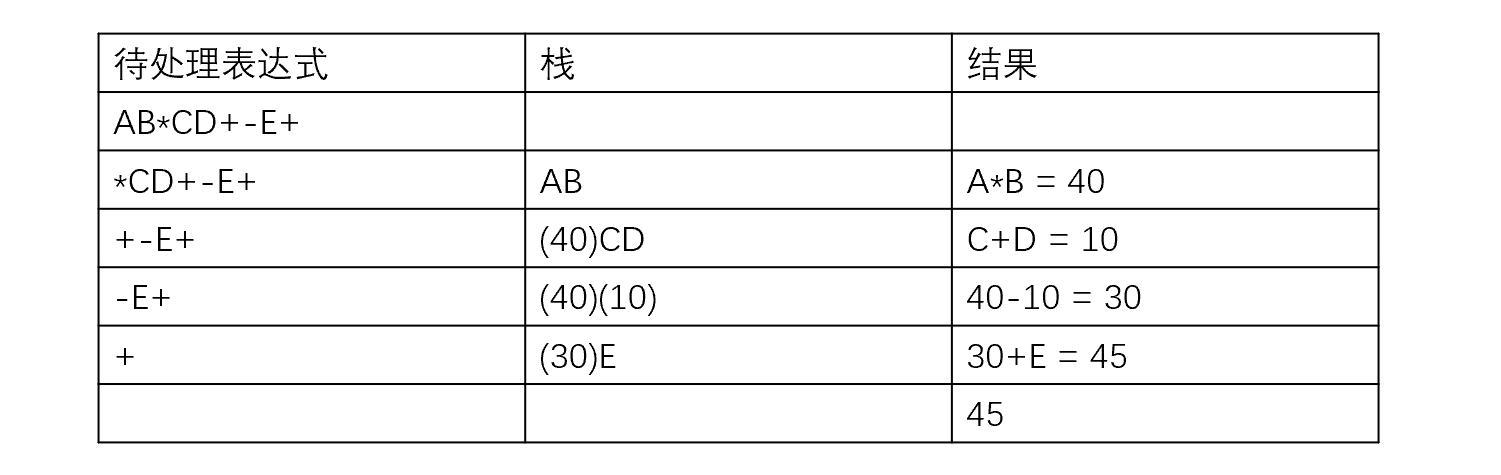
后缀表达式转中缀表达式的过程如下
- 把后缀表达式逐个元素的压入到栈中,当压入的都是字符,则不采取任何操作,当压入的是运算符,则把运算符下面的两个数字弹出和运算符进行运算,然后把结果继续压入到栈中
- 对后缀表达式中的所有元素执行该操作,直到结束
- 于是,对于本题,计算过程如下
【习题】写出下列中缀表达式的后缀形式
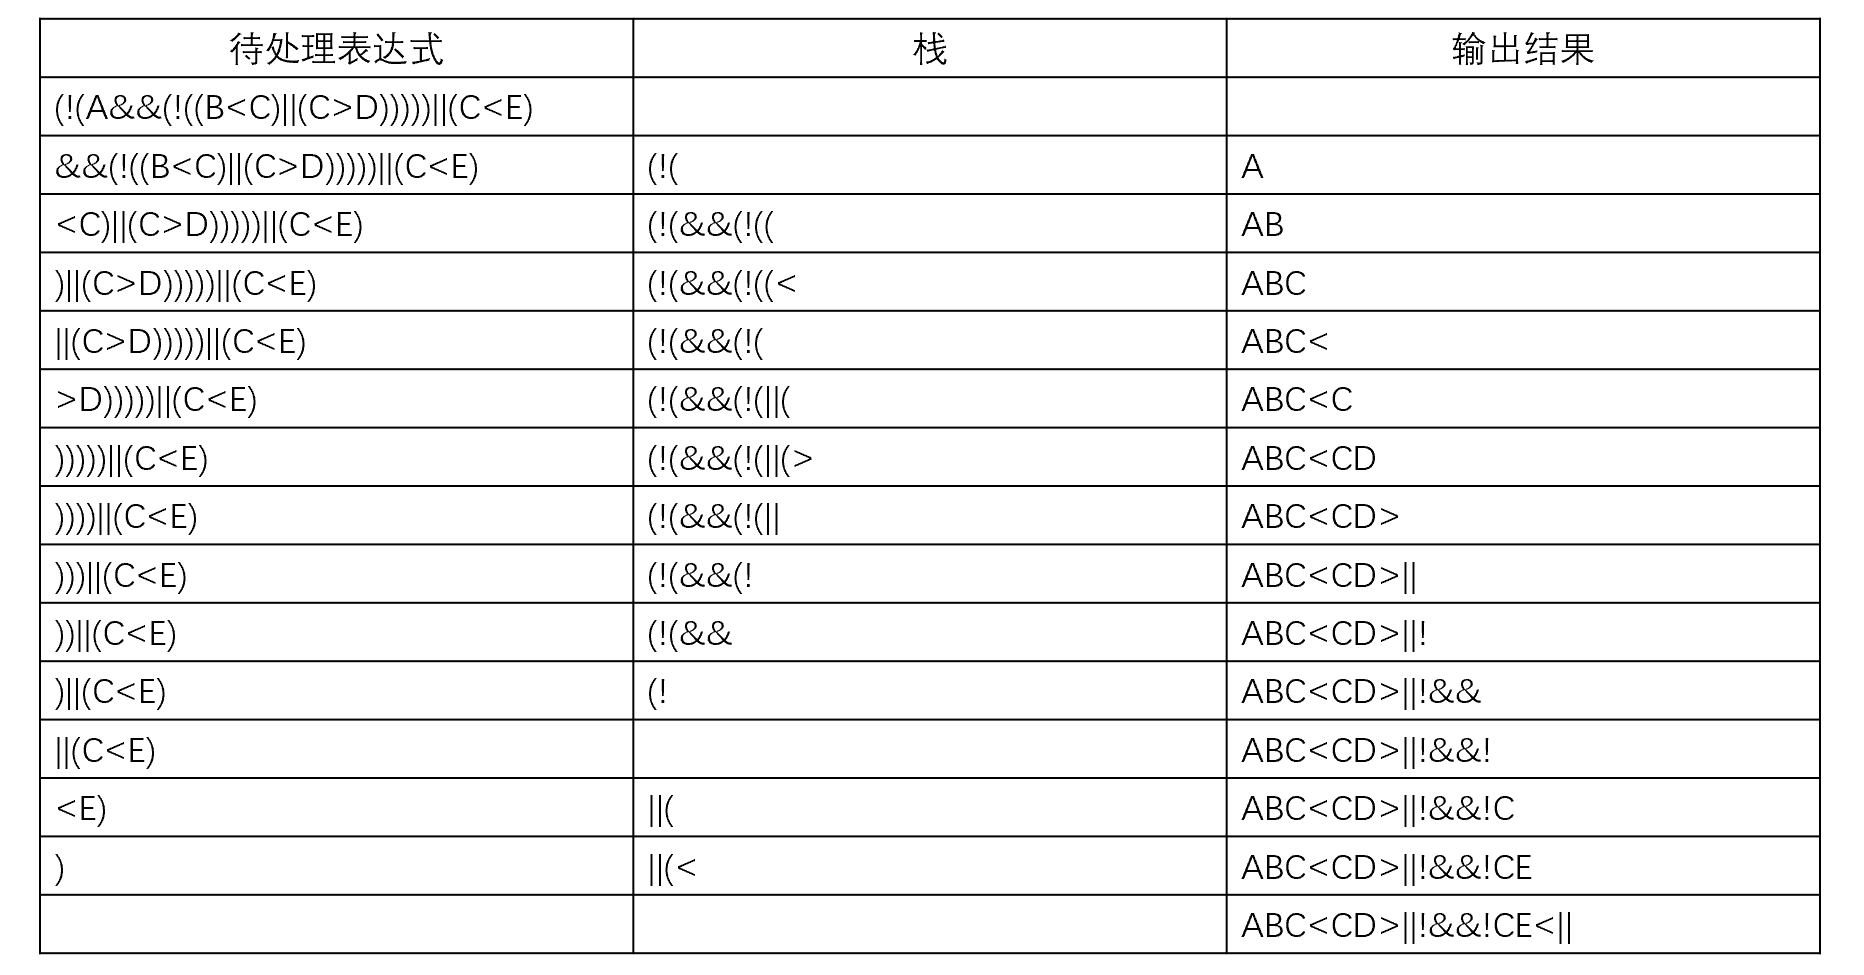
(!(A&&(!((B<C)∣∣(C>D)))))∣∣(C<E)
注:单目运算符,! A !A!A 的后缀表达式是 A ! A!A!
【解析】取反运算符的优先级高于加减乘除,后缀表达式为ABC<CD>∣∣ ! && ! CE<∣∣,具体过程如下
【2019年真题】
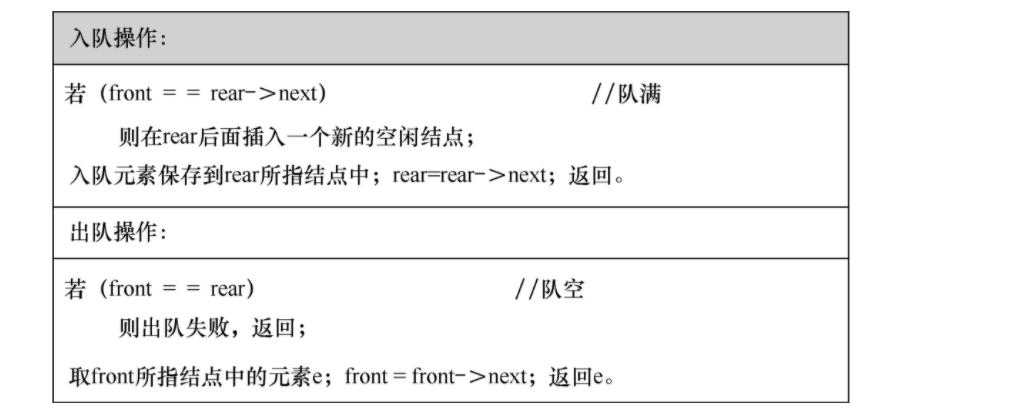
【解析】从题目的意思看来应该是指循环队列
(1)要求入队时允许增加队列占用空间,显然队列可以动态增长,则应该选择链式存储结构
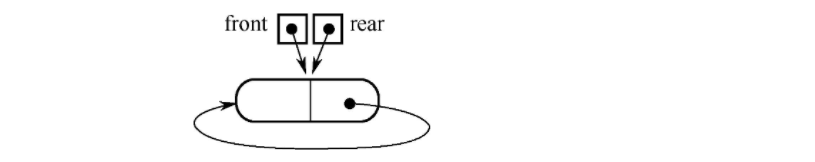
(2)我们考虑用循环单链表实现该队列,且设置 f r o n t frontfront 和 r e a r rearrear 两个指针,当 f r o n t = = r e a r front==rearfront==rear 表示队空,f r o n t = = r e a r → n e x t front==rear\rightarrow nextfront==rear→next 表示队满。出队时,不释放结点,只将 f r o n t frontfront 指针后移。入队时,如果有空闲结点则利用队尾指针后的第一个空闲结点,否则则在队尾指针后插入一个结点。于是,初始状态如下所示
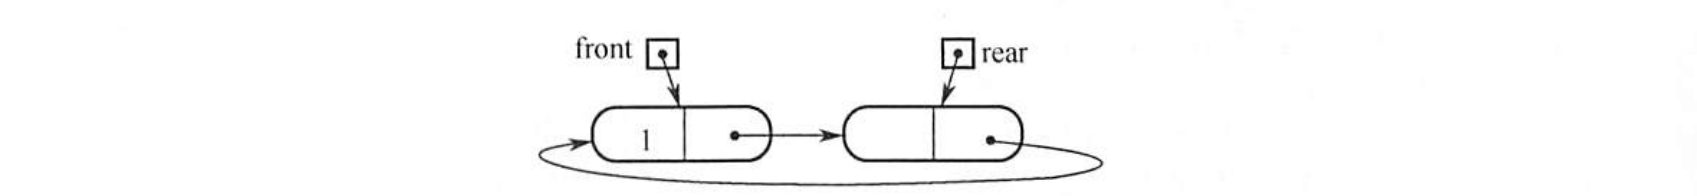
(3)如下图所示
(4)
6 树
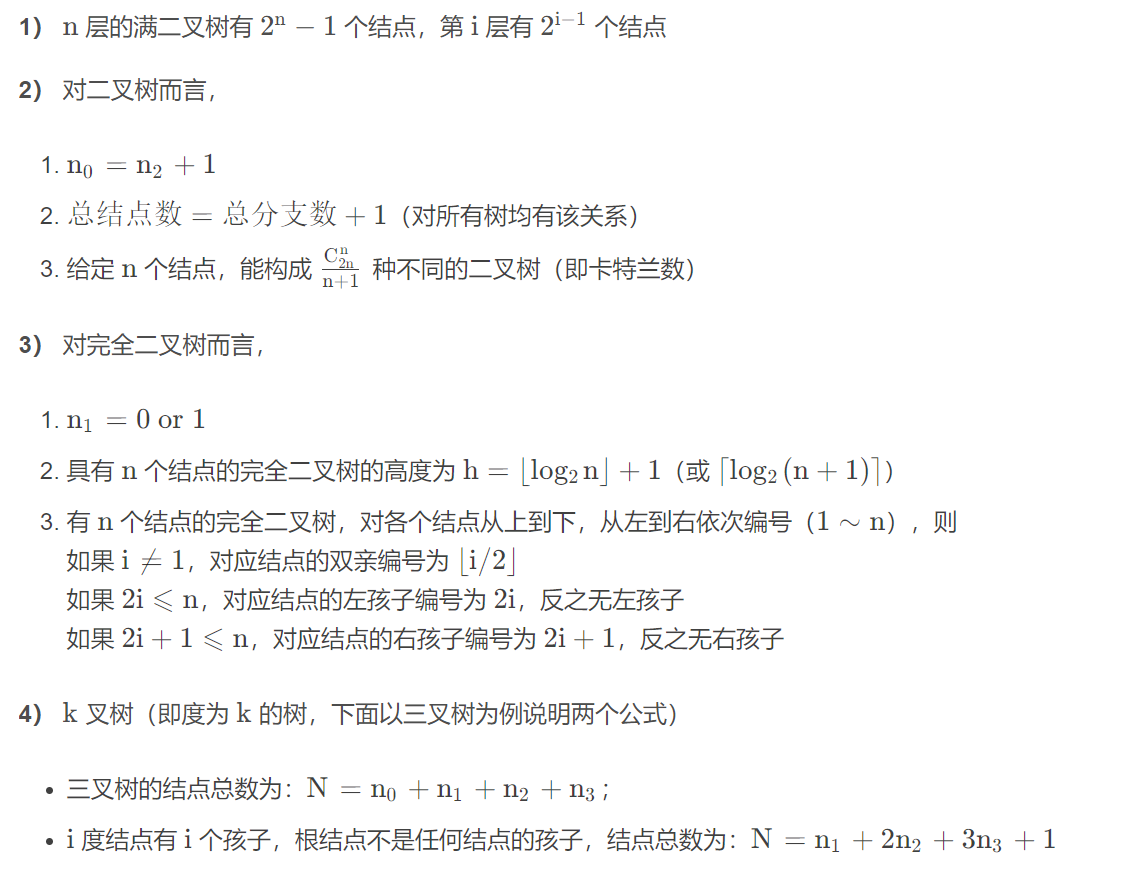
【一些关于树的计算公式的总结】
【树的遍历】
<前,中>、<后、中> 的遍历序列可以唯一确定一颗二叉树,而 <前,后> 的遍历序列是不能唯一地确定一颗二叉树
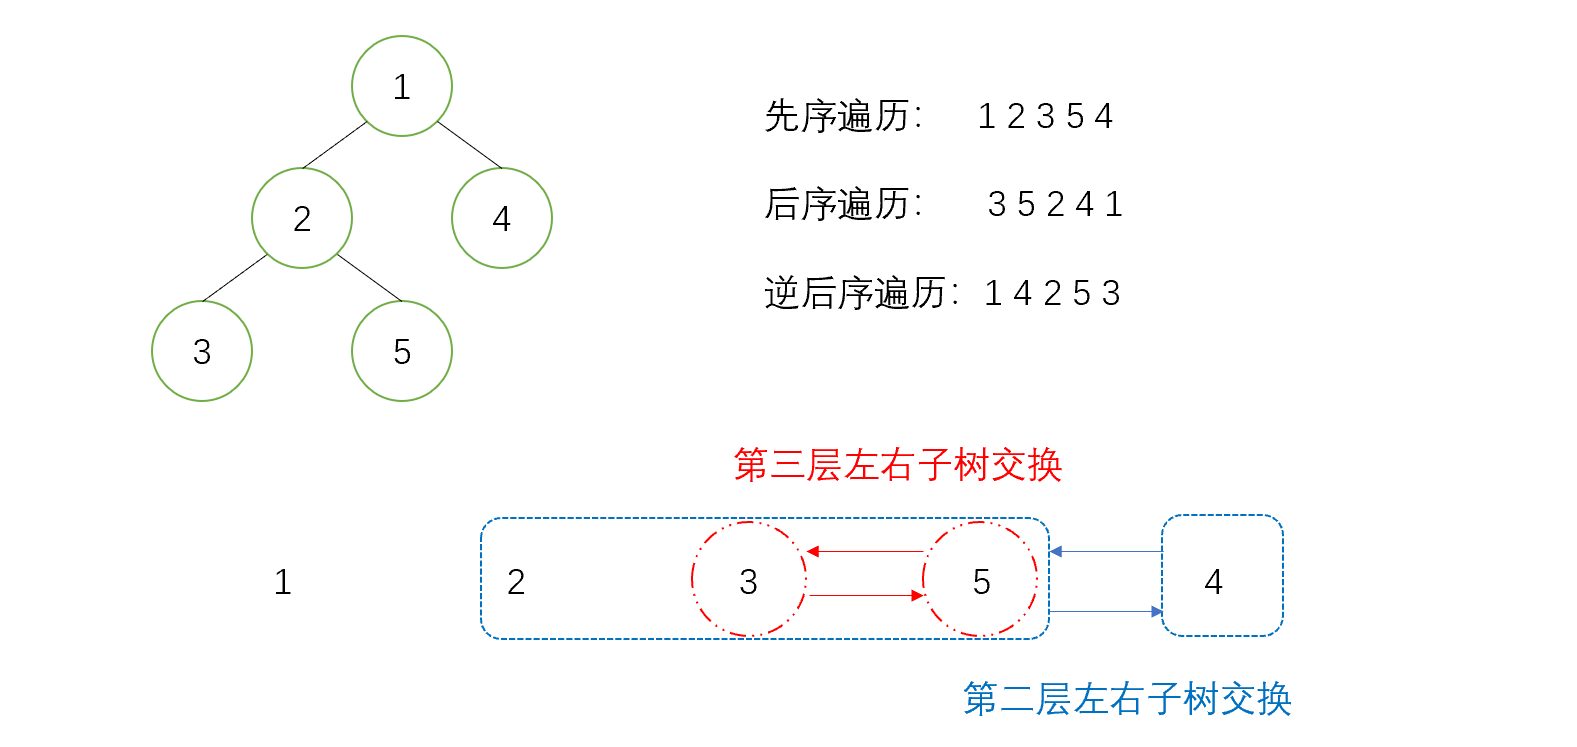
逆后序遍历序列只不过是先序遍历过程中对左右子树遍历顺序交换所得的结果,如考虑如下二叉树
【线索二叉树】
线索二叉树的高效性体现在哪里? 答:二叉树被线索化后近似于一个线性结构,分支结构的遍历操作就转化为了近似于线性结构的遍历操作,通过线索的辅助使得寻找当前结点前驱或者后继的平均效率大大提高。至于线索二叉树是否对空间的利用率有所提高,不好回答,因为每个结点多了两个标志域ltag 和rtag,它们导致的额外空间开销是否对比非递归遍历算法中的栈空间开销少,在不同的场合下很难确定
线索二叉树的结点结构如下

如果ltag=0,则表示 lchild 为指针,指向结点的左孩子;ltag=1,则表示 lchild 为线索,指向结点的直接前驱
【二叉树和森林】
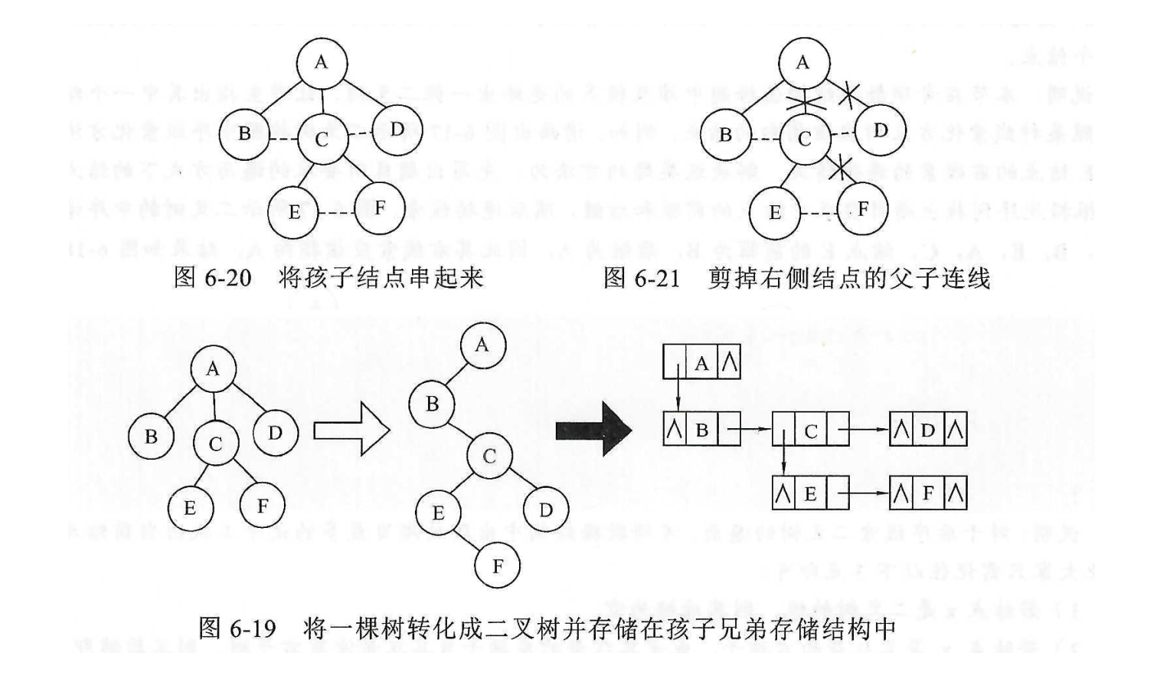
1)树转化为二叉树
将同一结点的各孩子用线串起来
将每个结点的分支从左往右除第一个以外,其余全部减掉
2)二叉树转化为树
- 将一棵二叉树从左上到右下分为若干层(捋平)
- 找到每一层结点在其上的父结点
- 将每一层的结点和父结点相连,然后再删除每一层结点之间的连接

3)森林转化为二叉树
- 将每棵树转化为其各自对应的二叉树
- 将第二棵二叉树作为第一棵二叉树的右子树,依此类推,直到把所有的二叉树合并成为一棵二叉树
二叉树转化为森林只需要逆向执行上述过程即可:不停地将根结点有右孩子的二叉树的右孩子链接断开,直到不存在根结点有右孩子为止;然后,将得到的多棵二叉树转化为树
4)树和森林的遍历
树的先序遍历:先访问根结点,再依次访问根结点的每棵子树,访问字子树时仍然遵循先根再子树的规则
树的后序遍历:先依次访问根结点的每棵子树,再访问根结点,访问子树时仍然遵循先子树再根的规则
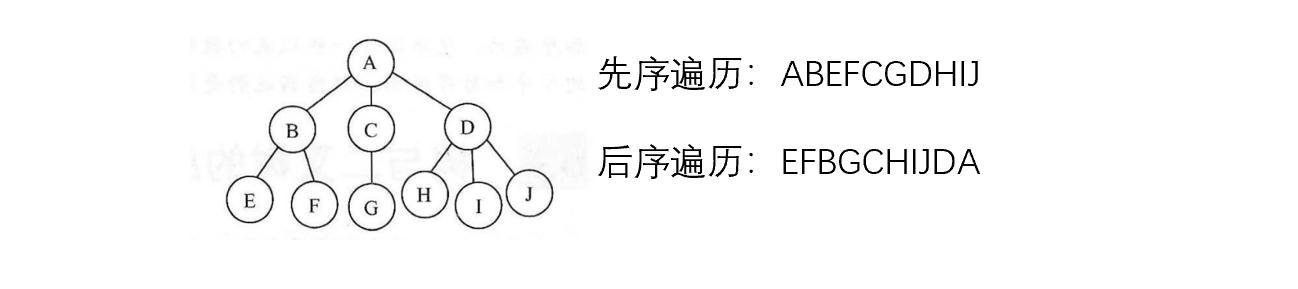
森林的先序遍历对应二叉树的先序遍历,森林的后序遍历对应二叉树的中序遍历(森林的中序遍历等同于后序遍历)
【哈夫曼树】
1)哈夫曼树的特点
- 哈夫曼树为带权路径最小的二叉树,但不一定是完全二叉树
- 树中没有度为 1 的结点
- 权值越大的结点,距离根结点越近
- 对于同一组结点,构造出的哈夫曼树可能不唯一
2)哈夫曼编码
任一字符的编码串都不是另一字符编码串的前缀
3)哈夫曼 n 叉树
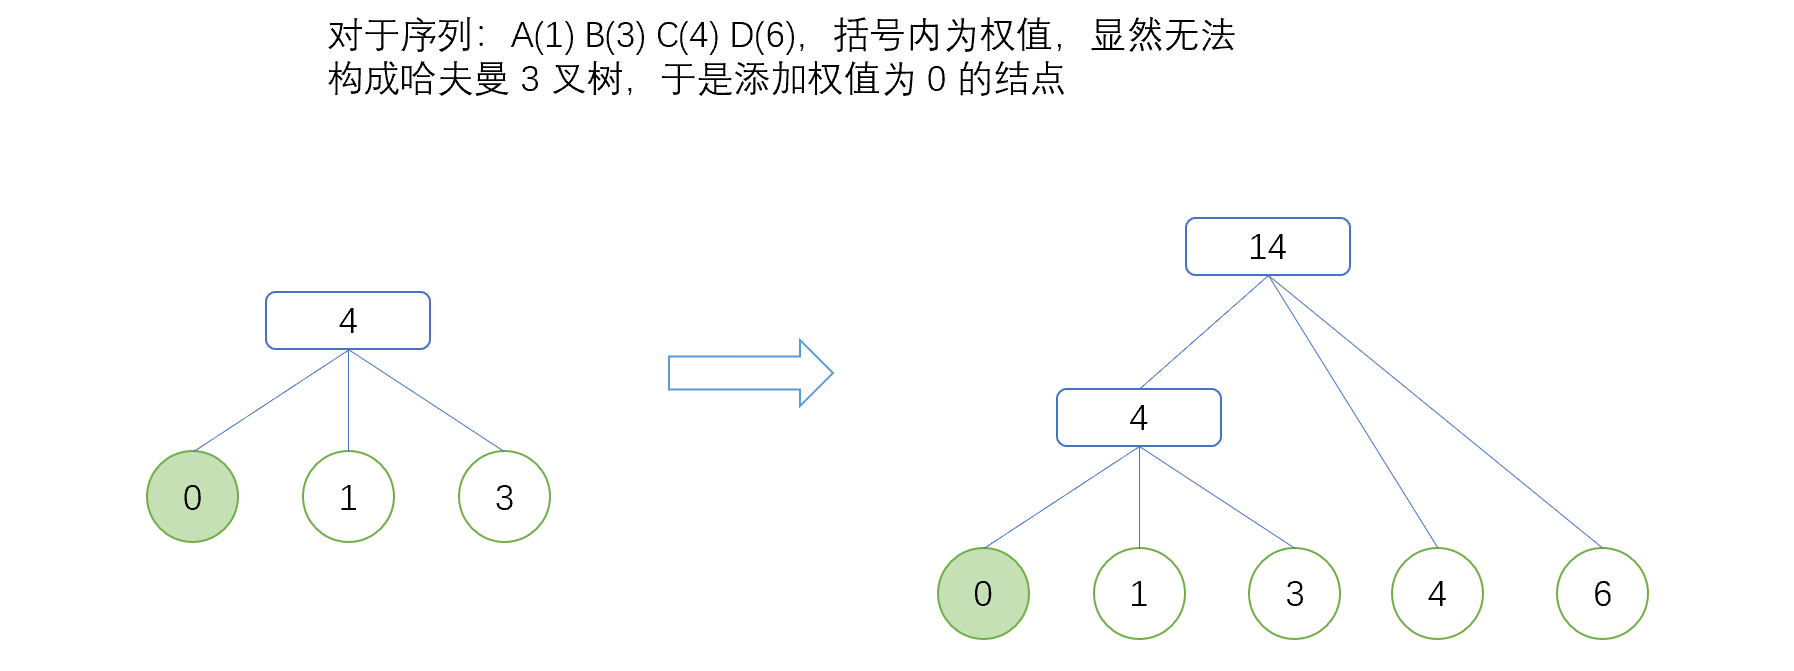
对于结点数目大于等于 2 的待处理序列,都可以构造哈夫曼二叉树,但却不一定能构造哈夫曼 n 叉树。当发现无法构造时,需要补上权值为 0 的结点,让整个序列凑成可以构造哈夫曼 n 叉树的序列
与树、二叉树定义相关的习题
【习题】
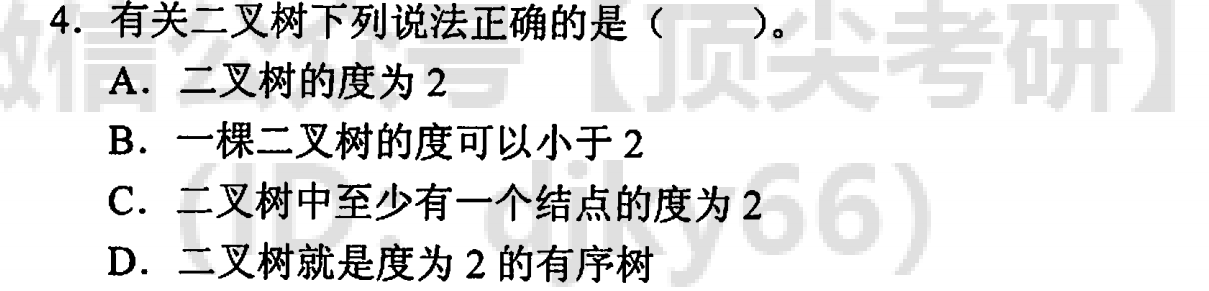
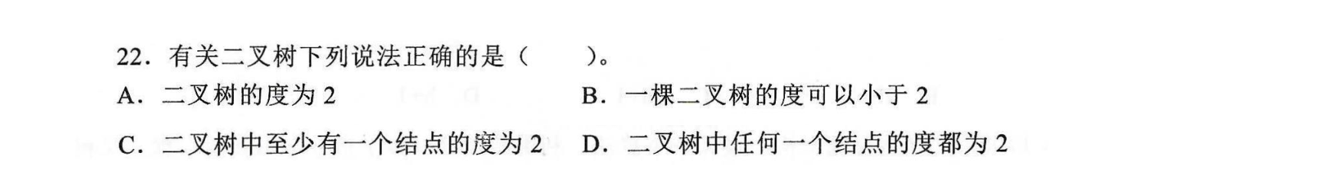
【解析】B,二叉树的度至多为 2,可以小于2,故 A、C 错误;在度为 2 的有序树中,孩子结点的左右顺序是相对于其兄弟结点而言的,如果仅有一个孩子结点,那么无所谓左右孩子,但是在二叉树中即使只有一个孩子结点,该孩子结点仍然要区分左孩子还是右孩子,故 D 错误
【习题】
【解析】B,由树的度的定义可知,树中各个结点度的最大值为树的度,单个结点也算是一棵树。那么对于一个只有一个节点的二叉树,其度为 0
【习题】
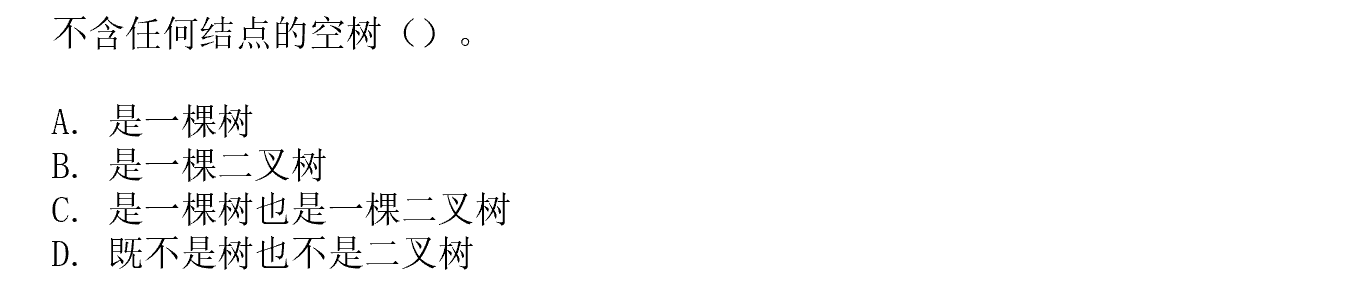
【解析】B,二叉树可以为空,但是树不可以空,树是图的特例,故图也不能为空
【习题】

【解析】除去根结点的 n−1 个结点都有一个指针指向它,故在二叉树中有 n−1 非空指针域
【习题】
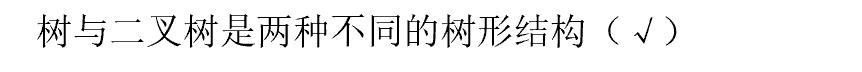
【解析】二叉树不是树的特殊情况,因为具有两个结点的二叉树是区分左右子树的,具有两种形态;而树的结点位置是相对于其他节点位置而言的,具有两个结点的树不区分左右,因此其只有一种形态
与二叉树的遍历相关的习题
【习题】
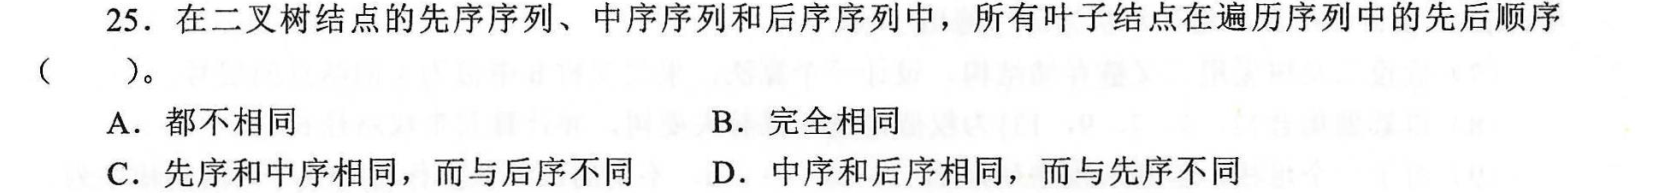
【解析】B,不论是哪一种遍历方式,所得遍历序列中叶子结点的相对位置都是不变的
【习题】
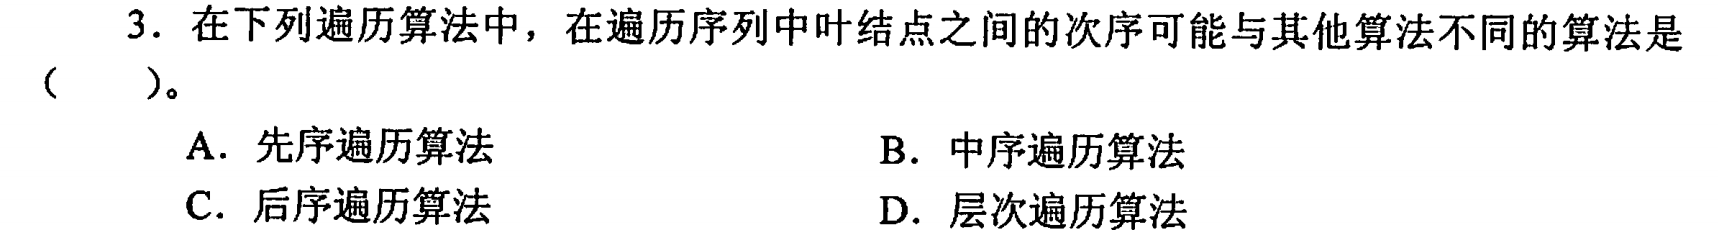
【解析】D
【习题】
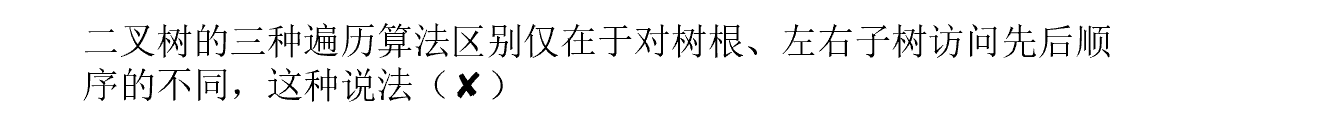
【解析】三种遍历方法的指针游走都是根左右,只是打印顺序不同
【习题】
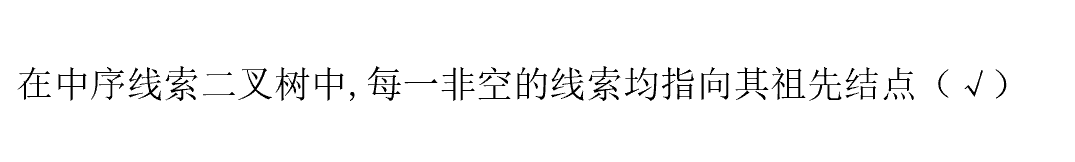
【解析】画棵树出来是很容易理解的
【习题】
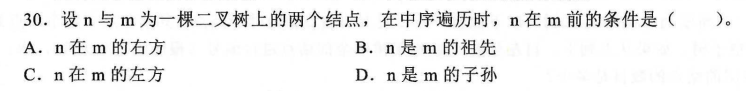
【解析】C
【习题】

【解析】C,要交换所有分支结点左、右子树的位置,可以递归地进行如下的操作:先递归交换左子树中的所有分支结点,再递归地交换右子树中的所有分支结点,最后对根结点交换其所有子树的位置
【习题】
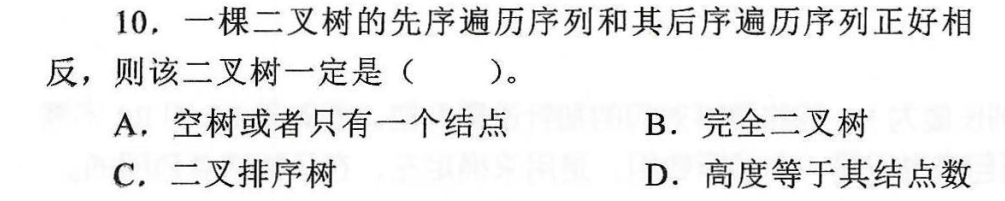
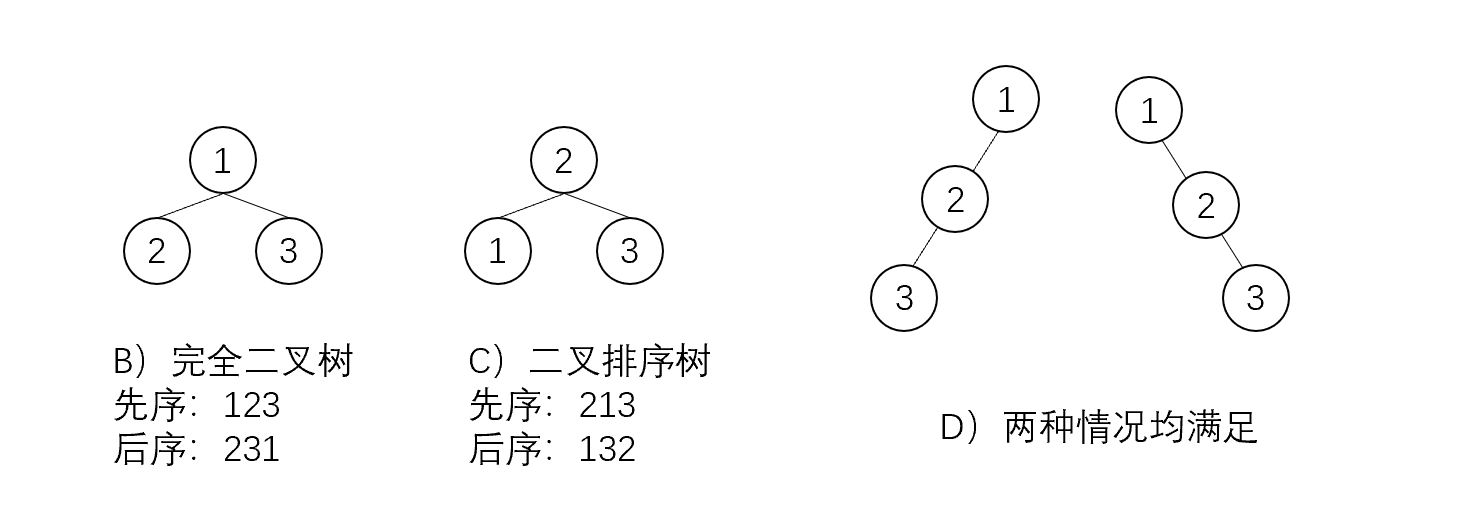
【解析】D,考虑如下几种情况
【习题】(入栈出栈和先序中序的关系)
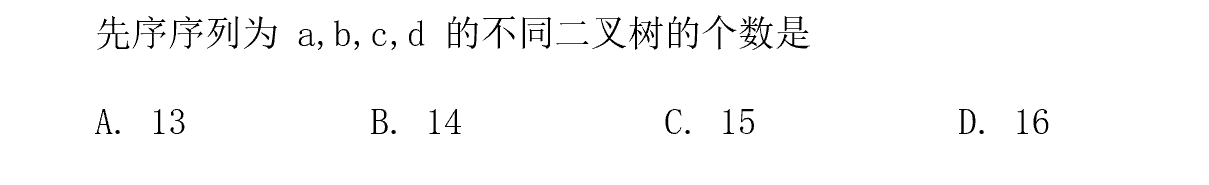
【解析】B
根据二叉树前序遍历和中序遍历的递归算法中递归栈的工作状态变化得出:前序序列和中序序列的关系相当于以前序序列为入栈次序,以中序序列为出栈次序,因此前序序列和中序序列可以唯一的确定一棵二叉树
于是,题目的意思相当于以给定序列 a b c d 为入栈序列,则出栈序列的个数为多少,对于n 个不同元素进栈,出栈序列的个数为
$$
\frac{1}{n+1}C_{2n}^n
$$
【习题】
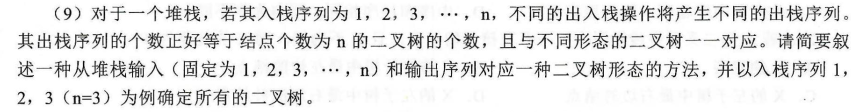
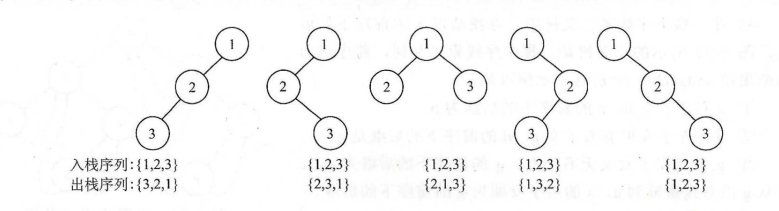
【解析】
二叉树的遍历都是递归的,便会用到栈
先序遍历相当于结点在入栈时进行打印所得的结果,中序遍历相当于结点在出栈时打印所得的结果
如此一来,这道题就清晰了,知道入栈序列和出栈序列就相当于知道了一棵二叉树的先序遍历结果和中序遍历结果,根据先序遍历和中序遍历即可以唯一地确定一棵唯一的二叉树
【习题】
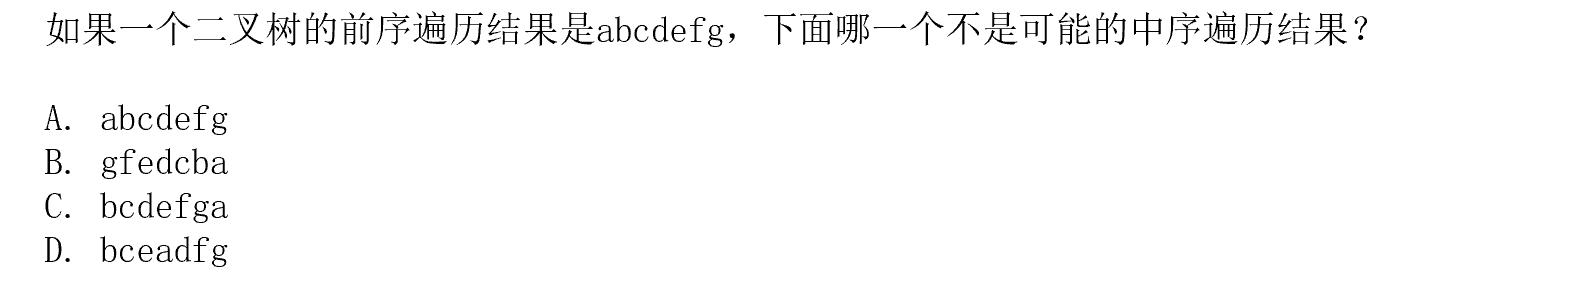
【解析】D
有两种思路:1)综合起来看是否能构成一棵二叉树;2)设abcdefg为进栈的顺序,符合出栈顺序的则可能是中序遍历的结果
这里我们选用第二种思路,很显然,在 e 出栈之后,栈内有两个元素a、d 且 d 在栈顶,故不可能得到 ad 的出栈序列
【习题】

【解析】B
【习题】

【解析】A
先说二叉树遍历的性质:
- <前,中> 可以唯一确定一棵二叉树
- <后,中> 可以唯一确定一棵二叉树
- <前,后> 是不能确定一棵二叉树
- 题中问的是根结点的孩子结点,<前,后> 是可以确定的,但是一般情况下不能确定整个二叉树。当前序关系为 X Y XYXY 而后序关系为 Y X YXYX 时,则 X XX 为 Y YY 的祖先
于是,对此题有如下分析:
- 前序遍历: a,e,b,d,c 后序遍历:b,c,d,e,a
- 由此可说明 a 是 e 的直接根结点
- 前序遍历: a,e,(b,d,c) 后序遍历:(b,c,d),e,a
- 此时把 bdc 当作整体,忽略内部顺序。由此可见 e 是 bdc 整体的双亲结点,所以 e 是 a 的唯一孩子结点
【习题】
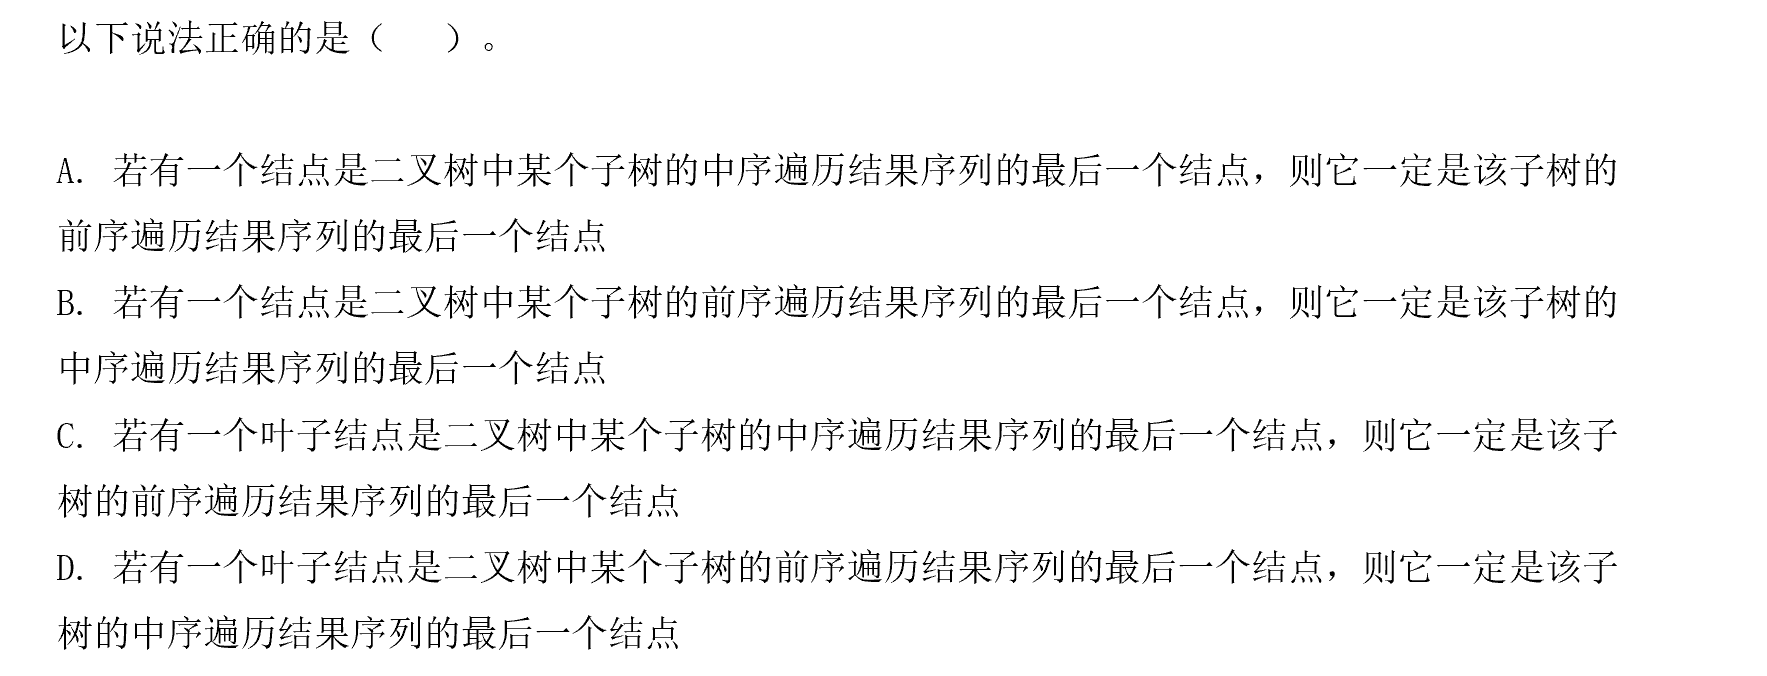
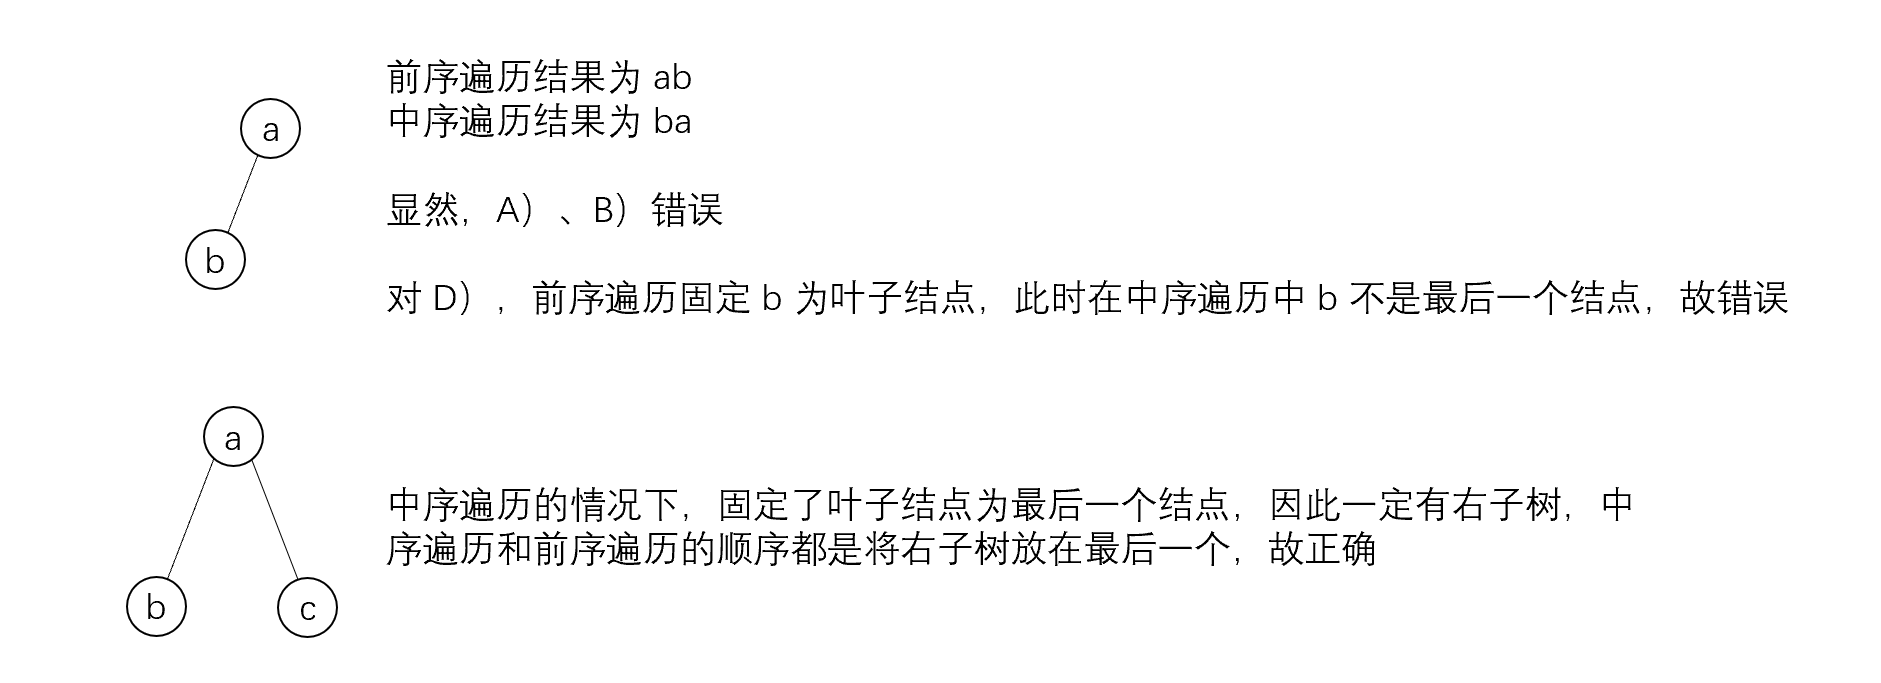
【解析】C
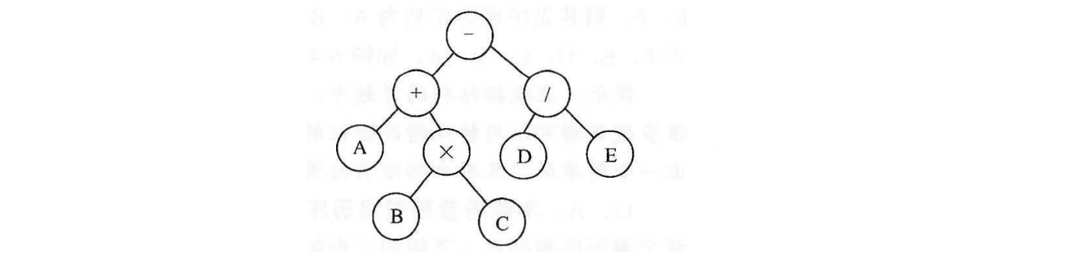
【习题】(表达式生成树)
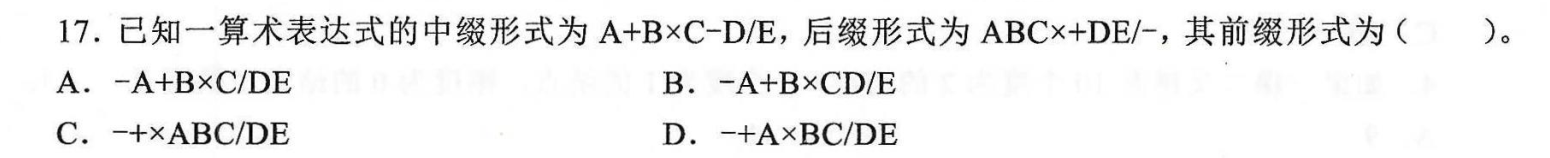
【解析】D,对应看成中序遍历结果和后续遍历结果,唯一确定一棵表达式生成树如下所示
与线索树相关的习题
【习题】
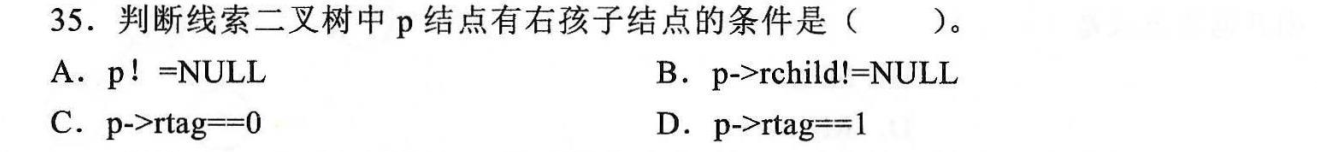
【解析】C,基础理论而已
与树的抽象计算相关的习题
【习题】
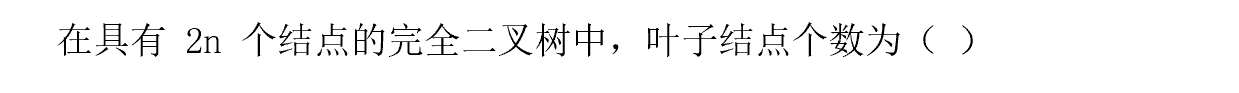
【解析】
$$
n_0+n_1+(n_0-1)=2n, 2n_0+n_1-1=2n,又n_0=1\ or\ 0,取n_0 = 1,可得n_0=n
$$
【习题】

【解析】C,完全二叉树的最少情况是最后一层只有最左边有一个叶子结点。
$$
于是,上面的 k-1 层数满二叉树节点数为2^{(k-1)}-1,因此完全二叉树的节点数是 2^{(k-1)}-1+1=2^{(k-1)}
$$
【习题】

【解析】A,即满二叉树
【习题】

【解析】根据完全二叉树的性质,第 7 层最多能容26 = 64 个结点。而根据题意,第7层有10个叶子结点
① 结点最少的情况:第 7 层仅有10个结点(即全部为叶子结点),前 6 层共有 26-1 = 63 个结点,加上第 7 层的 10 个叶子结点,就是 73 个结点,即题中描述的二叉树最少有73个结点
② 结点最多的情况:第 7 层有 64 个结点,其中前 54 个结点有孩子结点,剩下的 10 个结点为叶子结点,于是,前 7 层总计结点数为 27-1 = 127个结点,第八层有 54×2=108 个结点,两者相加为 235 个结点,即题中描述的二叉树最多有235个结点
【习题】
【解析】
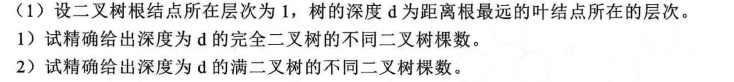
(1)二叉树的第d层最多有 2^{d-1}个结点,故深度为 d 的不同的完全二叉树有 2^{d-1}棵(每多一个叶子结点即是一颗不同的完全二叉树)
(2)深度为d的满二叉树就只有一棵
【习题】

【解析】C,当每层只有一个结点是我们能得到最大高度,即 h=1025;当这颗二叉树是满二叉树时高度最小,即
$$
h=\left \lceil log_21025 \right \rceil+1=11
$$
【习题】
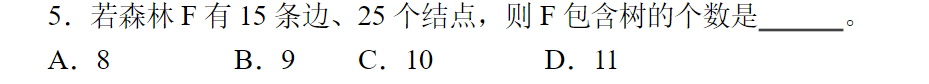
【解析】 C,考虑对一棵树而言,如果其有 n 个结点,故而有 n−1 条边。于是,设有 k 棵树,第 i 棵树有 xi个结点,于是满足以下两个关系式:
$$
\sum_{i=1}^k x_i=25\ \sum_{i=1}^k(x_i-1)=15
$$
【习题】
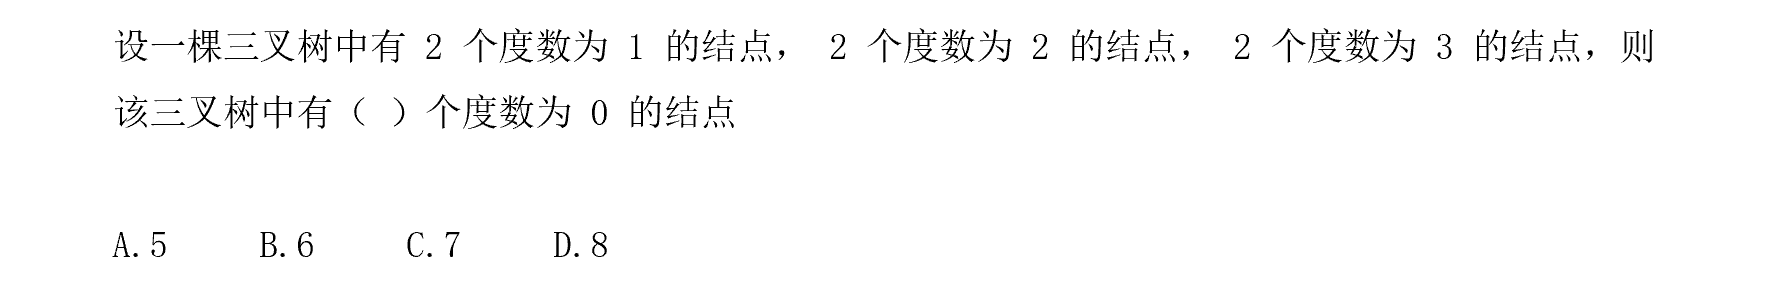
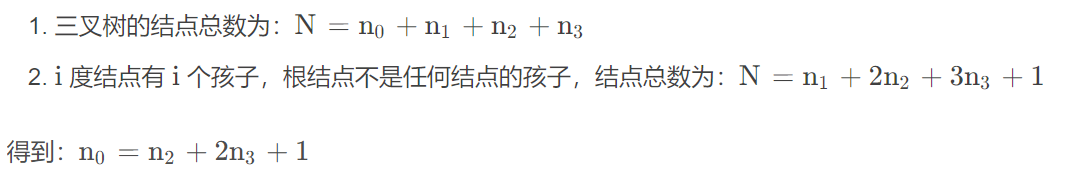
【解析】C
【习题】

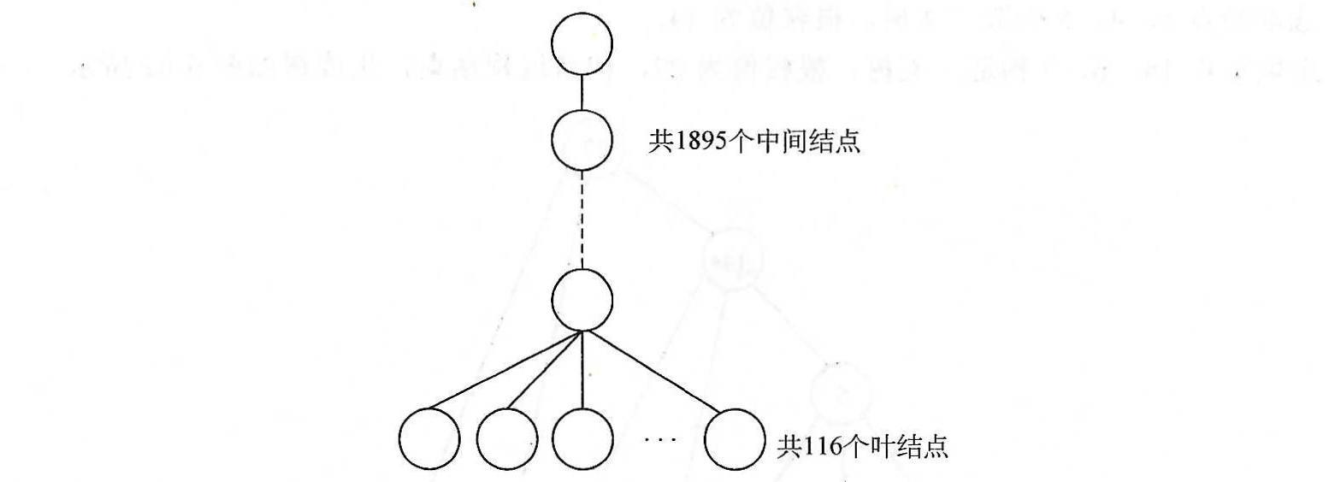
【解析】D
普通树转化为二叉树后,度为 1 的结点只有左孩子而无右孩子,考虑如下特殊情况,那么,也就是最后一层上面的 1895 个结点再加最后一个叶子结点没有右孩子
【习题】

【解析】C,取 h=1,这棵二叉树中只有一个结点
【习题】
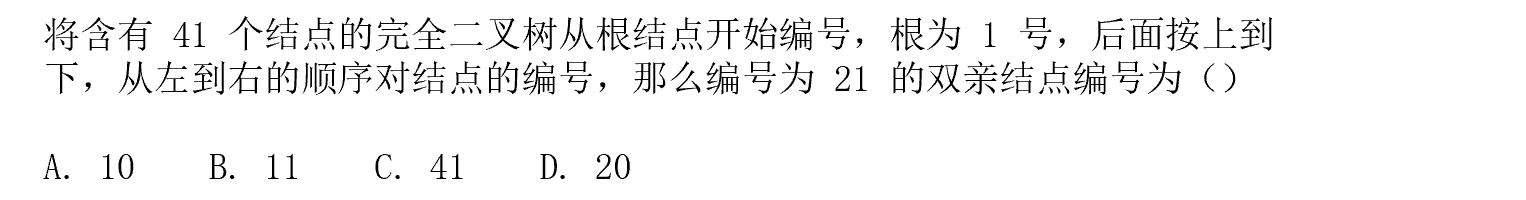
【解析】A,对完全二叉树,如果当前结点的编号哦 i ≠ 1 ,其对应的双亲编号为 ⌊i/2⌋
【习题】
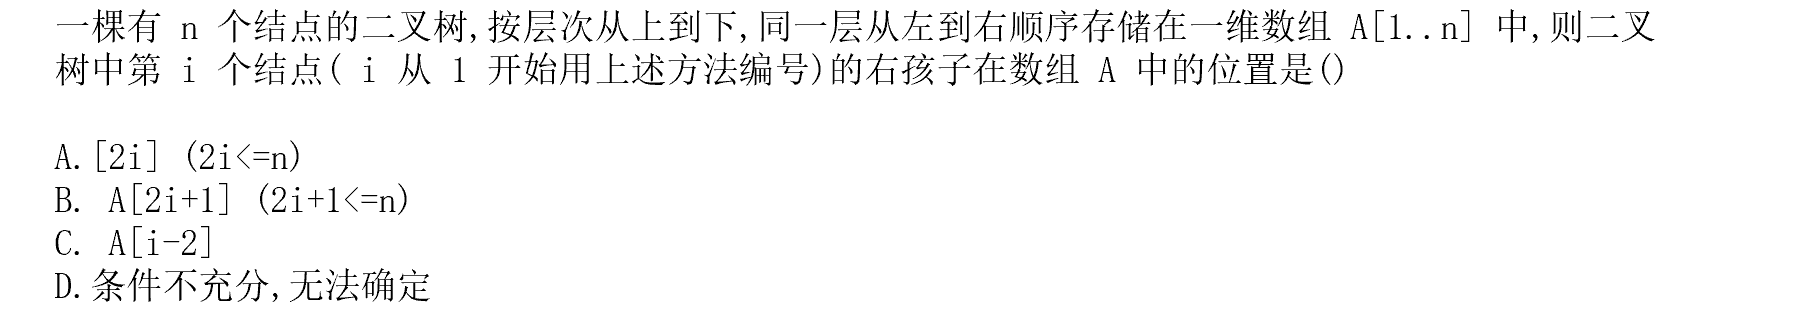
【解析】D,注意要是完全二叉树 B)选项才正确
【习题】(十分经典的树的抽象分析,可以直接背下来)
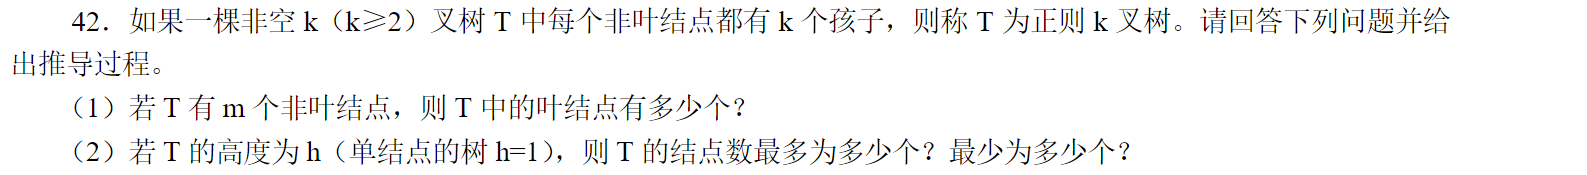
【解析】
(1)由题意可知,对正则 k 叉树,仅有度为 k 的非叶结点和叶节点。于是,设叶结点的个数为 n0,那么
$$
总结点数=n_0+m
$$
同时根据生成树定理,有
$$
总结点数=mk+1
$$
故,
$$
n_0+m=mk+1,解之得 n_0=mk-m+1
$$
(2)含结点最多的情况:除第 h 层外,第 1 层到第 h−1 层的结点的度均为 k,而第 h 层均为叶结点,此时第 i 层有 k^{i-1} 个结点,总结点数为
$$
\sum_{i=1}^hk^{i-1}=1+\cdots+k^{h-1}=\frac{k^h-1}{k-1}
$$
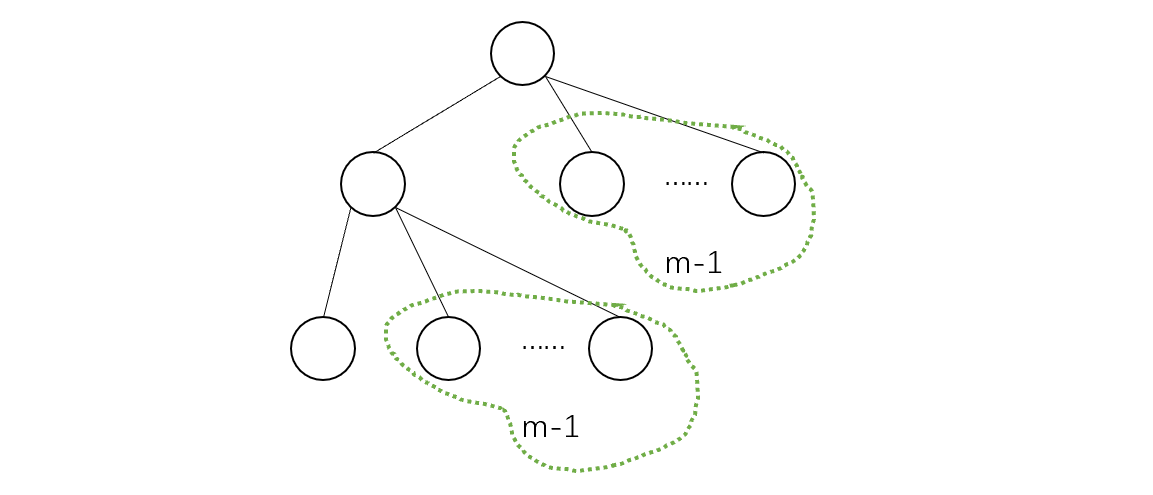
含结点最少的情况:第 1 层只有根结点,第 2 层到第 h−1 层仅含 1 个分支节点和 k−1 个叶结点,此时第 2 层到第 h 层中每层的结点数均为 k ,总结点数位 1+(h−1)k
【习题】(这抽象分析绝了)

【解析】
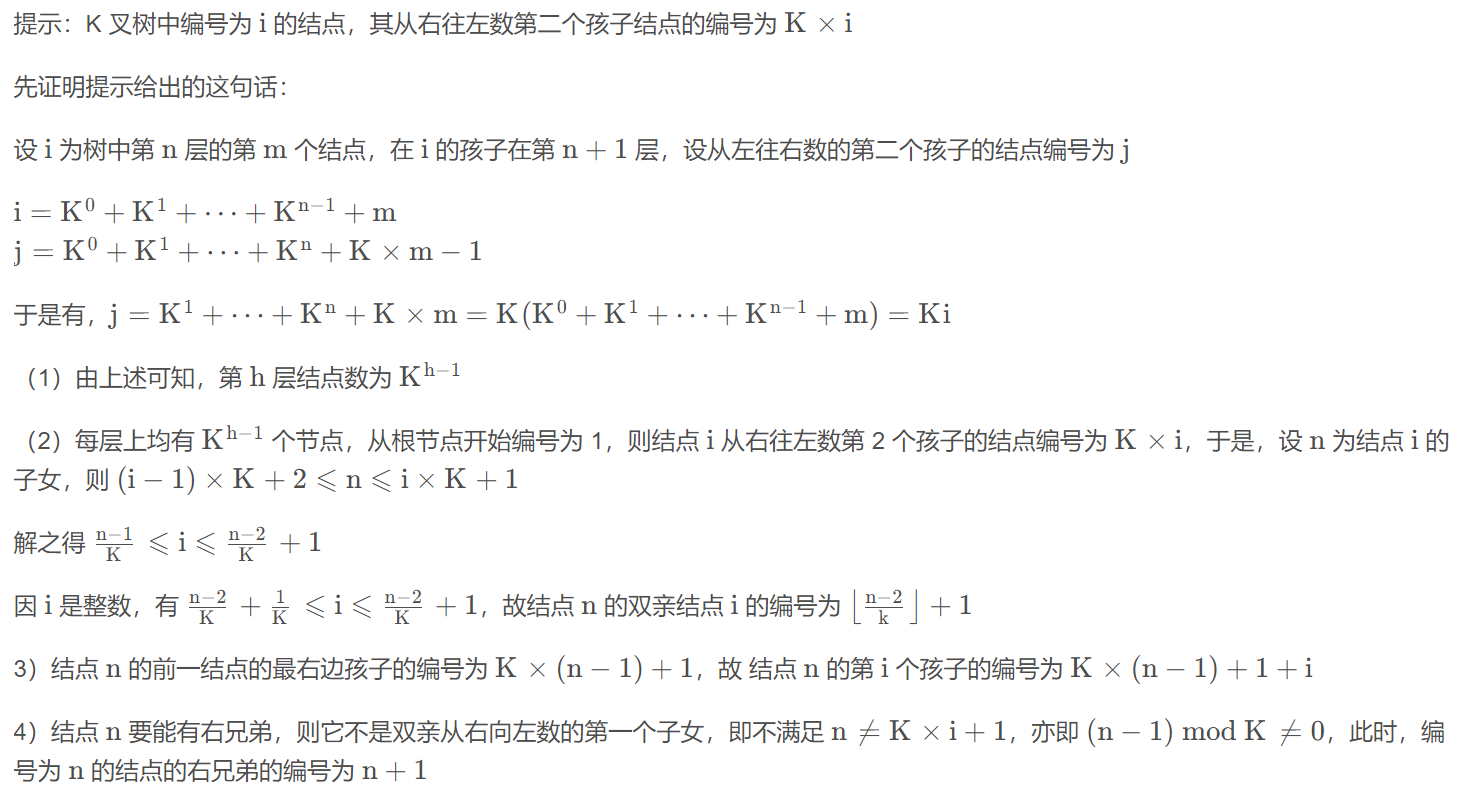
(在此题最后,要说一句很关键的话,在编程中有用到的十叉树,不是真正的一个结点带十个指针,而是如此题形式一般的通过理论分析给出结点之间编号上的关系,依次完成其他的逻辑操作)
与森林相关的习题
【习题】
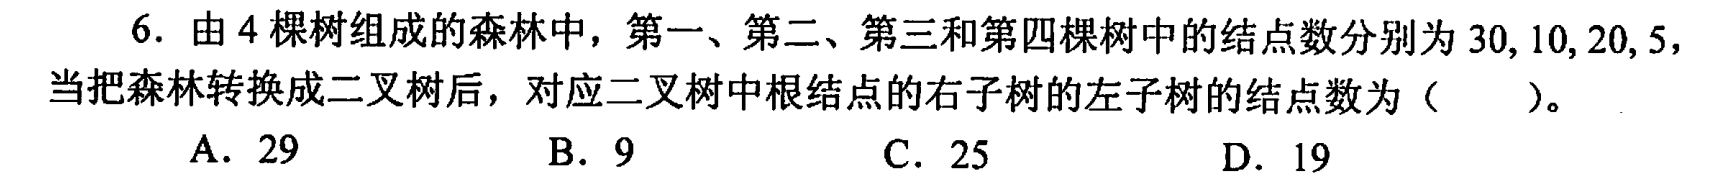
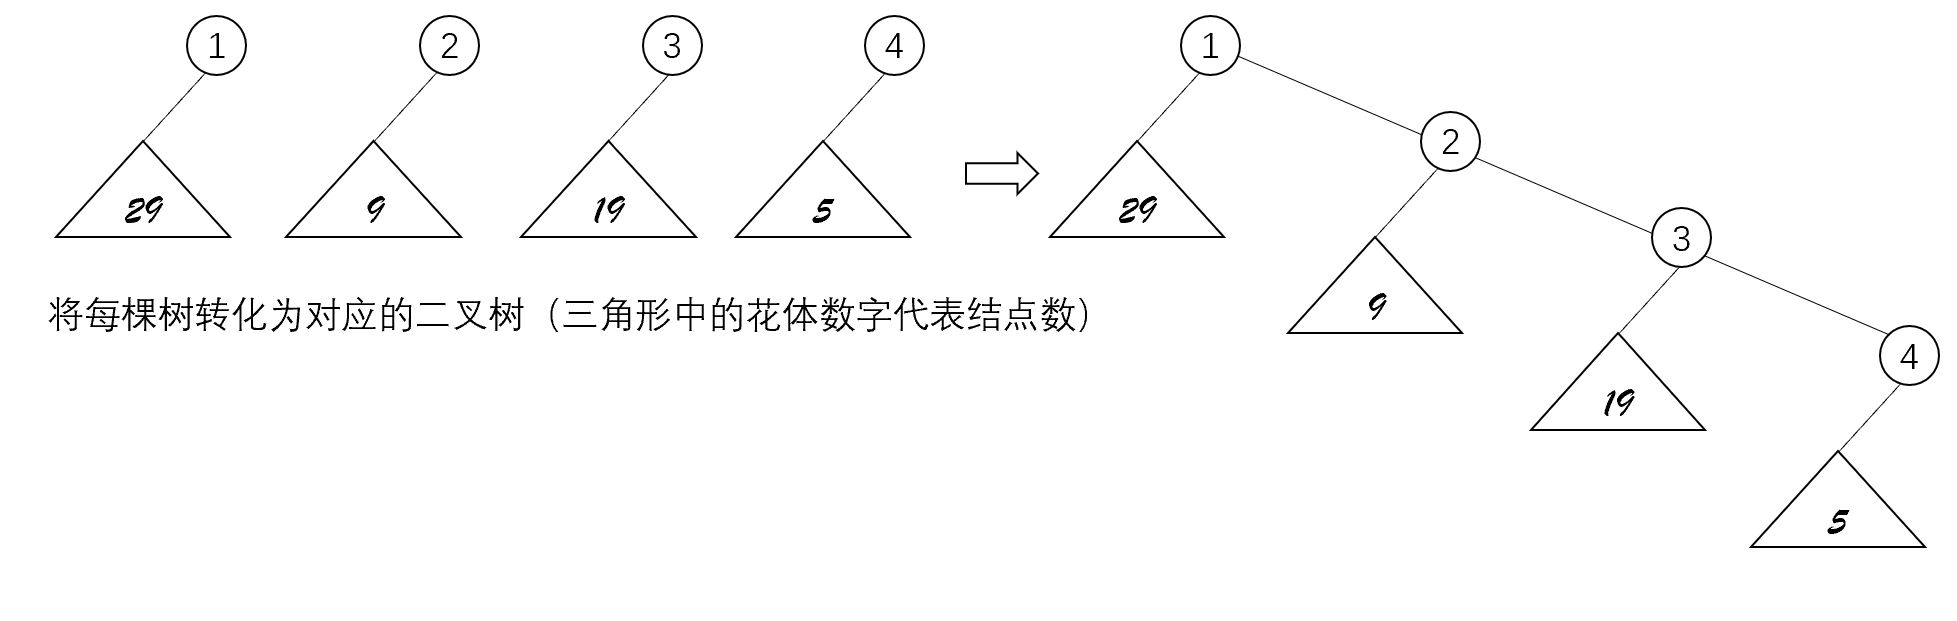
【解析】B,具体分析如下
【习题】
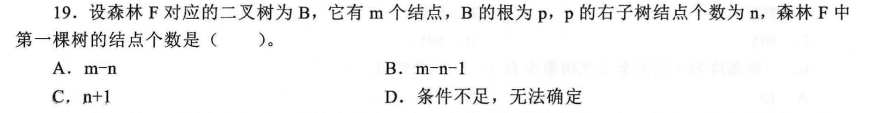
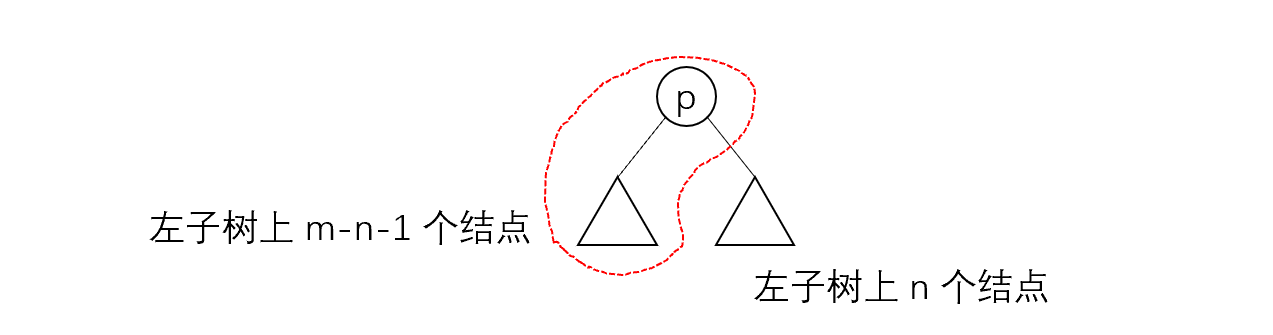
【解析】A,根结点 p 属于第一棵树的结点
【习题】
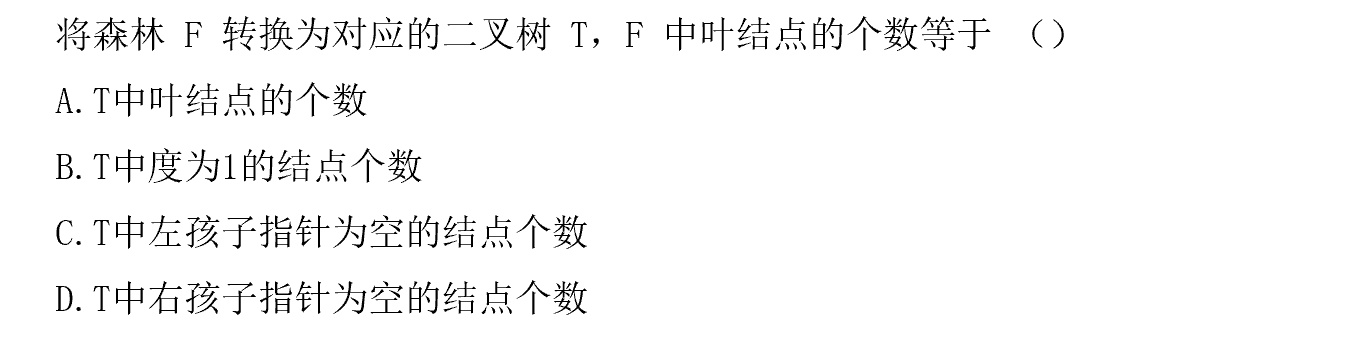
【解析】C,分析如下

【习题】
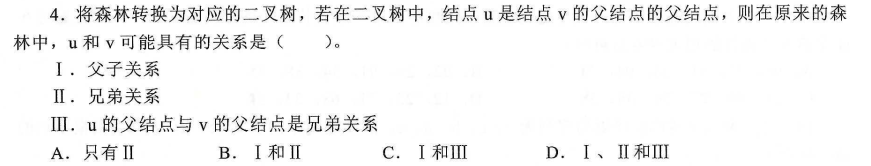
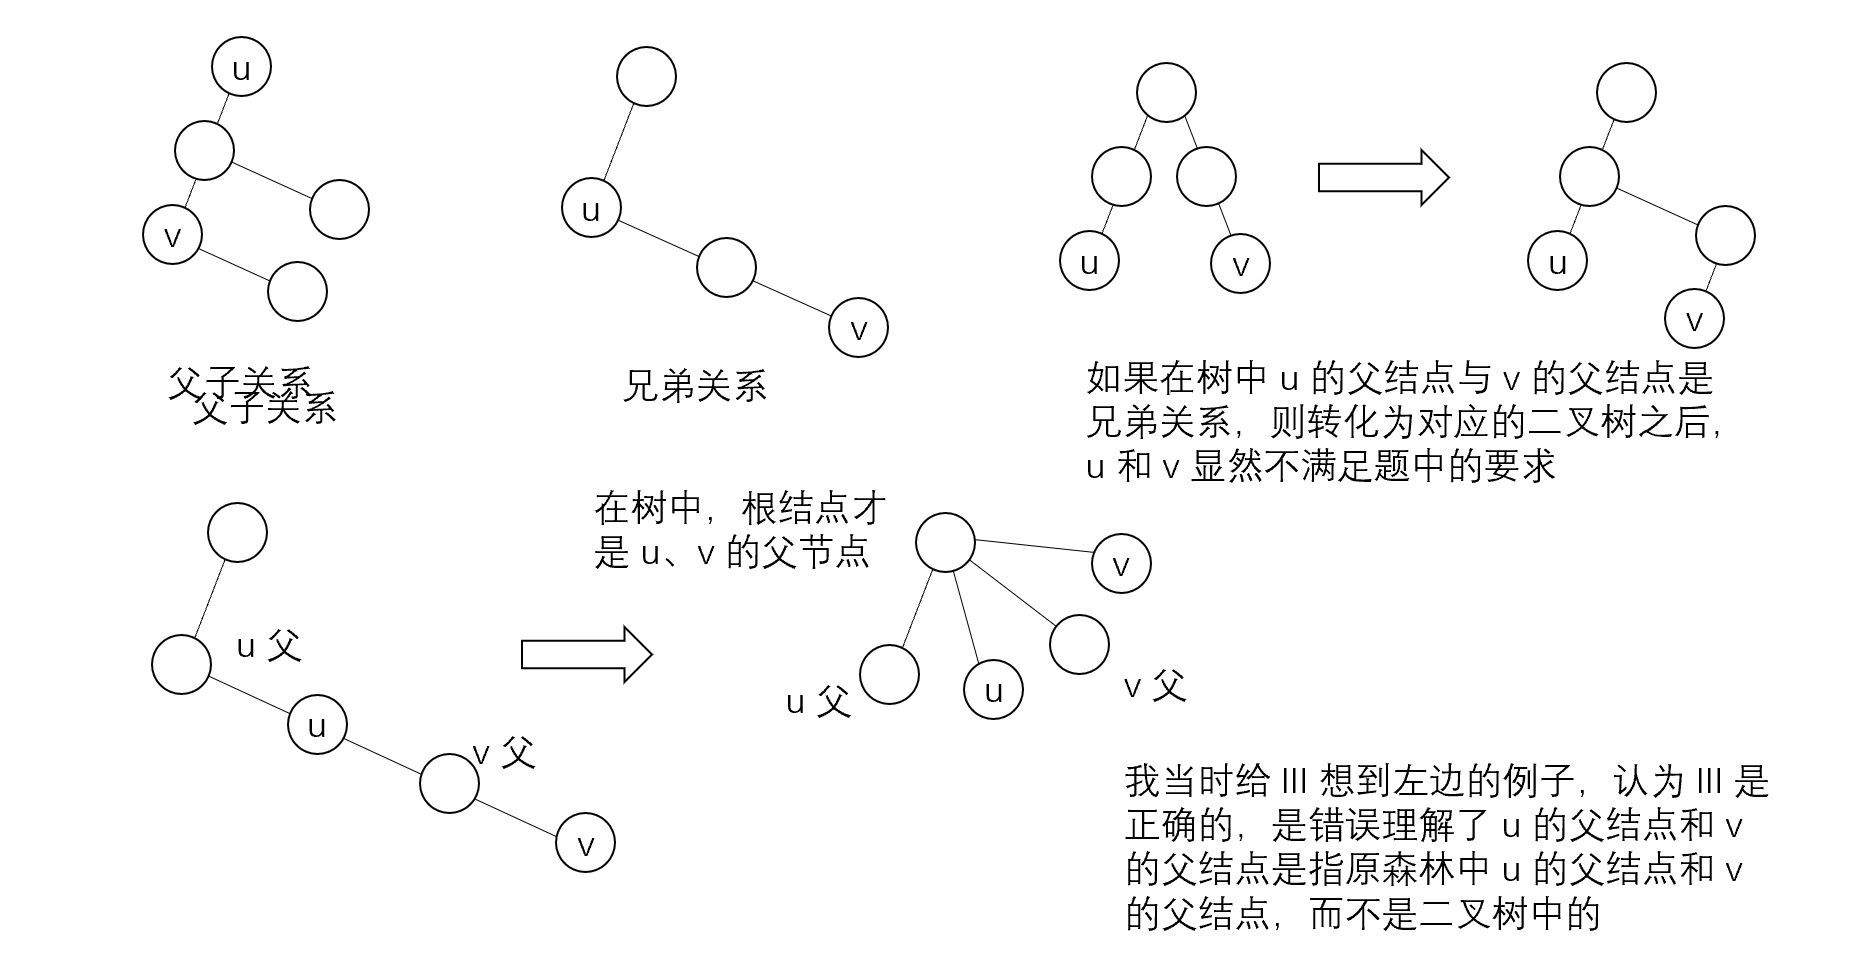
【解析】B,分析如下
与哈夫曼树相关的习题
【习题】

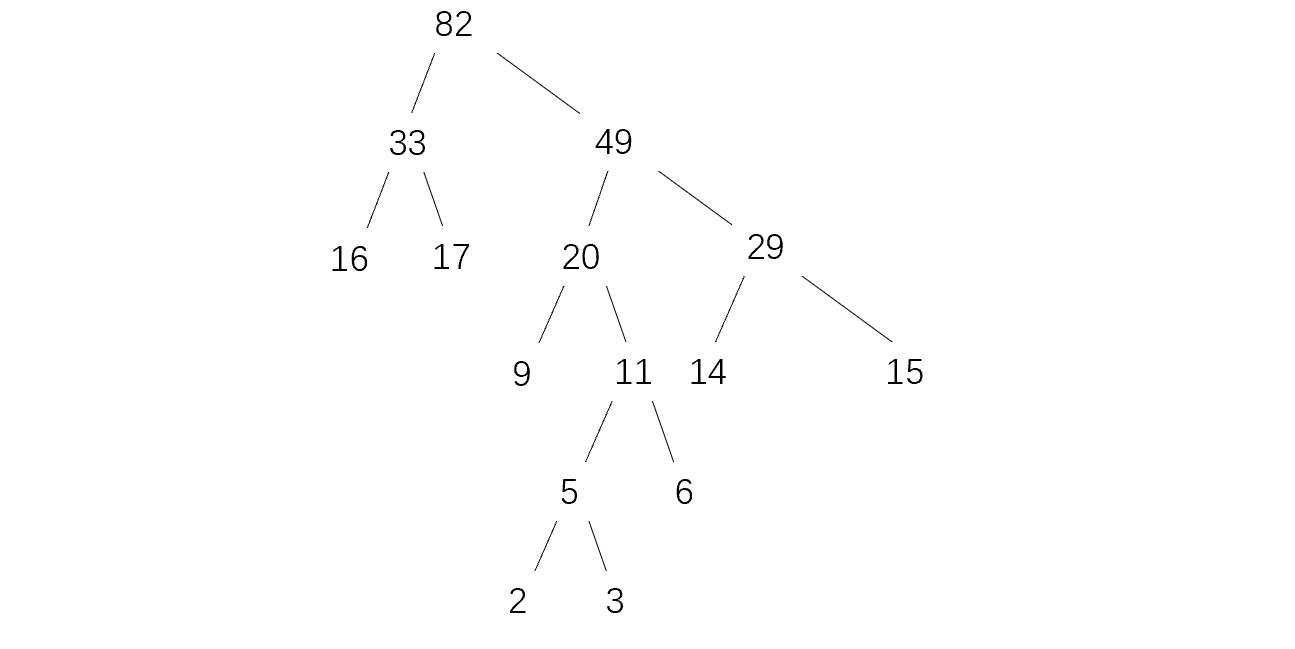
【解析】构造的哈夫曼树如下所示,带权路径长为 229
【习题】
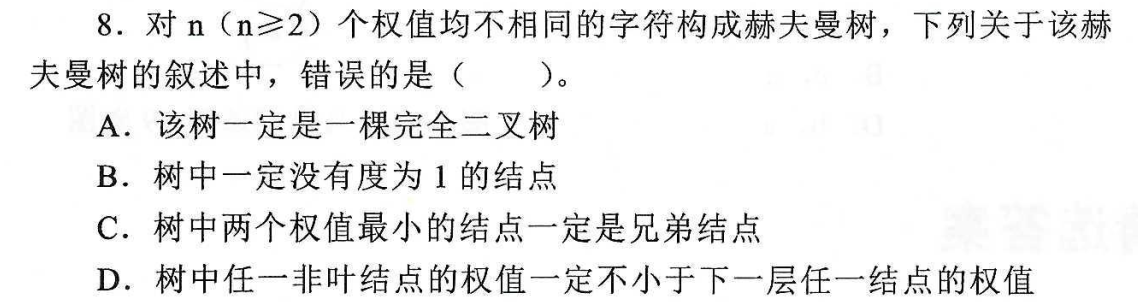
【解析】A,哈夫曼树不一定是完全二叉树,C)选项注意题目中给定权值均不相同
【习题】(强调哈夫曼树左右子树可以对调)
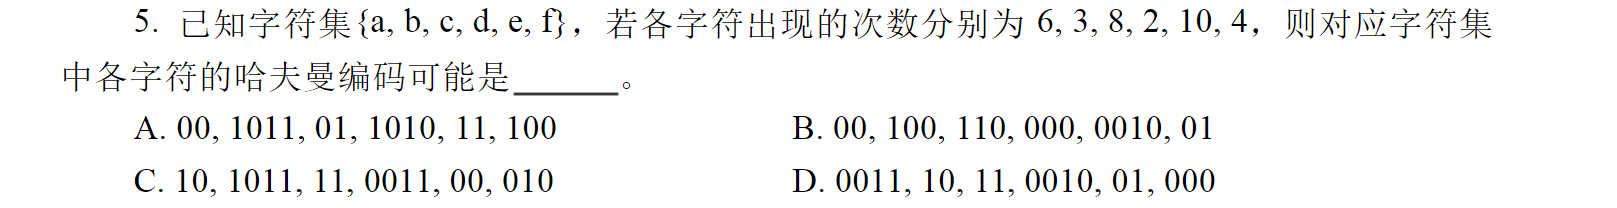
【解析】A
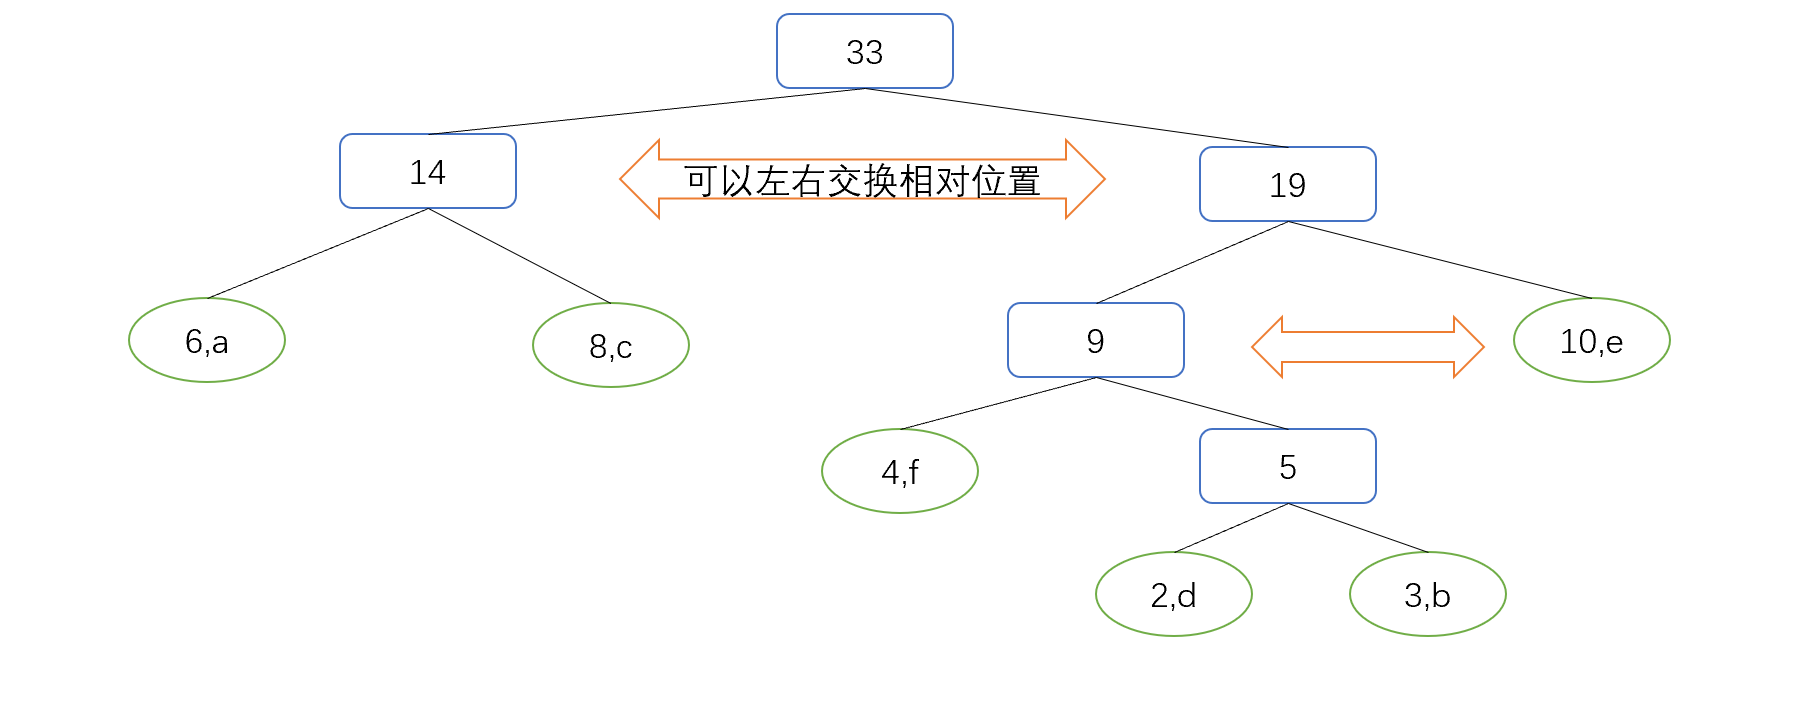
即便是题目中给出的一组权值都互不相同,且构造过程中产生的二叉树根权值也是互不相同的,照样能构造出不同的哈夫曼树和哈夫曼编码,此时只需要调换一下左右子树的位置即可,如上图所示
【习题】(从哈夫曼编码构造哈夫曼树)
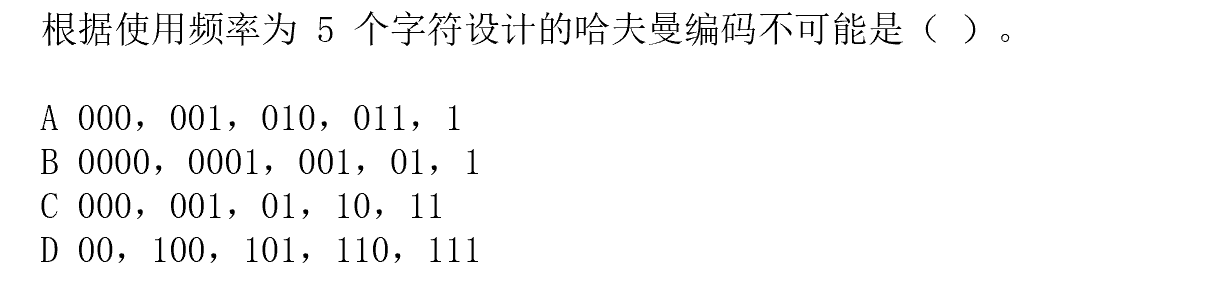
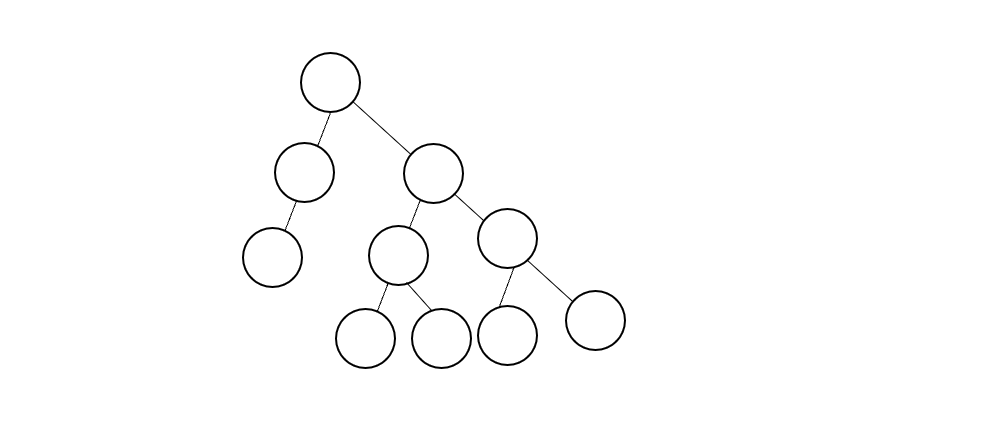
【解析】D,哈夫曼树的结点要么是叶子节点,要么是度为2的节点,不可能出现度为1的节点
【习题】(从路径构造哈夫曼树)
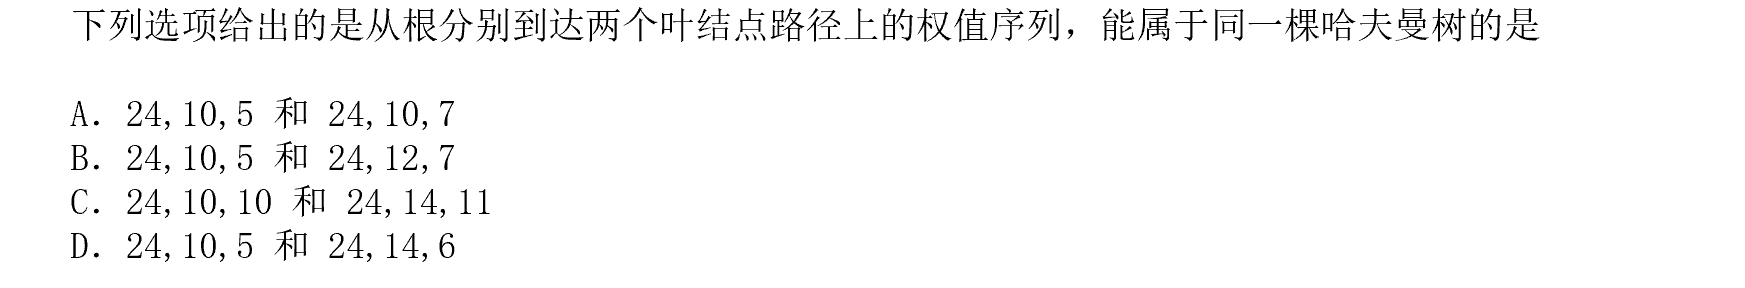
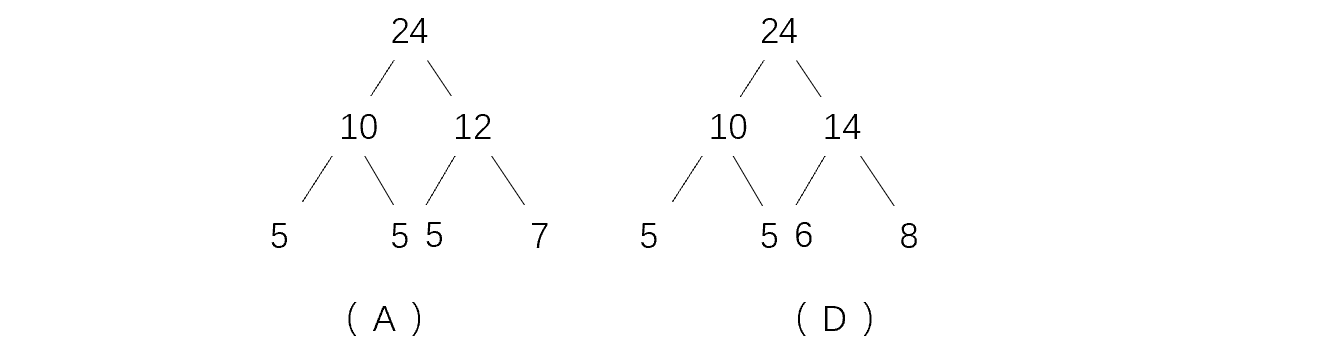
【解析】D,只有 D)选项能成功构造哈夫曼树,我们以 A)为反例,可以看出 24—10—7 是不存在的
【习题】
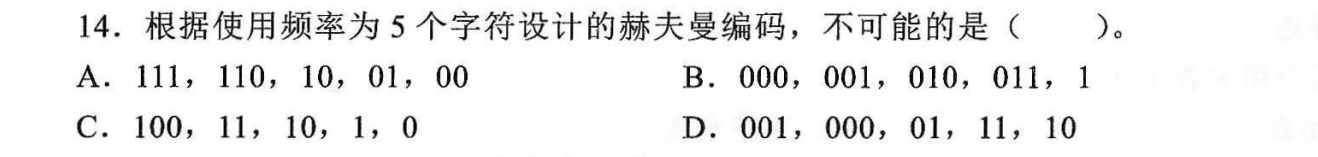
【解析】C,哈夫曼编码为前缀码,即编码中任何一个序列都不是另一个序列的前缀
【习题】(哈夫曼树合并过程的计算)
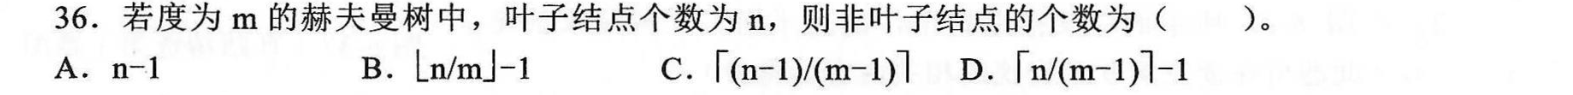
【解析】C,在构造 m 哈夫曼树的过程中,从结点集中选出m个叶子结点合并为一个父结点,每次合并结点集减少m−1 个结点,从 n 个叶子结点减少到最后结点集中只剩一个根结点共需要⌈(n−1)/(m−1)⌉,此过程中每次合并增加一个非叶子结点。
【习题】

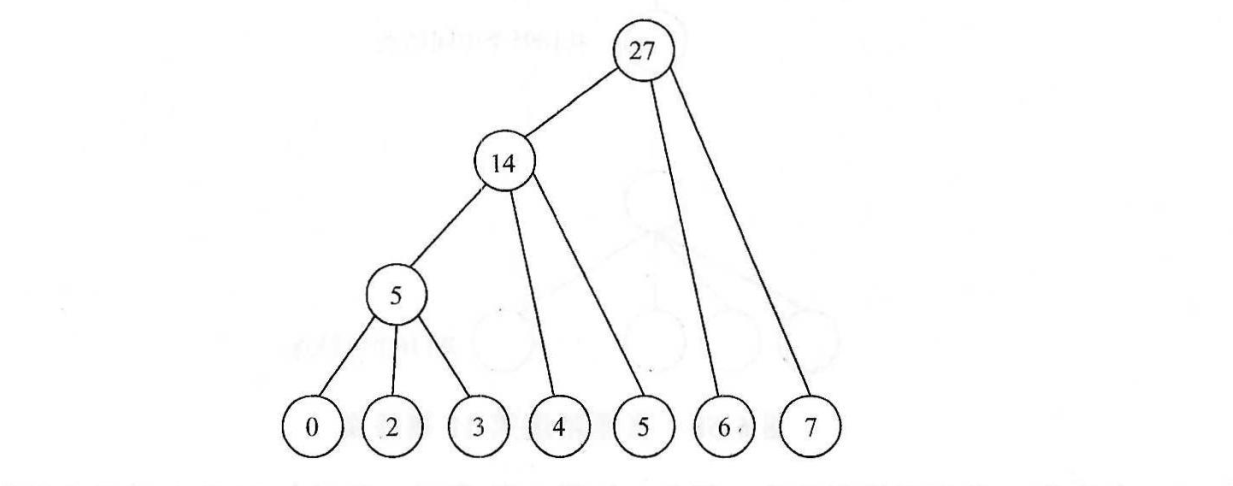
【解析】B,对于结点数大于等于 2 的待处理序列都可以构造哈夫曼二叉树,但是不一定能构成哈夫曼 n 叉树。当发现无法构造时,需要补上权值为 0 的结点。故补上权值为 0 的结点后,本题序列构造出的哈夫曼 3 叉数为
【习题】(符号和哈夫曼树叶结点的关系)

【解析】C,
$$
n_0+n_2 = 115,n_0=n_2+1 ,解之得n_0=58,n_2=57,故n=58
$$
